
언어 모델은 어떻게 책을 한 번에 이해할 수 있을까?
안녕하세요, 에디터 배니입니다.
지난 목요일, Meta의 오픈 소스 언어 모델 Llama 3가 공개됐습니다. 지난해 7월, Llama 2가 공개된 지 9개월만인데요. 이번에 공개된 모델은 Llama 3 8B와 70B 모델입니다. 누구나 상업적으로 사용이 가능한 만큼 기업과 연구 기관에서 관심을 보이고 있는데요. 모델의 크기가 (상대적으로) 이제 크지 않은 만큼 개인도 활용할 수 있다는 점에서 매력적입니다.
그러나 오늘 전해드릴 소식은 Llama 3가 아닙니다. 블로그로 모델에 관한 설명이 공개되기는 했지만, 관련 논문이나 기술 보고서가 공개되지 않았습니다. Llama 3와 관련된 내용은 조금 더 많은 이야기를 정리하여 다음주에 더 자세하게 전해드리도록 하겠습니다.
사실, 올해 Llama 이전에도 주목할 만한 언어 모델들이 등장해왔는데요. 기업들의 언어 모델 진검 승부가 다시 시작된 듯합니다. 지난 2월에는 Google의 Gemini 1.5가 출시됐고, 3월에는 Anthropic의 Claude 3.0이 공개됐습니다. 게다가 곧 GPT-5의 출시할 것이라는 루머까지 나오고 있습니다.
이미 GPT-4의 뛰어난 성능으로 사용자들의 눈은 높아졌기에 새로운 모델들이 과연 이를 뒤집을 수 있을까 의문이 듭니다. 하지만 후발 주자들의 차별화된 전략을 통해 입소문을 타며 사용자들 사이에서는 ‘어떨 때는 이 모델이 좋다’는 말도 나오고 있습니다. 그야말로 언어 모델 춘추전국시대입니다. 아마 이 흐름은 당분간 지속될 것으로 보입니다.
분명 오랫동안 언어 모델 논문들을 읽어왔었는데도 발전 속도가 너무 빨라서 지식에 공백을 느껴집니다. 그래서 그런지 최근 등장하는 언어 모델에 많은 의문이 듭니다. 그중 하나는 이것입니다.
언어 모델은 어떻게 긴 텍스트를 이해할 수 있게 됐을까?
Transformer는 파라미터 수에 비례해 성능이 향상된다는 특징을 가지고 있습니다. 그래서 기업들은 언어 모델의 성능을 높이기 위해 모델의 크기를 키웠습니다. 실제로 언어 모델이 뛰어난 성능을 보이자, 가벼운 모델에서도 그 성능을 달성할 수 있는 방법과 그 모델들을 어떻게 활용할 수 있는 방법들을 고심하며 연구했습니다.
모델의 크기를 키우면 여러 대의 GPU를 활용해 병렬적으로 처리하는 시스템을 만들면 됩니다. (물론, 말처럼 쉬운 일은 아닙니다.) 하지만 한 대의 GPU가 한 번에 처리할 수 있는 연산량에는 여전히 한계가 있습니다. 즉, 모델의 파라미터를 늘리는 것과 별개로 학습 시 입력 토큰의 길이를 늘리는 것은 제한적일 수밖에 없습니다.
게다가 Attention 매커니즘 특성상 입력 토큰 길이의 제곱으로 연산량이 늘어나게 됩니다. 입력 토큰의 개수가 2배만 늘어나도 연산량은 4배가 늘어납니다. 이 때문에 BERT는 512(2^9)개의 입력 토큰을 활용했고, 이후에 BERT를 기반으로 더 긴 *컨텍스트를 이해할 수 있는 모델(LongFormer, BigBird) 역시, 4096(2^12)개로 늘리는 것이 한계였습니다.
그런데 현재 언어 모델들은 10만 토큰, 심지어는 100만 토큰이 넘는 프롬프트를 입력값으로 받을 수 있다고 합니다. 몇 년 사이 GPU 성능이 좋아졌다고 해도 갑자기 수백 배의 토큰을 처리할 정도로 늘어나지는 않았습니다. 그럼 기업들은 어떻게 컨텍스트 윈도우의 크기를 늘릴 수 있었는지, 그 방법을 한 번 알아보도록 하겠습니다.
미리보기: 언어 모델이 긴 텍스트를 이해하는 5가지 방법
긴 텍스트를 처리하는 방법을 설명하기에 앞서, 긴 텍스트를 한 번에 이해하면 어떤 장점이 있을까요? 만약 200페이지 분량의 책을 하나의 프롬프트로 입력하고 모델이 그 정보를 제대로 이해하고 있다면, 책과 관련해 어떤 정보를 질문하더라도 알아서 답변할 수 있습니다. 공부할 때 전공책의 본문 내용을 입력하면 나만의 과외 선생님을 만들 수도 있습니다. 챗봇이라면 대화가 길어지더라도 이전에 나눴던 대화 내용을 이해하고 답변할 수도 있죠.
이렇게 긴 컨텍스트를 한 번에 살펴볼 수 있다면 LLM을 활용할 수 있는 범주가 한층 넓어집니다. 때문에 기업과 연구 기관은 긴 텍스트를 모델이 이해할 수 있도록 다양한 방법으로 연구했는데요. Beyond the Limits: A Survey of Techniques to Extend the Context Length in Large Language Models 논문에서는 그 방법을 크게 다섯 가지로 구분합니다.
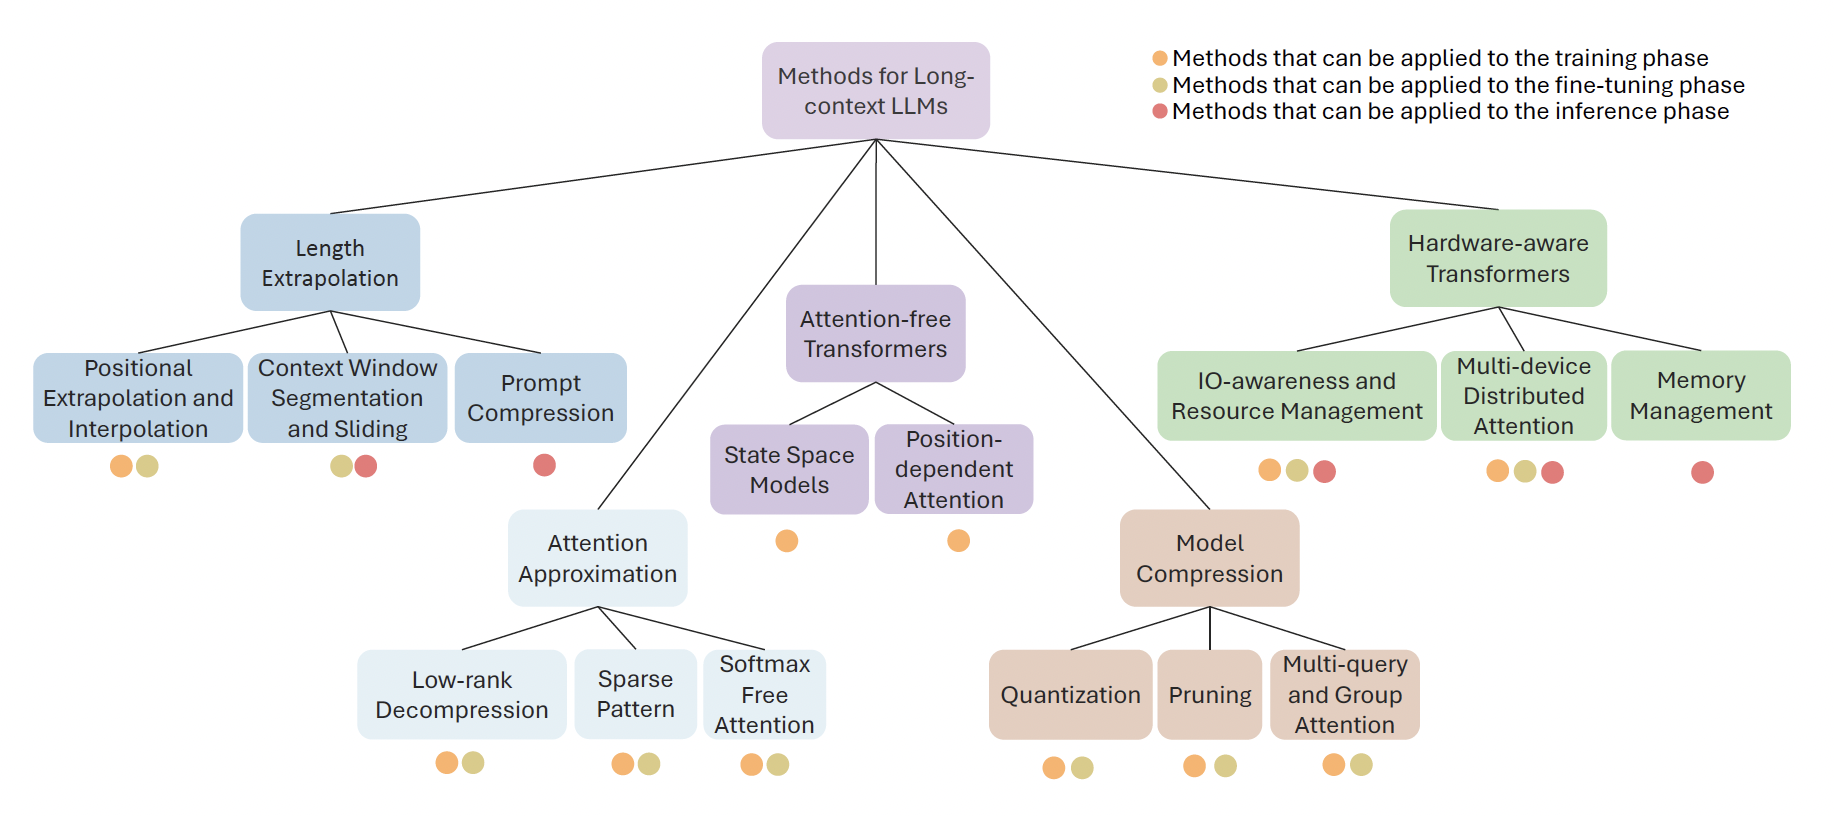
하나의 모델에서 한 가지 방법론만 활용되는 것은 아닙니다. 최근에는 여러 방법론을 결합해 활용함으로써 훨씬 최적화된 방법으로 긴 컨텍스트 문제를 해소하는 것이 일반적입니다. 일례로, Llama 2의 경우에도 긴 컨텍스트를 이해하는 데 유리한 위치 임베딩 방법(RoPE)과, GQA(Grouped-query Attention)을 함께 활용했습니다. 이번 뉴스레터에서는 그중 대표적인 희소 패턴 전략과 위치 임베딩 방법론을 중심으로 살펴보겠습니다.
1. Sparse Attention
2018년, 언어 모델 BERT가 등장 이후 Attention의 연산량을 줄이기 위한 방법으로 주목 받았던 방법은 바로 Self-Attention 행렬의 일부만 계산하는 것입니다. 대표적인 연구가 LongFormer입니다. LongFormer의 경우, 4096개의 토큰을 한 번에 처리할 수 있는데요. 이는 책으로 치면 8쪽 가까이 되는 분량입니다. 이렇듯 입력 텍스트가 길어질수록 관련 없는 정보들이 하나의 입력 내 포함될 가능성이 높습니다. LongFormer의 전략은 낮은 관계성을 갖는 정보의 계산은 생략하고, 대신에 관계성이 높을 것으로 예상되는 정보를 중심으로 Attention 연산을 수행합니다. 그렇다면 어떤 토큰 간에 관계성이 높을까요?
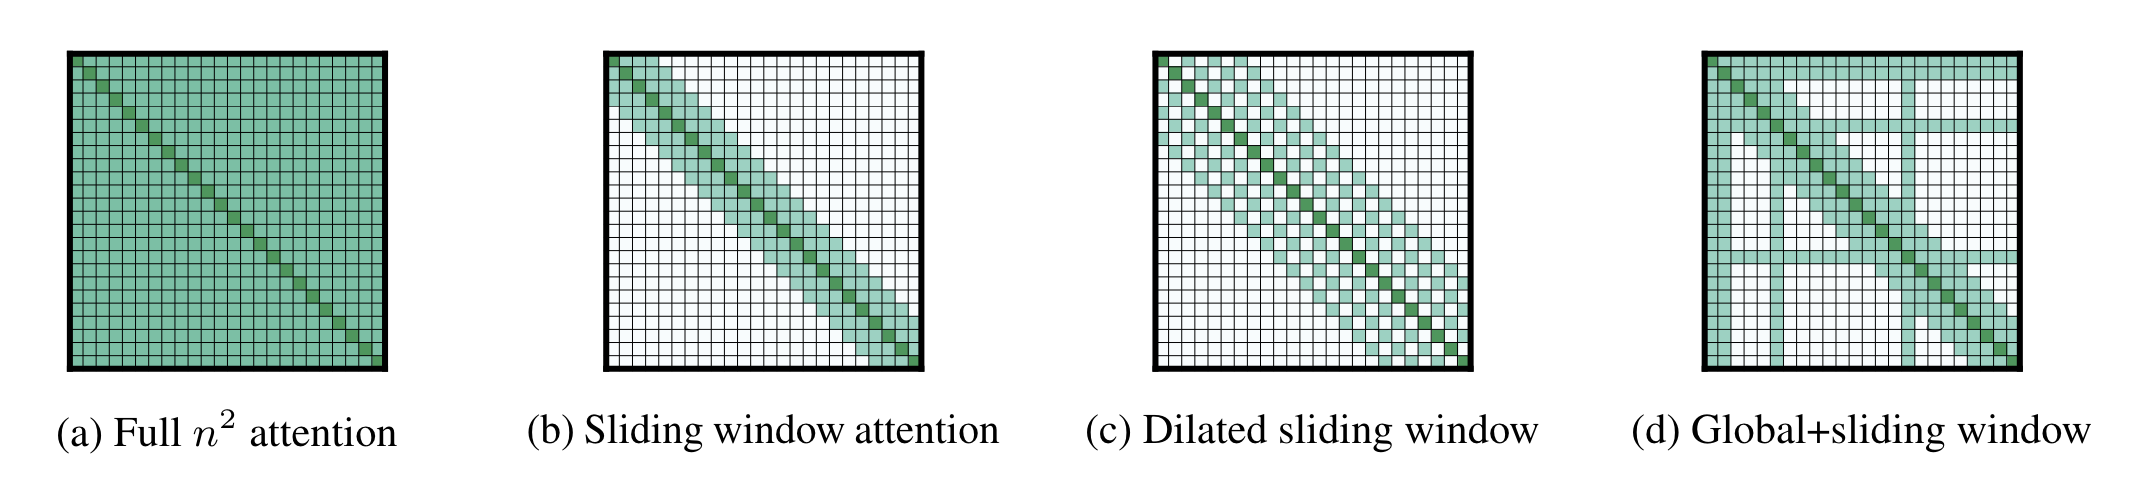
연구진은 언어의 기본적인 특성과 언어 모델의 목표를 고려했습니다. 기본적으로 어떤 단어와 가깝게 위치한 단어는 멀리 떨어진 단어보다 서로 관련성이 높을 것입니다. 이와 같은 특성은 과거 단어 임베딩(Word Embeddings) 모델을 학습할 때부터 줄곧 활용되었는데요. 특정 토큰이 좌우로 2개의 단어만 볼 수 있게 관찰할 수 있는 범위를 좁히면 연산량을 대폭 줄일 수 있습니다.
그리고 당시 언어 모델을 학습하는 목적은 텍스트 분류나, 개체명 인식, QA 등 세부적인 태스크를 수행하는 데 있었습니다. 이때 일부 토큰을 특정한 목적을 가진 특수 토큰(Special Token)으로 대체하는데요. 이런 토큰의 경우에는 전체 토큰의 정보를 반영하는 것이 학습하는 데 도움이 됩니다. 이를 위해, 특수 토큰은 모든 토큰과 Attention 연산을 수행합니다.
이렇게 전체적으로 슬라이딩 윈도우(Sliding Window)를 기반으로 한 Local Attention과 일부 특수 토큰을 대상으로 Global Attention을 적용한 것입니다. 입력 토큰 길이(n)의 제곱에 비례(O(n^2))하던 Attention의 계산 복잡도를 선형적(O(n))으로 줄였습니다.
하지만 이는 최근 언어 모델의 학습 방법론과 크게 맞지 않습니다. 이제는 빈칸 추론(Masked Language Modeling)이나 특수 토큰을 활용한 하위 태스크를 문제를 해결하지 않고, 주로 다음 토큰을 예측하는 자기회귀적(Auto Regressive) 방식으로 많은 문제들을 해결합니다. 또한 몇 년 사이 하드웨어 성능이 개선되면서 4096개 정도의 토큰은 버겁지 않은 수준에 이르렀습니다. 이후 더 긴 텍스트를 이해하기 위한 다양한 방법론이 제시되는데요. BERT가 주류였던 당시에는 그 중요성을 제대로 알지 못했던 위치 임베딩 방법론이 부상하기 시작했습니다.
2. Positional Embeddings
긴 텍스트가 입력으로 들어올 때 연산량 외에도 고려해야 할 문제가 있습니다. 바로, 토큰 간 관계가 제대로 학습되지 않는 문제입니다. Self-Attention의 특징은 입력된 모든 토큰 간의 관계, 다시 말해 Attention Score를 계산한다는 점입니다. 텍스트가 짧은 경우에는 이 특징이 장점이 됩니다. 입력된 프롬프트 내 문장 간 거리가 멀더라도 직접적으로 토큰 간 관계에 관한 연산이 가능하기 때문입니다.
하지만 텍스트가 훨씬 길어질수록 거리가 먼 문장들간의 관계의 중요도는 떨어지게 됩니다. 직관적으로 생각해봐도 200쪽 차리 책 한 권 내에서 37쪽의 한 문장과 185쪽의 한 문장이 어떤 관계를 갖고 있다고 보기는 어렵습니다. 이 경우에는 입력 프롬프트를 하나의 컨텍스트로 이해하되, 토큰 간 거리에 따라 Attention Score를 다르게 계산하는 것이 합리적으로 보입니다. 거리가 가까울수록 높은 관계성을, 멀수록 낮은 관계성이 반영되도록 말이죠.
이렇게 토큰의 거리와 위치 정보를 Attention 연산 과정에 반영하는 방법이 위치 임베딩(Positional Embeddings; PE)입니다. 위치 임베딩은 크게 두 가지 방식으로 구분하는데요. 어떤 토큰이 전체 프롬프트 내에서 몇 번째로 등장하는지에 따른 정보를 반영하는 것을 절대적 위치 임베딩(Abosolute PE)이라 하고, 특정 토큰과 상대적인 거리에 따라 그 정도를 반영하는 것을 상대적 위치 임베딩(Relative PE)입니다.
만약 모델이 학습한 최대 토큰 길이 내에서 프롬프트가 입력되면 위치 임베딩이 크게 문제 되지 않습니다. 이미 학습 과정에서 거리에 따른 관계 정보를 함께 반영했기 때문입니다. 하지만 최대 토큰 길이보다 긴 문장이 입력됐을 때는 곤란해집니다. 모델은 지금까지 그 위치의 정보에 대해 학습한 적이 없기 때문입니다. 물론, 그 거리가 멀지 않다면 큰 차이는 없겠지만 길이가 길어질수록 생성된 정보에 왜곡이 발생할 가능성이 높습니다.
이에 대한 해결책은 크게 두 가지입니다. 위치 정보를 외삽(Extrapolation)하는 방법과 내삽(Interpolation)하는 방법입니다. 표현이 조금 어려운데요. 쉽게 설명하면 아래 그림과 같습니다.
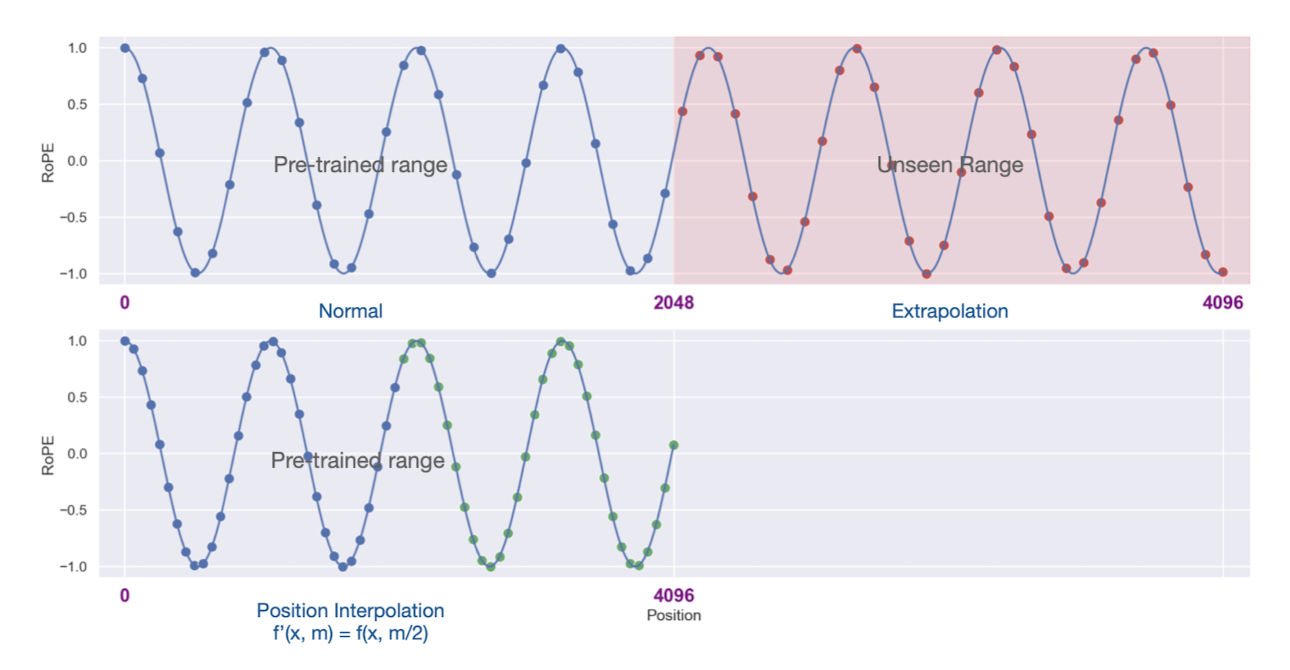
왼쪽 위는 사전 학습된 최대 토큰 길이입니다. 위 예시에서는 2048개의 토큰을 최대 길이로 학습했습니다. 그리고 붉게 칠해진 오른쪽 위 영역은 최대 토큰 길이를 넘어서는 영역이죠. 이 영역은 모델이 학습하지 않은 범위이기 때문에, 이미 학습한 위치 임베딩 정보(1부터 2048번째)를 4096번째 토큰까지 확장해야 합니다. 이를 학습 영역 바깥에 위치 정보를 반영한다는 점에서 위치 외삽이라 합니다.
반면, 왼쪽 아래는 긴 입력값을 사전 학습된 범위로 좁혀옵니다. 즉, 긴 컨텍스트에 세밀하게 위치 정보를 부여해, 짧은 텍스트 내의 관계처럼 이해하도록 만드는 것인데요. 이렇게 위치 정보를 정규화하는 방법이 위치 내삽에 해당합니다. 이렇듯 이미 학습한 위치 관계를 부여함으로써 긴 컨텍스트에 대해서도 관계를 제대로 추론할 수 있도록 만드는 것이 위치 임베딩의 특징입니다. 이제 긴 텍스트를 위한 위치 임베딩은 거의 기본 단계로 자리 잡았습니다. 하지만 그렇다고 하더라도 위치 정보를 확장하거나, 압축하는 정도가 크면 클수록 정확도는 떨어지게 마련입니다. 2048개를 최대 길이로 학습한 모델이 갑자기 10만 개의 토큰을 이해하기란 어렵다는 것입니다. 여기에 새로운 방법이 필요합니다.
3. 그외의 방법들
연산을 최적화하기 위해 IO-awareness 방식의 FlashAttention(⚡ 링크)이나 성능을 유지하면서 연산량을 줄이기 위한 GQA(👥 링크) 방식은 제법 보편화됐습니다. (이에 대해 궁금하신 분들은 각 논문 링크를 참고해주세요.) 이제는 단순히 2배, 4배를 늘리는 것이 아니라 100배 가까이 키우는 것이 목표가 됐습니다.
올해 연구에서는 앞서 언급한 위치 임베딩 방식을 개선해 Llama 아키텍처의 컨텍스트 윈도우를 128K까지 확장하는 데 성공했습니다(YaRN). 쉽게 설명하면, 필수적인 정보에 대해서는 손실을 줄이고, 불필요한 정보에 대해 더 많은 조정을 가해 보간하는 방법입니다.
메모리를 효율적으로 압축해 무한히(?) 확장하는 방법(Infini-Attention)도 발표됐습니다. 기본적인 Attention 매커니즘을 활용하되 압축 메모리 정보를 통합하고, 여기에 더해 Masked Local Attention과 Linear Attention을 결합한 것입니다. 이름과는 달리 실제로는 1M, 500K 토큰을 요약하는 수준입니다.
이렇게 언어 모델이 긴 텍스트를 한 번에 이해할 수 있는 방법에 대해 정리해봤습니다. 한 줄로 요약하면, 여전히 제한된 연산량 내에서 학습이 이뤄지고 있지만 긴 컨텍스트를 효율적으로 처리해 모델이 이해하고 있는 내용으로 압축하려는 시도들입니다.
저마다 방법은 다르지만 대체로 큰 틀은 벗어나지 않는 모습입니다. 앞으로도 더 개선된 위치 임베딩 방법과 연산 효율 또는 최적화가 관건인 모습입니다. 발전 속도가 빠르다 보니 두꺼운 원서마저도 한 번에 이해할 수 있는 언어 모델이 나올지도 모르겠습니다. 게다가 여기에 멀티모달 성능이 통합된다면 더욱 놀라운 서비스들이 등장할 것 같기도 하네요.