
Meta의 새로운 오픈소스 모델, Llama 3
언어 모델의 규모가 점점 커지고 넓은 분야에서 전문가에 준하는 능력을 갖추게 됨에 따라, 인공지능이 불러올 잠재적인 위협에 대한 우려의 목소리가 커졌습니다. 강력한 인공지능의 오남용을 예방하기 위한 대책 중 하나는, 그동안 대중들에게 완전히 공개했던 연구 결과와 소스 코드 중 일부를 공개하지 않는 것이었죠. 겉으로 보기에는 합리적인 대안이지만, 안타깝게도 개방성에 힘입어 빠르게 성장하던 AI 연구에 일종의 브레이크가 걸리게 된 셈입니다.
개방성을 표방하던 OpenAI가 안전에 대한 우려로 더 이상 연구를 공개하지 않게 되면서, LLM 연구는 점점 폐쇄성을 띄게 됐습니다. 대규모 언어 모델(Large Language Model; LLM)은 이름만큼이나 개발에 거대한 자본이 필요하기 때문에, 이런 현상은 언어 모델 연구의 문턱을 높이는 결과를 낳게 됐죠.
이때 연구자들에게 한 줄기 빛과 같은 모델이 등장했는데, 바로 Meta가 발표한 Llama 2(라마 2)입니다. 라마 2는 연구용과 상업용으로 모두 사용할 수 있는 오픈소스 모델인 데다가, 그 성능마저 매우 뛰어났습니다. 덕분에 인공지능의 성능 개선을 위한 다양한 방법론이 연구되며 이 분야는 꾸준한 성장을 이룰 수 있었습니다.
하지만 모델의 규모와 사전 학습(Pre-training)이 인공지능 모델의 성능에 미치는 영향은 더없이 큽니다. 거대 기업에서 아낌없이 자본과 인력을 투자해 개발한 Google의 Gemini, OpenAI의 GPT-4, 그리고 OpenAI 다음가는 최대의 인공지능 스타트업으로 여겨지는 Anthropic의 Claude3를 비롯한 상업용 LLM은 막강한 성능을 자랑하며, 오픈소스 진영과의 격차를 다시 한번 벌려놓았습니다.
그러던 중 Meta가 작년 약 15만개의 H100 GPU를 구입했다는 소식이 들려온 후, 그들이 발표하게 될 새로운 오픈소스 모델에 대한 기대감은 계속해서 증폭됐습니다. 그런데 올해 여름에 공개된다고 알려진 Meta의 최신 오픈소스 모델 Llama 3(라마 3)가 4월 중순 세상에 모습을 드러냈습니다. 천문학적인 자원을 투자해 개발한 모델을 Meta는 이번에도 모두에게 공개하며, 전 세계적으로 열렬한 호응을 받고 있습니다. 라마 3는 어떤 모습으로 인공지능 연구 생태계를 변화시키고 있을까요?
Llama 3, 얼마나 뛰어날까?
Meta는 라마 3를 소개하는 글에서 최고의 성능을 보이는 상업용 LLM과 동등한 수준의 오픈소스 모델을 구축하겠다는 목표를 밝혔습니다. 특히, 책임감 있는(Responsible) LLM의 사용과 배포에 대한 선도적인 역할을 수행하기 위해 지속해서 개발자의 피드백을 반영하며, 개발한 모델을 대중에게 공개하는 오픈소스 정신을 수용하고 있다고 언급합니다. 현재 공개된 모델은 다양한 버전의 라마 3 중 일부이며, 가까운 시일 내에 다국어 처리 능력이 향상되고, 멀티모달을 처리할 수 있으며, 더 긴 컨텍스트를 제공하는 모델을 공개할 것이라고 했습니다.
공개된 모델의 크기는 8B와 70B이며, 아직 훈련을 마치지 않은 400B 규모의 모델은 곧 공개될 예정입니다. 두 모델은 비슷한 규모의 상업용 LLM보다 뛰어난 성능을 보이고 있으며, 특히 추론, 코드 생성, 지시 수행과 같은 능력이 기존의 라마 2 모델보다 유의미하게 향상됐습니다.
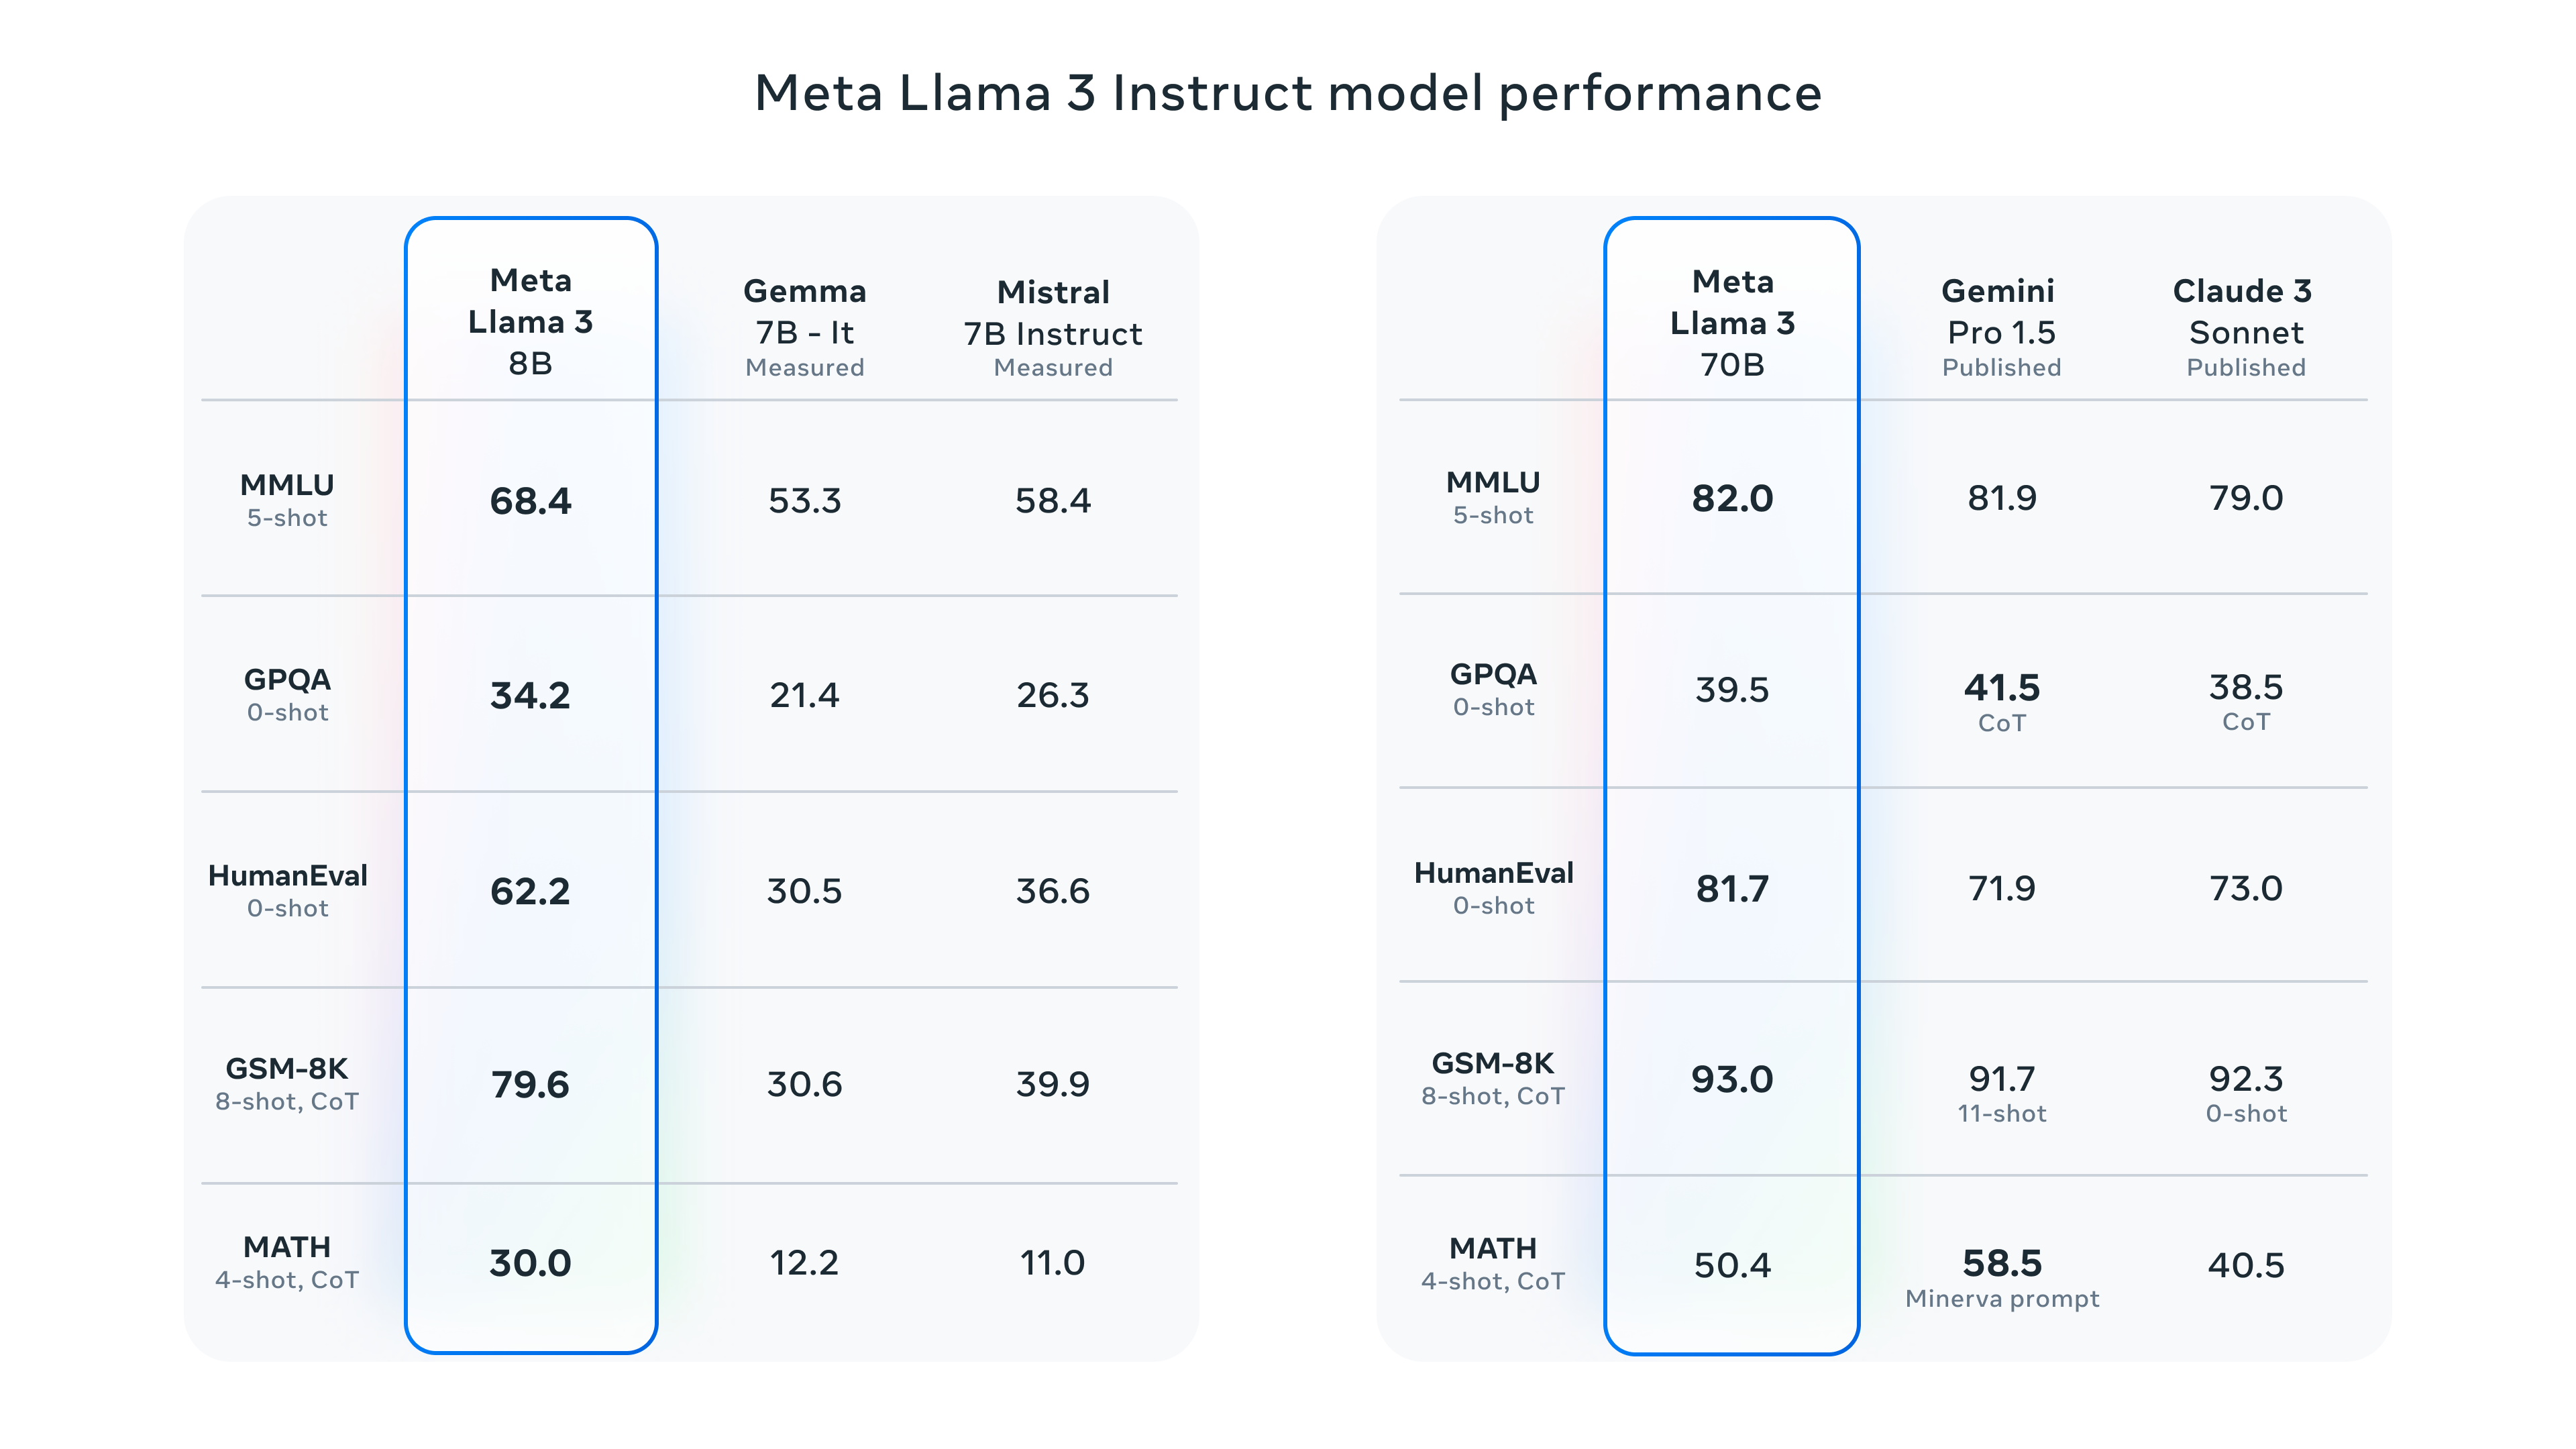
일반적으로 사용되는 LLM 벤치마크가 사람의 선호를 반영하는가에 대한 의문은 끊임없이 제기됐습니다. 실제로 높은 벤치마크 점수를 받은 모델이 서비스 환경에서는 사용자의 기대에 미치지 못하는 실망스러운 모습은 흔히 볼 수 있죠. 그래서 라마 3는 단순히 표준 벤치마크 점수를 높이는 것뿐만 아니라 실제 상황(Real-world scenarios)에서도 높은 성능을 보이도록 최적화됐습니다. Meta는 이를 실현하기 위해 높은 품질의 인간 평가 데이터셋을 구축했습니다.
라마 3가 이 평가 데이터셋에 과대적합되지 않도록, 모델링 팀조차도 이 데이터를 열람할 수 없었다고 합니다. 아래는 라마 3와 비슷한 규모의 상업용 LLM과 평가 결과를 비교한 차트입니다. 평가는 라마 3와 다른 상업용 모델의 응답 중 사람의 선호도가 더 높은 응답을 구하는 방식으로 이루어졌습니다. 평가 결과 지시 수행 능력을 높이도록 학습된 70B 라마 3 모델(70B instruction-following model)이 다른 상업용 LLM보다 사람의 선호도가 높은 것을 알 수 있습니다.
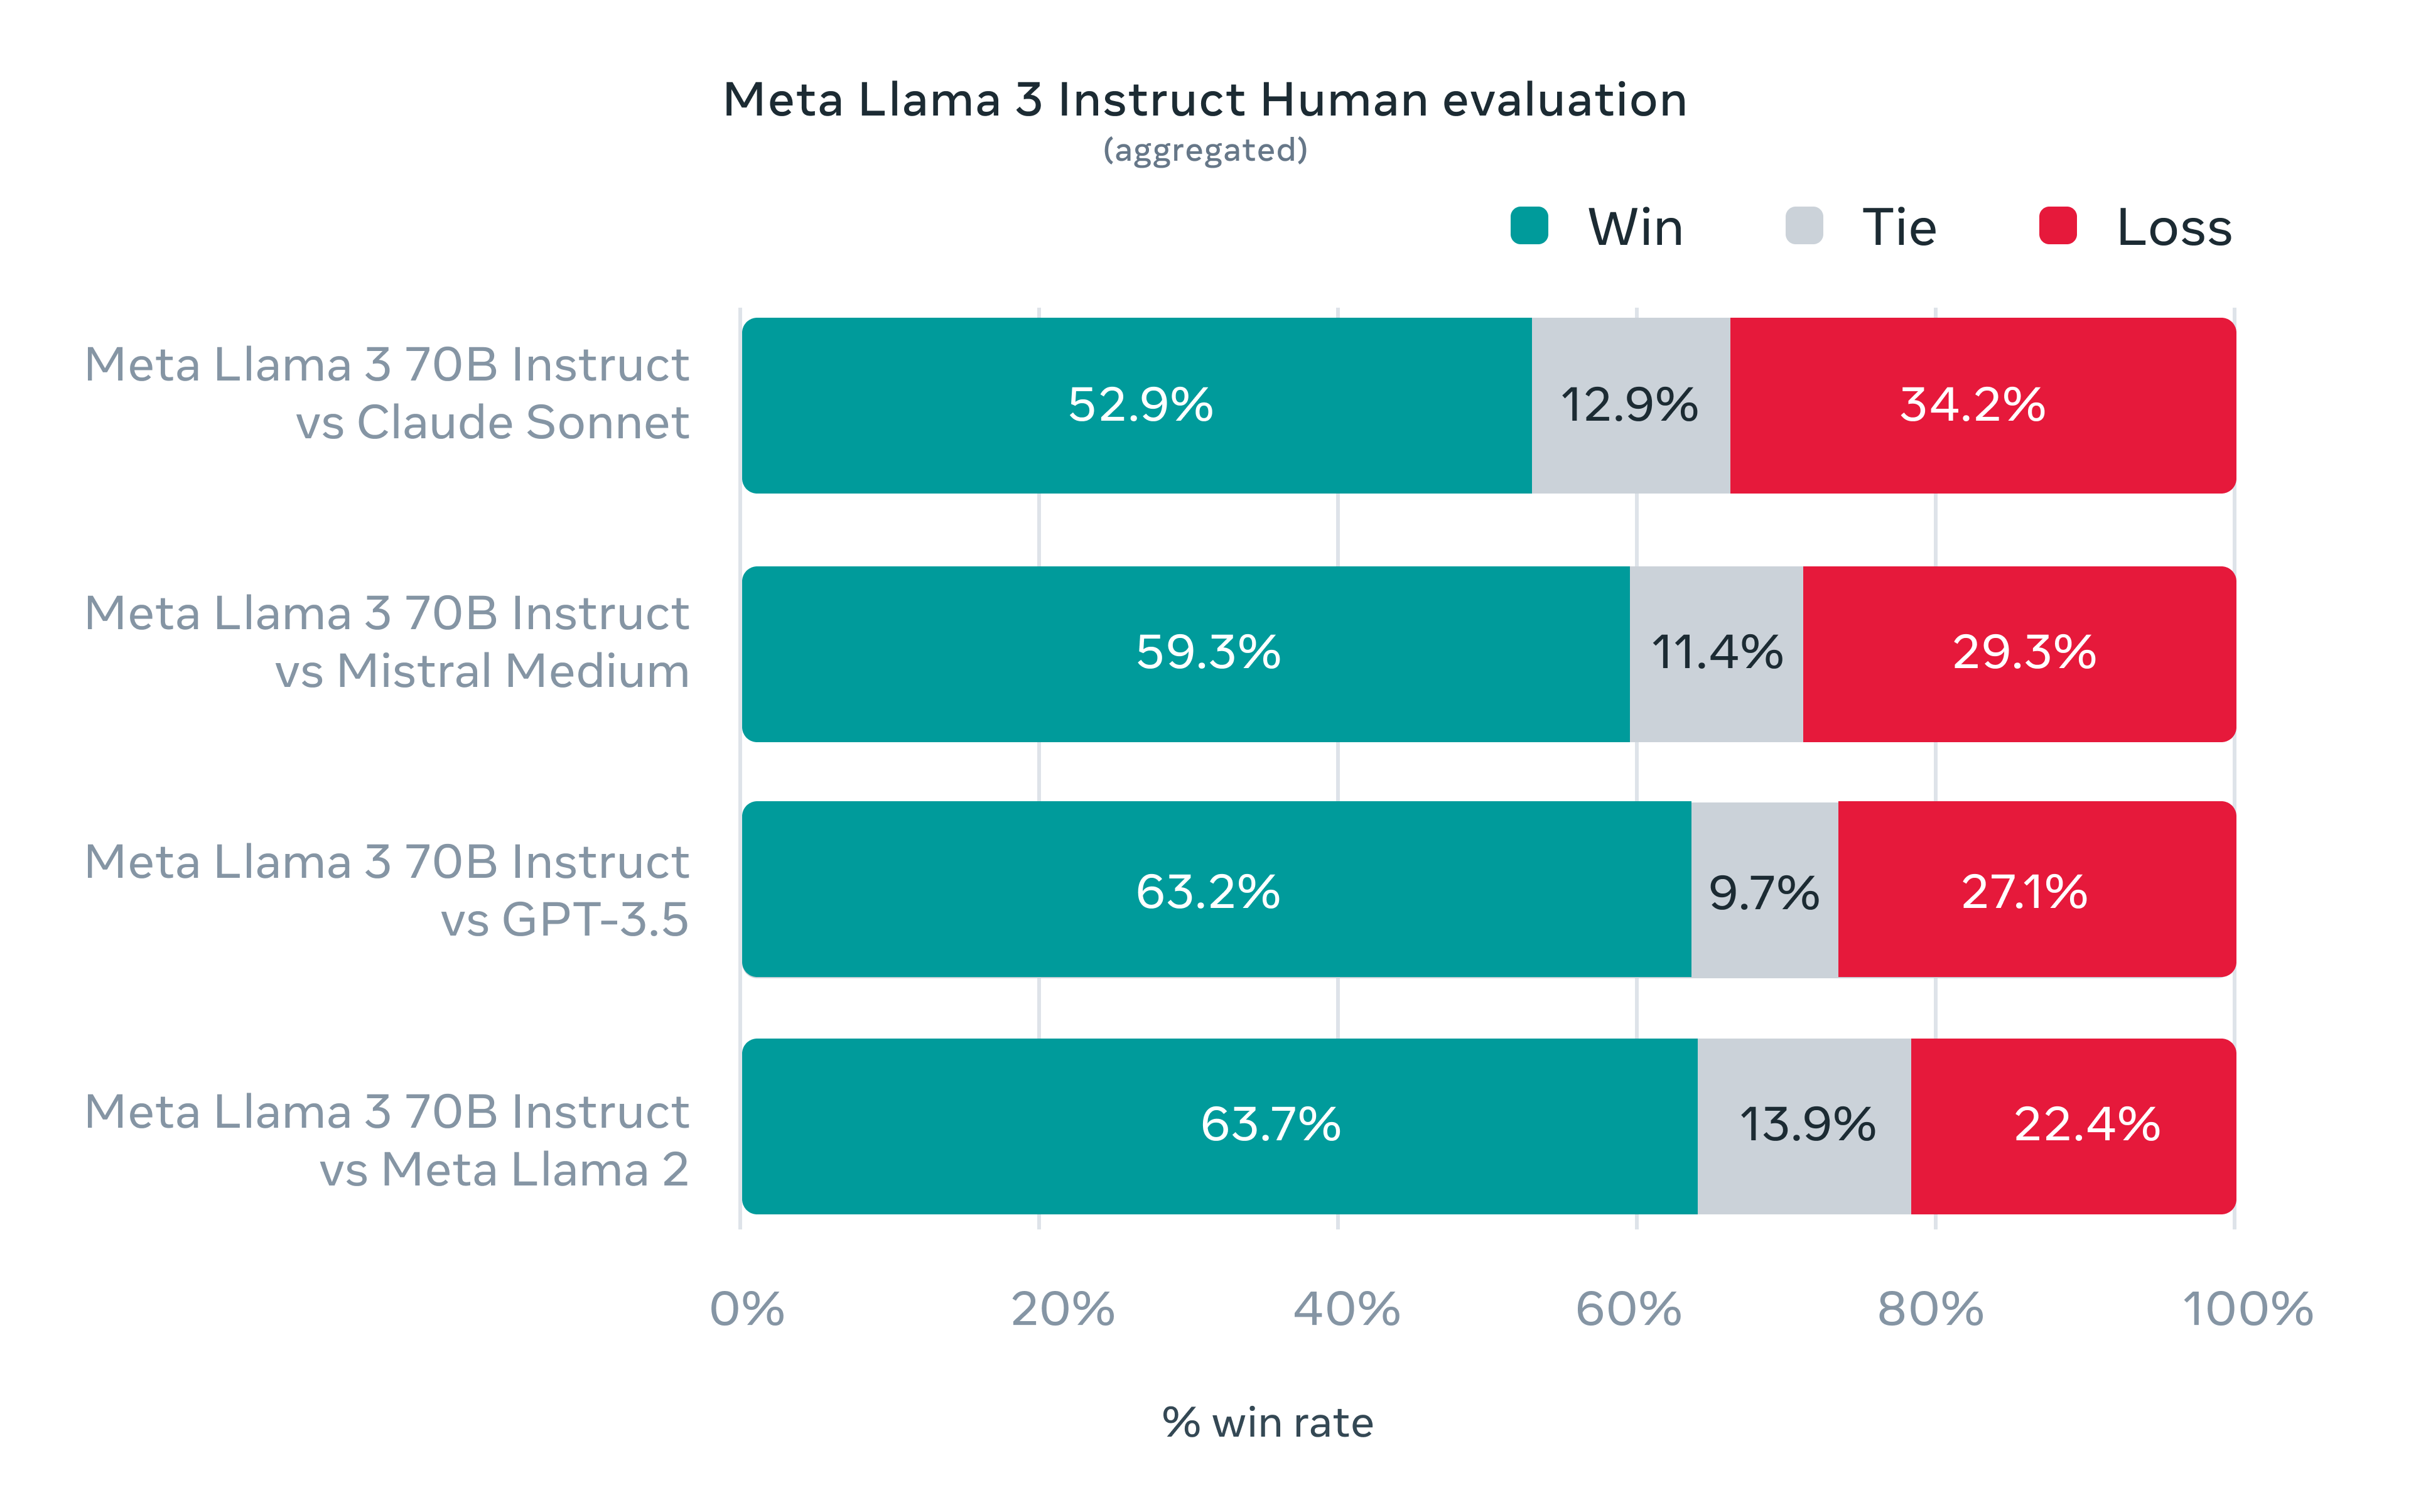
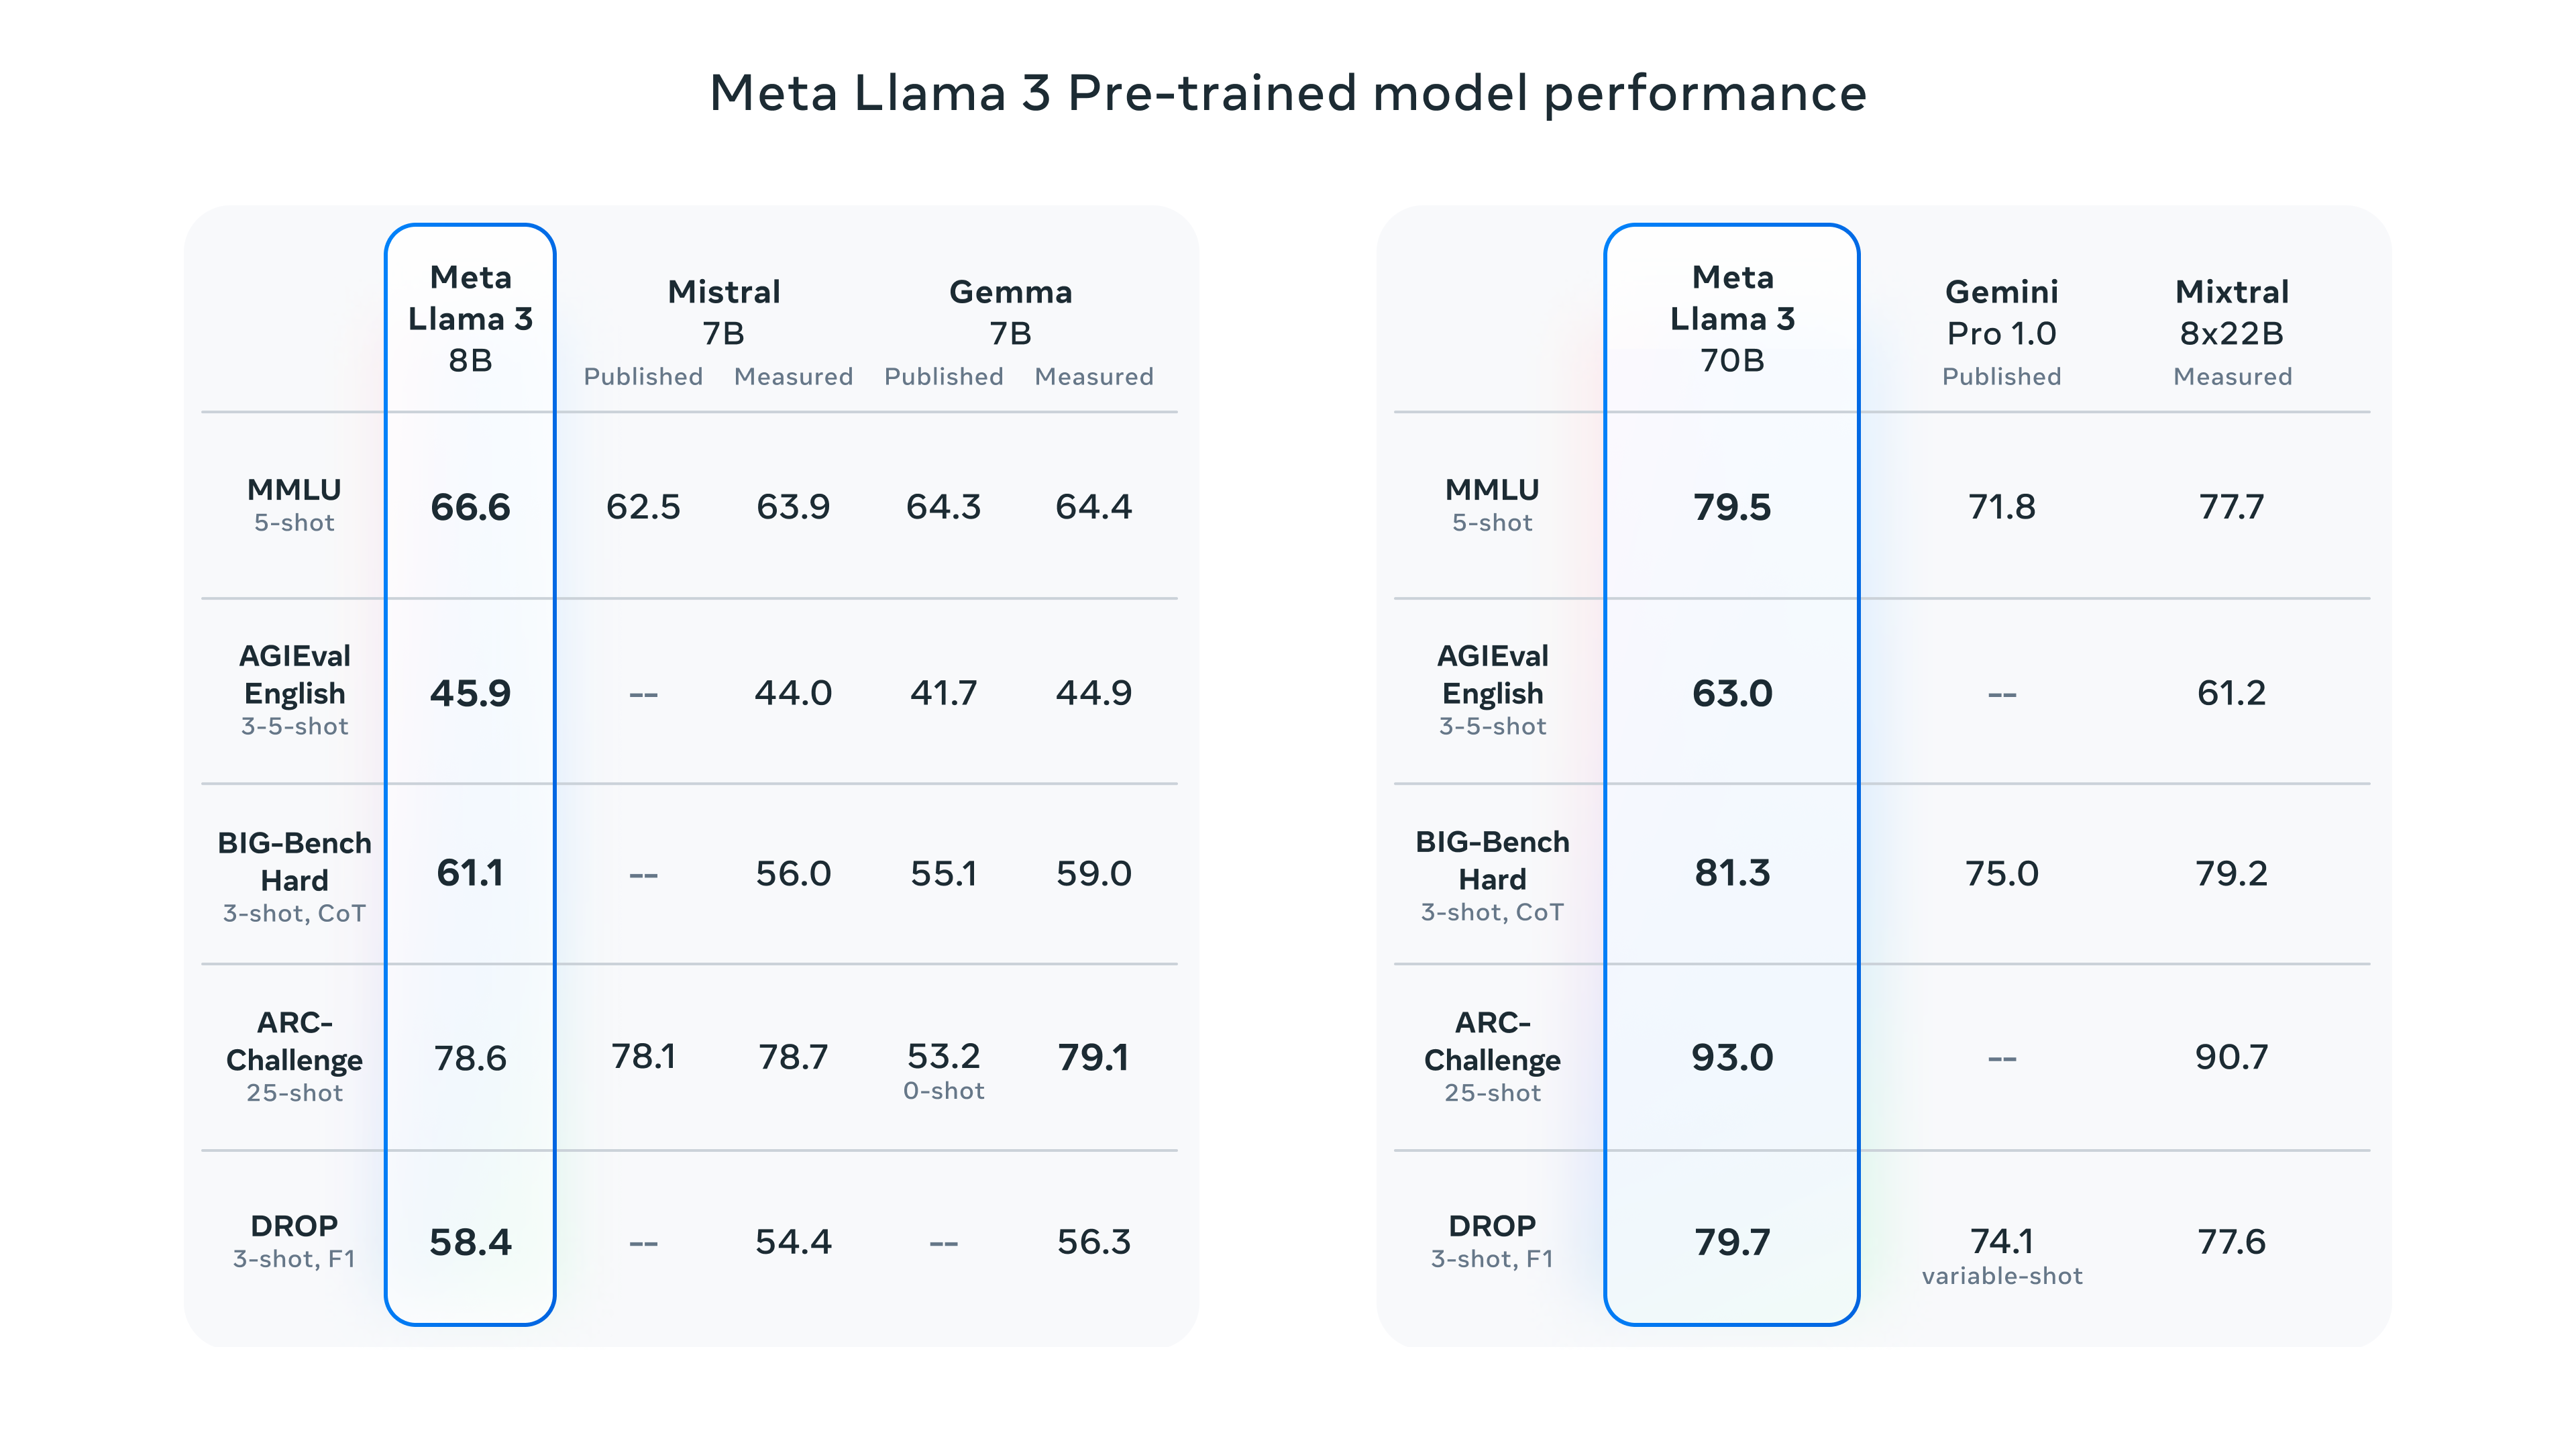
라마 3는 지시 수행 능력을 높이는 방향으로 학습이 됐으면서도, 벤치마크 성능에서도 기존의 모델에 뒤떨어지지 않는 모습을 보였습니다. 다음 벤치마크 결과는 라마 3가 비슷한 규모의 다른 모델에 비해 다양한 영역에서 더 우수한 추론 능력을 보임을 입증합니다.
더욱 똑똑해진 라마 3의 비결
Meta는 뛰어난 언어 모델을 개발하기 위해서 네 가지 요소에 특히 신경을 썼습니다. 여기에는 모델 아키텍처와 학습 데이터는 물론, 사전 학습의 규모와 모델이 사용자의 지시를 잘 따르도록 하는 파인튜닝(Instruction fine-tuning) 과정이 포함됩니다.
기존의 설계 철학을 따라 라마 3는 트랜스포머의 디코더(Decoder)만을 사용하는 표준적인 아키텍처를 가집니다. 하지만 라마 2와 비교해 라마 3는 128K 크기의 어휘 사전(Vocabulary)을 사용하여 모델 성능이 크게 향상됐습니다. 한국어 파인튜닝을 수행한 연구자들의 사용 후기로는, 이전에 비해 자연스러운 한국어를 사용하며 다양한 표현을 사용한다고 합니다. 또한 추론 과정에서의 효율을 높이기 위해 Grouped Query Attention(GQA) 기술을 사용했으며, 라마 2보다 두 배 길어진 8,192개 토큰 길이의 시퀀스로 학습이 이루어졌습니다.
Meta는 특히 라마 3의 사전 학습 데이터(Pre-training data)에 많은 투자를 했습니다. 라마 3는 15T개의 토큰으로 학습됐는데, 라마 2가 2T 토큰으로 학습된 점을 감안하면 7배가 넘는 학습 데이터를 사용한 셈입니다. 게다가 학습 데이터 중 5% 이상이 다국어 데이터로 구성되어 있으며, 코드 데이터는 이전보다 4배 이상 많아져 새로운 모델의 다국어 사용 능력과 추론 능력이 더욱 개선됐습니다. 학습 데이터의 품질을 위해 Meta는 라마 2 모델을 사용하여 별도의 분류 모델을 개발했고, 이를 통해 최고의 품질을 데이터를 확보할 수 있었습니다.
라마 3는 기존의 규모가 같은 기존의 모델보다 훨씬 더 많은 양의 데이터를 학습했습니다. Meta의 연구진은 이 과정에서 모델 규모와 학습 데이터 크기의 관계를 정의한 이른바 친칠라 법칙(Chichilla-optimal)에 반하는 새로운 현상을 발견했습니다. 친칠라 법칙에 의하면 8B 모델은 200B 토큰 정도로 학습하는 게 가장 효율적이지만, 연구진은 그 이상의 데이터를 학습한 8B와 70B 모델의 성능이 계속해서 개선되는 것을 발견했습니다.
라마 3가 챗봇으로 사용될 때 제 성능을 온전히 발휘할 수 있도록, 다양한 방식의 추가 학습도 이루어졌습니다. LLM 모델이 생성한 여러 응답에 대한 선호도에 인간이 직접 순위를 매기고, 이를 데이터로 학습하는 방식을 Learning from preference rankings라고 합니다. 이런 방식으로 학습한 모델은 어려운 추론 문제에 직면해도 올바른 정답을 생성할 수 있게 됩니다. 이와 같은 사후 훈련(Post-training) 덕분에 라마 3의 성능은 한층 더 개선될 수 있었습니다.
한층 더 안전해진 라마 3, 그리고 그 후
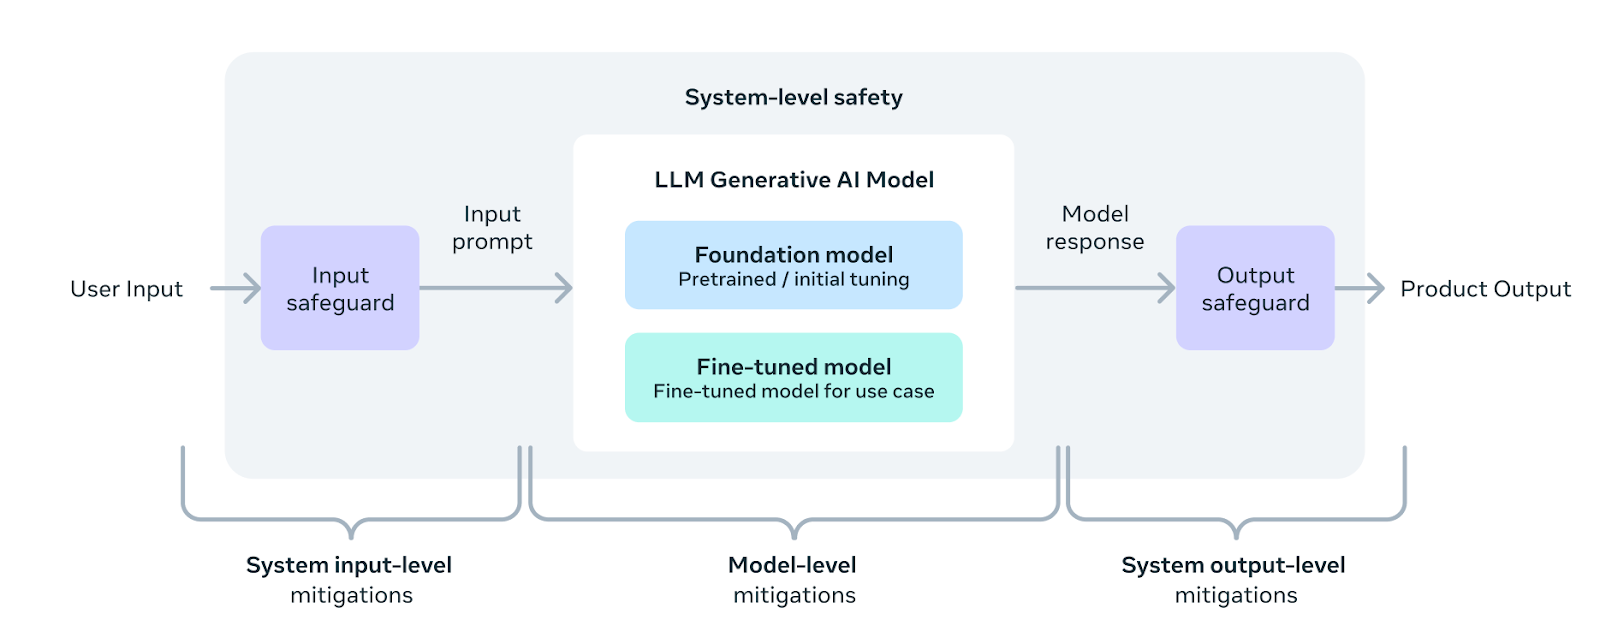
Meta는 책임감 있는 모델 배포를 위해 라마 3를 설계하는 데 특별한 방식을 사용했습니다. 먼저 전문가와의 레드티밍(Red-teaming)을 거쳐 언어 모델이 잠재적으로 위협이 되는 대답을 생성하지 않도록 훈련했습니다. 또한 언어 모델이 입력받는 프롬프트와 생성하는 응답의 안전을 보장하기 위한 Llama Guard 모델이 사용됐습니다. Meta는 언어 모델에 의한 잠재적 피해를 완화하기 위해 책임감 있는 사용 지침(Responsible Use Guide, RUG)를 지속적으로 개발하고 있으며, 라마 3의 모든 입력과 출력에 필터링을 적용할 것을 권장하고 있습니다.
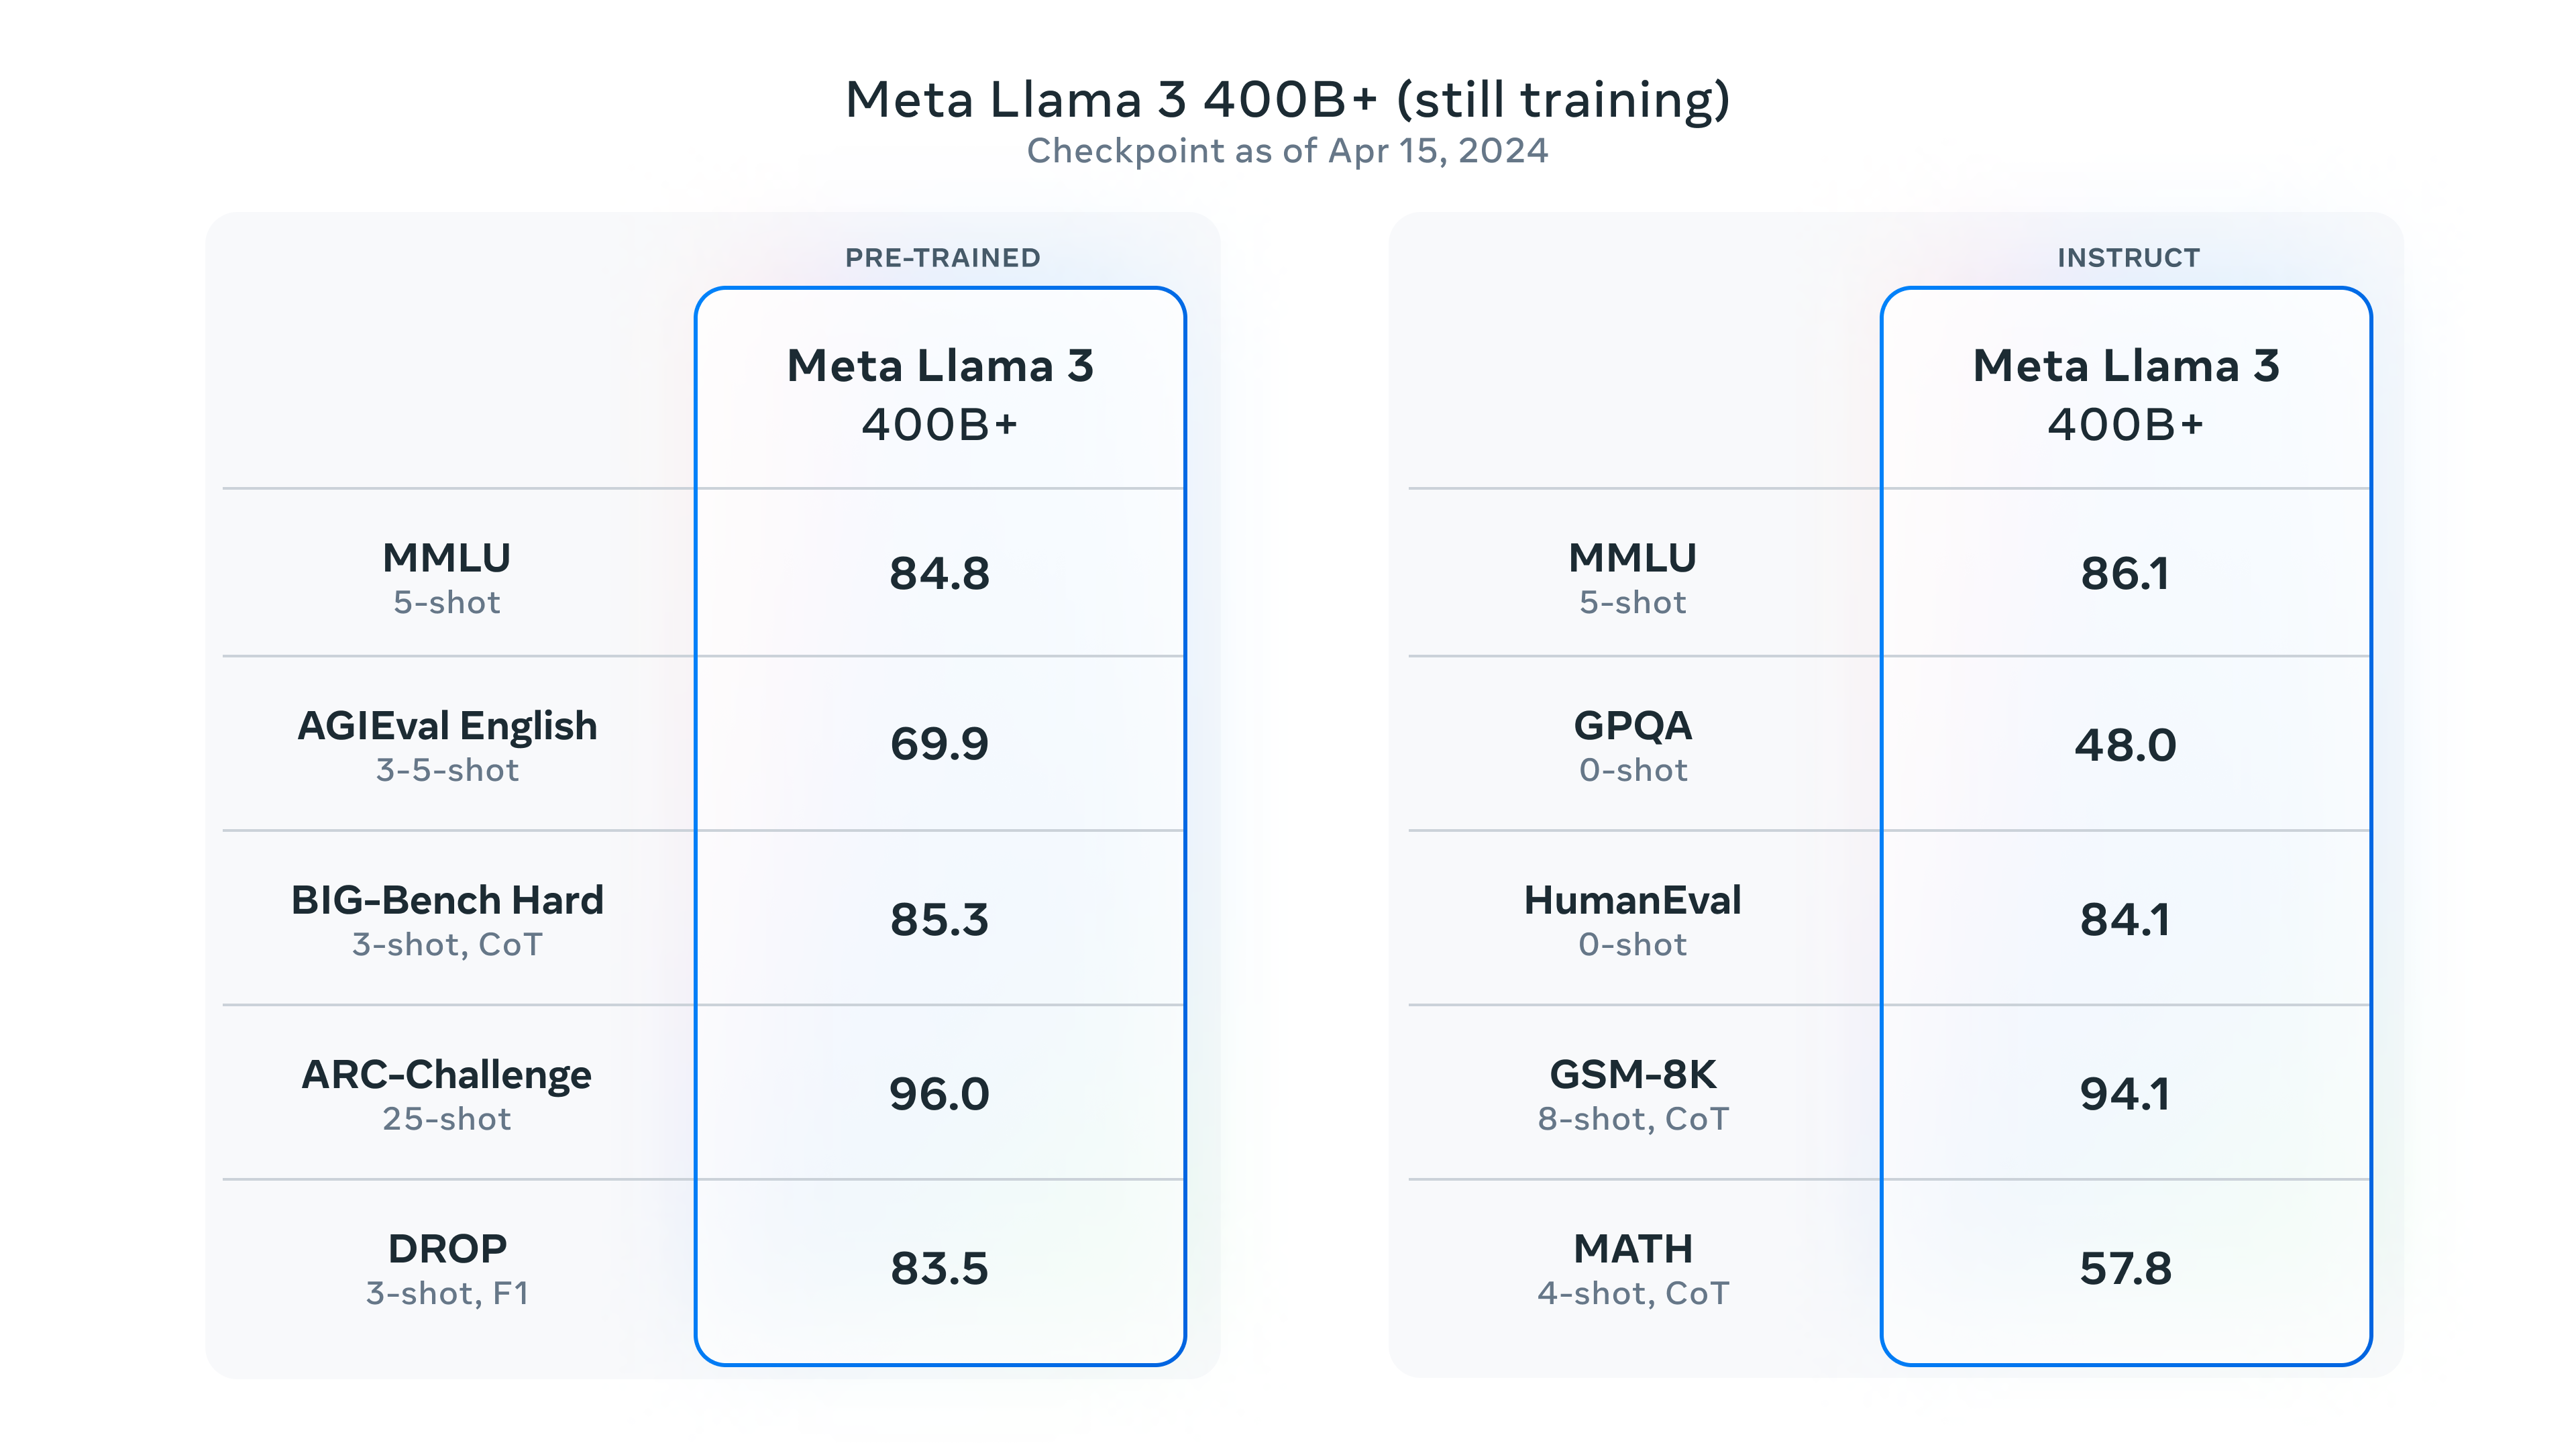
사실 전 세계가 라마 3에 대해 건 기대는 이것 때문만은 아니었습니다. 아직 Meta에서 발표하지 않은 하나의 모델이 남아있는데, 바로 400B 규모의 라마 3입니다. 이 모델은 여전히 학습 중이지만, 학습이 완료되지 않은 시점에서도 매우 뛰어난 성능을 보입니다. 아래는 아직 학습을 마치지 않은 400B 규모의 라마 3에 대한 벤치마크 결과입니다. GPT-4의 MMLU 점수가 86.4라는 점에서, 라마 3는 초거대규모의 상업용 모델에 뒤처지지 않는 성능을 보일 것으로 기대됩니다.
라마 3 공개는 Meta의 전략이다?
Meta의 최신 오픈소스 모델이 다시 한번 전 세계를 들썩이게 만들 때, 한쪽에서는 Meta의 이런 행보는 전략적인 선택일 뿐이라는 비판도 제기되고 있습니다. 게다가 엄밀한 기준에서 라마 3는 오픈소스라고 말하기 어렵다는 의견도 있습니다. 라마 3의 공개는 단지 언어 모델 연구에 대한 표준을 제시하고, Meta는 그 시장을 선점하려는 철저히 계산된 전략이라고 말이죠.
그런데도 불구하고 Meta의 큰 결심은 인공지능 연구에 새로운 희망의 바람을 불어넣었다고 생각합니다. 특히 오픈소스 진영이 상업용 LLM과의 성능 격차를 좁히고, 결국 인공지능 대중화에 크게 기여하게 될 것입니다. 그 자체만으로도 뛰어난 성능을 보이는 모델을 사용할 수 있게 된 덕분에, 연구자들은 더욱 폭넓은 실험을 수행할 수 있게 됐습니다.
Meta의 전략이 무엇이든, 라마 3와 함께 이루어질 앞으로의 수많은 인공지능 연구가, 그리고 과연 앞으로는 또 어떤 놀라운 일들이 우리를 찾아올지 기대됩니다. 라마 3는 인류가 AGI에 도달하는 데 얼마나 큰 영향을 미치게 될까요? 그리고 그날이 오면, Meta는 어떤 비전으로 인공지능 연구에 또 다른 기여를 하게 될까요?