
A/B Test용 제목 중국이 쏘아올린 공
10K만으로 LLM을 파인튜닝할 수 있다면?
안녕하세요, 에디터 ARI입니다.
인공지능에도 국경이 있을까요? 적어도 오늘날을 살아가는 우리에게는 체감되지 않는 것 같습니다. 포털사이트에 접속할 수 있고 타자 몇 번을 칠 수 있는 여건만 갖춰진다면, 이제 인공지능은 누구나 쓸 수 있는 기술이 됐기 때문입니다. 기술에는 국경이 없다지만, 곰곰이 생각해 보면 인공지능에는 패권을 쥔 국가가 있는데요. 바로 미국입니다. 오픈소스 정신으로 꾸준한 연구를 이어오고 있는 Meta, ChatGPT와 Sora로 시장의 판도를 바꾼 OpenAI, Gemini 출시와 함께 AI 경쟁에 본격적으로 합류한 Google까지, 미국이 전 세계 AI 시장을 꽉 쥐고 있는 모습이죠.
최근 공고한 미국 중심의 AI 시장에 도전장을 내미는 국가가 있으니, 바로 중국입니다. 미국의 빅 테크 기업들이 거대한 모델을 출시하며 대중의 눈을 사로잡는 사이, 중국의 대기업과 연구자들은 꽤 주목할 만한 성과를 내고 있었습니다. Tencent 그룹이 출시한 훈위안(Hunyuan)이나, 최근 Alibaba가 출시한 EMO가 그 예시입니다.
그런 중국에서 인공지능 연구자들을 놀라게 한 논문을 하나 발표했는데요. 01.AI의 Yi: Open Foundation Models by 01.AI 입니다. 이 연구가 주목을 받은 이유는 줄곧 신경 쓰던 데이터의 ‘양’이 아니라 ‘품질’에 집중했기 때문입니다. 게다가 특별한 아키텍처를 사용하지 않고도 GPT-3.5에 준하는 성능을 낸 데다, 10K 미만의 데이터만으로 LLM을 파인튜닝할 수 있다고 하는데, 대체 이게 어떻게 가능한 일일까요?
Data quality is all you need!
“Data quality is all you need”. 이보다 Yi 모델의 핵심을 관통하는 말은 없을 것 같습니다. 연구진들은 화려한 아키텍처보다도 모델에 학습할 데이터의 품질을 높이는 데 집중했습니다. 특히, 이전의 많은 모델들은 텍스트가 길어지면 맥락을 파악하지 못한다든가, 이미지를 보고 의미를 유추하기 어려워하는 모습을 보였는데요. 이를 해결할 해답이 ‘데이터’에 있다고 보았습니다.
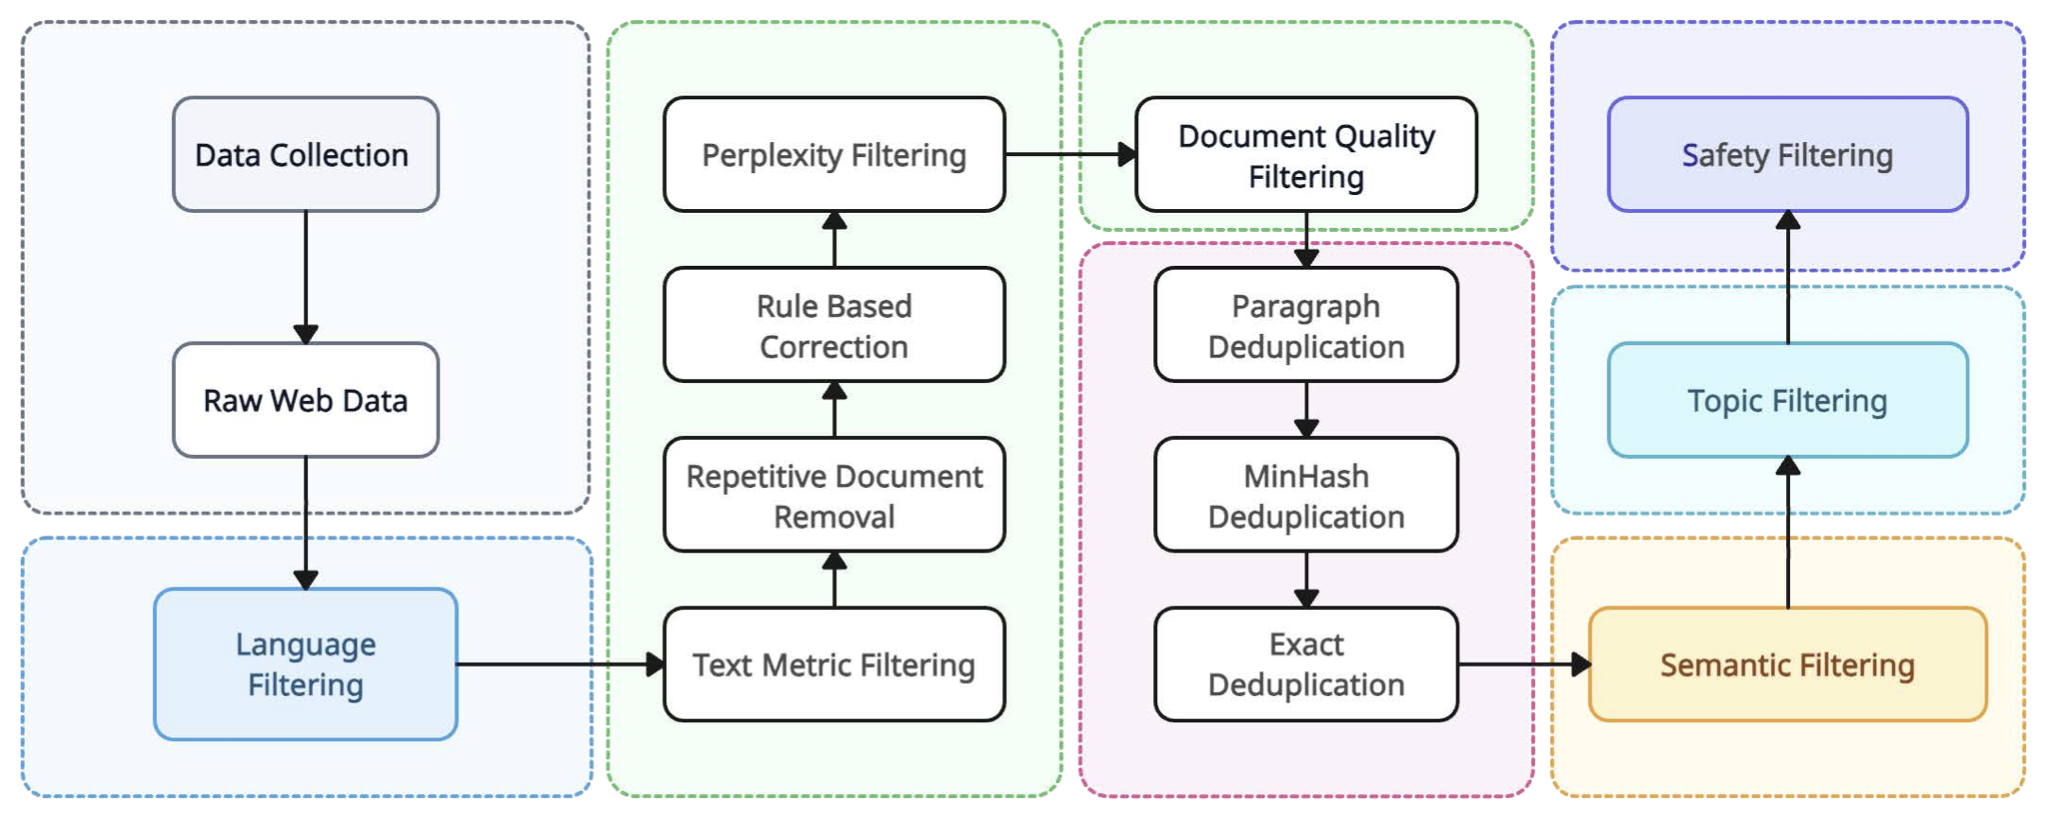
출처: Yi: Open Foundation Models by 01.AI (01.AI, 2024)
데이터 정제 파이프라인을 보면 그 고민이 여실히 드러납니다. 수많은 필터링 후 선별된 데이터만 이용하는 구조로, 그중 몇 가지 방법만 간략히 소개하겠습니다.
첫째, Heuristic Rule Filters입니다. 이 단계에서는 낮은 품질의 텍스트를 통계 기반으로 제거합니다. URL이나 도메인이 섞여 있는 것, 특수 기호가 많이 들어있는 것, 무의미하게 반복되는 단어들이 자주 등장하는 경우죠.
둘째, Learned Filters입니다. Yi는 중국어와 영어를 모두 학습하는 이중 언어(Bilingual language) 모델인데요. 중국어 텍스트에는 음란물이나 도박 같은 부적절한 콘텐츠가 많이 섞여 있어 거르는 과정이 필요합니다. 앞선 방법으로는 식별이 어려워 Perplexity‧Quality‧Safety‧Document coherence Scorer의 4가지 기준으로 판단합니다.
셋째, 비지도 학습 기반의 Semantic Clustering입니다. 말 그대로 의미상 비슷한 군집(문서)을 찾습니다. 클러스터링 된 군집에는 품질 라벨이 달려 저품질의 문서를 제거하거나 이후 문서 식별에 사용됩니다.
마지막으로, 중복을 제거하는 Deduplication입니다. 해당 단계에서는 문서 내 중복과 문서 간의 중복을 제거하는데요. 두 집합이 얼마나 유사한지 추정하는 알고리즘인 Minhash를 사용합니다.
여기에 문서 종류의 비율을 조정해 데이터의 다양성을 높였습니다. 최종적으로 영어와 중국어를 포함한 3.1T 토큰의 품질 높은 데이터를 확보하고, 이를 가지고 사전 훈련을 진행합니다.
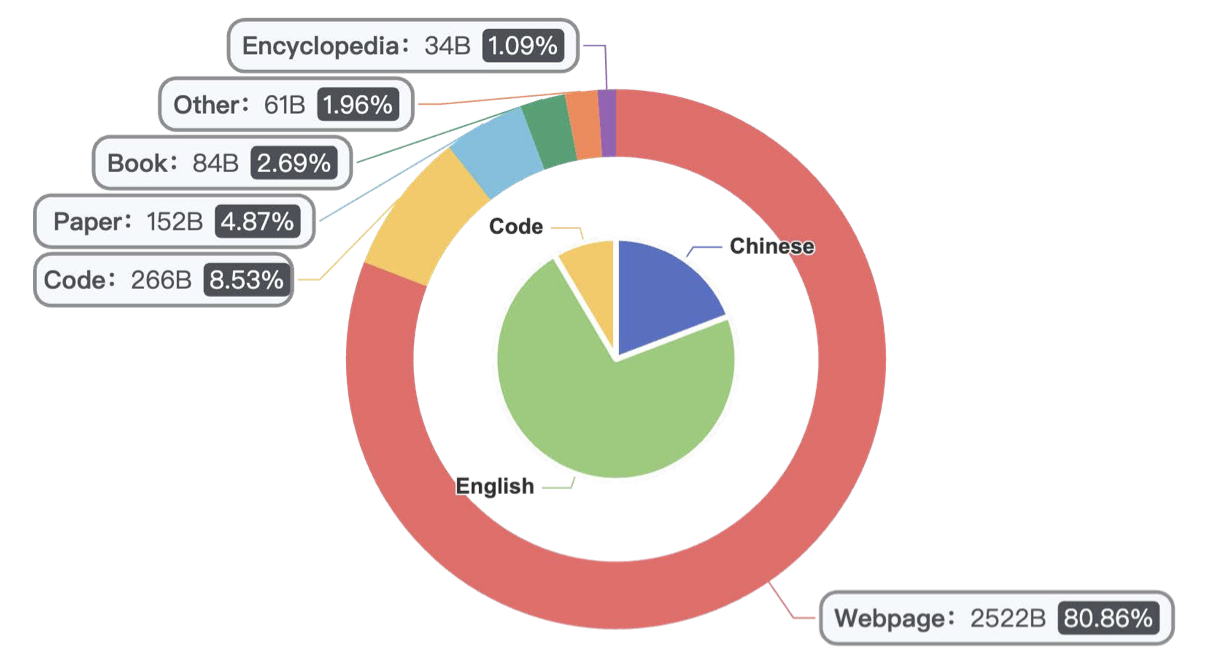
출처: Yi: Open Foundation Models by 01.AI (01.AI, 2024)
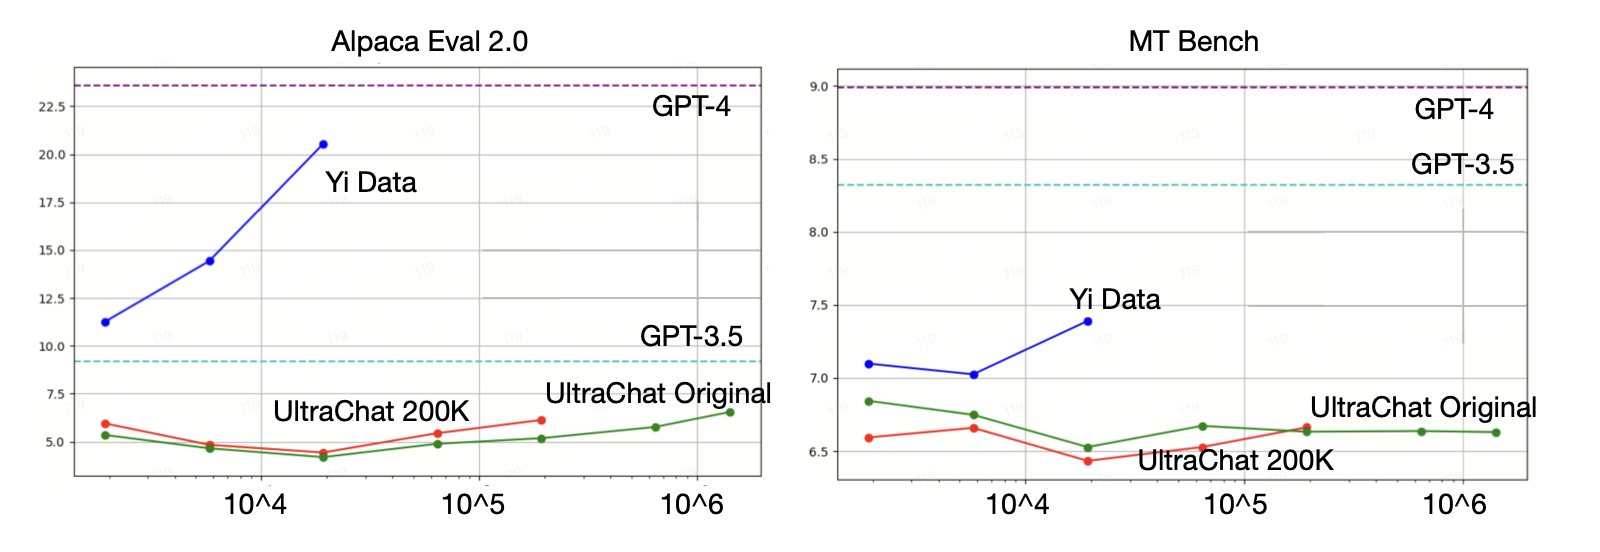
파인튜닝 시에도 마찬가지로 데이터의 품질을 저하하지 않기 위해, 사용자 피드백을 여러 번 반복한 데이터를 사용했습니다. 독특한 것은 단 10K도 안 되는 응답-지시 쌍을 활용했다는 점인데요. FLAN이나 UltraChat처럼 데이터의 양을 수백만 개로 늘리면, 모든 데이터를 훑을 수 없어 그 품질을 보장하기 어렵다는 점에 착안했습니다. 반대로 작은 규모의 데이터를 활용한다면 어떨까요? 관리가 가능한 정도의 규모라면, 데이터의 다양성이 부족한지 혹은 부적절한 용어가 섞여 있는지 등 품질 관리가 비교적 쉽겠죠. 모델의 환각을 제거하거나 성능을 제어하기도 용이합니다. 실제로 연구진들은 초기 실험에서 수십만 개의 오픈소스 데이터와 선별된 작은 데이터를 비교 실험했을 때, 후자의 성능이 더 좋음을 확인했습니다.
거대한 모델이 다가 아니다?
Yi 모델이 주목받는 데는 또 다른 이유가 있습니다. 바로 규모에 대한 고민 때문입니다. Yi 모델은 연구 당시 6B, 34B, 70B+ 등 다양한 규모가 고려됐는데요. Chinchilla나 Llama2의 모델 크기인 70B가 아니라, 그보다 절반 가까이 작은 34B와 6B를 최종 모델로 선택했습니다. 일반 소비자도 충분히 사용할 수 있는 모델을 만들겠다는 이유에서죠.
하지만 작아진 모델로 충분한 성능을 낼 수 있을까요? 연구진은 사전 훈련할 데이터의 양을 조절해 이를 극복하고자 했습니다. 연산 Flops가 감소한 만큼 데이터의 양을 증가시켜 성능을 끌어올리는 것이죠. 실제로 최적의 토큰 규모는 1T 정도였지만, 연구진은 3.1T 정도의 토큰으로 모델을 훈련했습니다. 덕분에 목표했던 24G GPU 메모리에서도 작동하면서, 성능 저하 없이 충분히 좋은 추론이 가능한 모델을 만들었습니다.
다만, Yi 모델이 거창한 아키텍처를 사용한 것은 아닙니다. 디코더용 트랜스포머를 기반으로, GQA(Grouped-Query Attention)과 RoPE(Rotary Position Embedding) 등이 적용됐습니다. Llama와 동일한 모델 아키텍처를 채택하고 있지만, Llama의 가중치를 사용하지는 않습니다.
Yi 모델은 GPT-3.5에 버금가는 성능을 보여줬습니다. 기존의 LLM을 모두 압도적으로 뛰어넘지는 못하지만, 대부분의 벤치마크에서 꽤나 좋은 성과를 거뒀는데요. 비슷한 성능을 가진 모델 중에서는 모델 규모가 작은 편입니다.
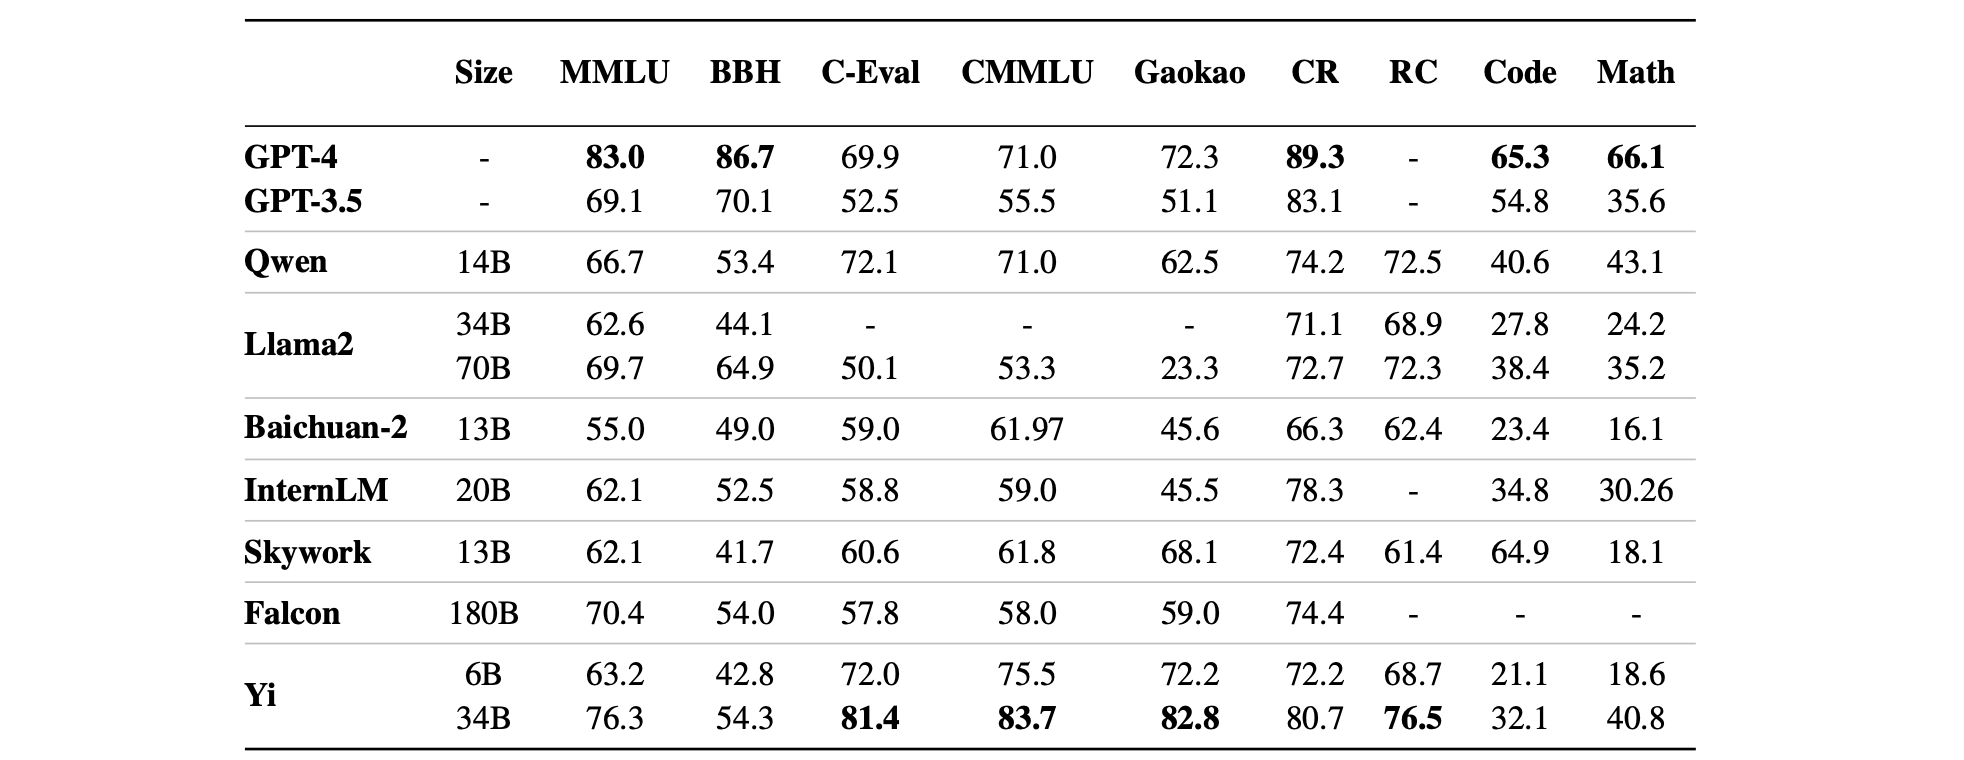
출처: Yi: Open Foundation Models by 01.AI (01.AI, 2024)
챗봇 모델인 Yi-34B-Chat의 성과도 놀라운데요. Alpaca Eval 2.0 리더보드에서 GPT-4 Turbo를 제외하고 기존의 오픈소스 LLM을 압도하는 모습을 보여줬습니다. 또 사전훈련된 Yi 모델은 확장이 가능하도록 설계됐는데요. 200K의 긴 컨텍스트 모델, 깊이 업스케일링(Depth Upscaling) 모델, 비전-언어 모델 등 다양한 아키텍처와 결합한 모델을 구축할 수 있습니다. 일례로, 챗봇 모델을 비전 인코더와 결합해 이미지와 자연어를 해석하는 멀티모달 모델을 만들 수 있죠.
Outro
Yi 모델은 인공지능 연구 분야의 경계선이 점점 흐려지고 있음을 보여주는 것 같습니다. Yi는 텍스트로 사전 훈련됐지만, 다양한 멀티모달 모델로 확장이 가능한데요. GPT로 촉발된 파운데이션 모델(Foundation Model)의 연구 트렌드가 이제는 서서히 자리 잡고 있는 듯합니다.
동시에 미국이 주도하는 AI 세계에 돌을 던진 것처럼 보이는데요. 점점 더 모델의 규모를 키워 높은 성능을 기대하는 연구 트렌드가 항상 옳은 것은 아니라며 반기를 드는 듯하죠. 이 대목에서 우리는 다시 한번 ‘거대한 모델’에 대해 생각해 볼 필요가 있습니다. Yi는 이전에 공개된 LLM에서 특별한 아키텍처를 수정하지 않고도, 데이터의 품질을 적절히 관리한 덕에 그에 준하는 성능을 냈습니다. ‘데이터의 품질’이라는 장치가 제 역할을 톡톡히 한 것입니다. 덕분에 인공지능이 학습할 데이터를 꼼꼼히 확인할 수 있었고, 환각(Hallucination) 효과에 대한 적절한 대응도 할 수 있었죠. 데이터의 규모가 아닌 품질에 집중해 충분히 좋은 성능을 낼 수 있다면, 우리는 이제까지 무작정 규모를 키우는 것이 좋다는 착각과 함께 어떤 학습의 재료를 줄 것인가에 대한 고민을 간과해온 것 같습니다.
과연 인공지능 스타트업 01.AI가 던진 돌은, 공고히 자리를 지키고 있는 인공지능이라는 호수에 더 큰 파장을 일으킬 수 있을까요?
다만사
누구나 풋풋한 어린 시절을 지나 어엿한 어른이 됩니다. 그 첫 번째 관문처럼 보이는 취업. 번듯한 직업을 가지고 사회로 나아가야 한다는 암묵적인 규칙은 때때로 압박으로 다가오는데요.
하지만 직업을 갖는다는 건 돈을 버는 수단, 그 이상의 의미를 지닙니다. 어떤 세계에 푹 빠져 세상을 바라볼지, 나의 삶이 어디로 향하도록 할 것인지, 삶의 방향에 대한 또 한 번의 선택이죠. 오늘은 데이터로 세상을 바라보며 데이터분석가로서의 삶을 배워가고 있는 강지민의 이야기를 들어보았습니다.