
최첨단 AI의 보이지 않는 위협
ChatGPT의 충격적인 등장은 전 세계가 인공지능 연구에 주목하도록 만들었습니다. 이후 각국에서 AI 연구에 관심과 지원을 아끼지 않았으나, 이러한 흐름에 찬물을 끼얹는 사건이 발생했습니다. 2023년 3월, 강력한 인공지능 개발 연구를 6개월 이상 중단해야 한다는 서한이 발표된 것입니다. Pause Giant AI Experiments라는 제목으로 발표된 서한은 인간의 수준에 필적하는 지능을 갖춘 AI가 인류에 심각한 위험을 초래할 수 있으며, 우려되는 만큼 철저한 관리 방법이 마련되어야 한다고 주장합니다.
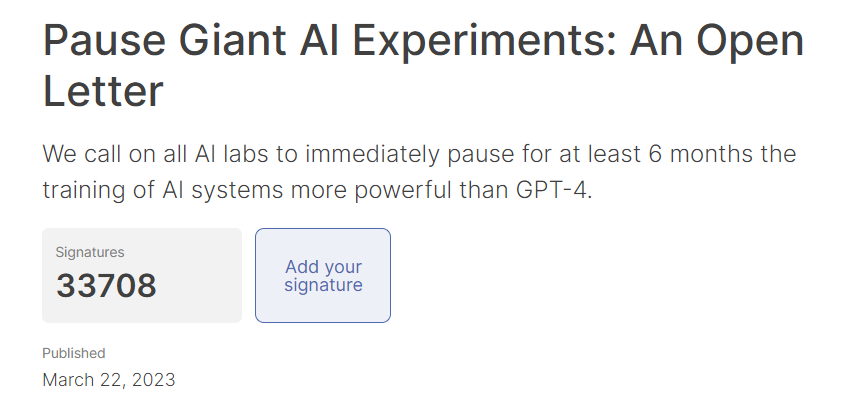
실제로 여러 연구기관에서 경쟁적으로 대규모 언어 모델(Large Language Model, LLM) 연구에 골몰하느라 AI 시스템을 안전하게 통제하기 위한 계획은 뒷전인 모습을 볼 수 있었습니다. 그래서 기존의 연구를 일시 중단하고, 일정 기간 안전 프로토콜을 공동으로 개발해야 한다는 의견은 대중의 적극적인 지지를 받았습니다. 게다가 요슈아 벤지오, 일론 머스크, 스티브 워즈니악, 유발 하라리를 비롯한 각계의 권위자들이 공개서한에 서명하며 그 영향력은 일파만파 퍼져나갔습니다.
초거대 AI에 대한 맹목적인 두려움으로 인공지능에 대한 부정적인 여론이 형성될 때쯤, 앤드류 응과 얀 르쿤은 온라인 토론에서 이런 여론을 반박하는 주장을 펼쳤습니다. 딥러닝 분야의 두 권위자가 직접 나선 만큼, 과도한 우려는 어느 정도 잦아드는 듯했습니다. 하지만 안전한 인공지능에 대한 연구가 필요하다는 사실은 모두가 느끼고 있었죠.
그런데 사실은 GPT-4로 대표되는 초거대 인공지능이 등장하기 한참 전부터, AI 안전(AI Safety)에 깊은 관심을 가져온 기관이 존재했습니다. 바로 Anthropic이라는 기업입니다.
안전을 최우선으로
‘AI research and products that put safety at the frontier.’ Anthropic 홈페이지에 접속하면 가장 먼저 보이는 문구입니다. 직역하면 안전을 최우선으로 하는 AI 연구 및 제품이라는 뜻입니다. 기업 소개에서도 마찬가지로 Anthropic은 AI Safety를 연구하며, 신뢰할 수 있고 해석 가능하며 통제가 가능한(Reliable, Interpretable, and Steerable) AI 시스템의 구축을 목표로 합니다. 그들은 AI가 전 세계에 전례 없던 영향을 미칠 것임을 깨닫고, AI의 시대에 마주할 기회와 위험에 대한 연구에 전념하고 있죠.
Anthropic의 연구는 대부분 LLM이 인간이 추구하는 가치관에 부합하도록 정렬(Align)하는 것을 목표로 합니다. 2021년 12월 1일, Anthropic의 이름으로 발표된 첫 논문, A General Language Assistant as a Laboratory for Alignment는 다음 문장으로 시작합니다.
Given the broad capabilities of large language models, it should be possible to work towards
a general-purpose, text-based assistant that is aligned with human values, meaning that it is
helpful, honest, and harmless.
(한국어 번역 추가)
대규모 언어 모델의 광범위한 기능을 고려할 때, 인간의 가치에 부합하는, 즉 도움이 되고 정직하며 무해한 범용 텍스트 기반 어시스턴트를 구축하는 것을 목표로 삼아야 합니다. (직역)
대규모 언어 모델이 가진 다양한 기능을 고려할 때, 인간의 가치에 부합하는, 즉 도움이 되고 정직하며 무해한 AI의 시스템을 구축하기 위한 노력이 필요합니다. (의역)
현대의 AI 모델은 통제하기 어려운 단계에 이르렀고, 이 사실은 AI에 대한 우려를 불러일으키기 충분하죠. 많은 연구자 이런 문제에 공감하면서도, 적극적으로 AI Safety에 대해 고민하는 연구는 많지 않습니다. 이런 상황에서 Anthropic은 이 문제를 피하지 않고, LLM 연구가 추구해야 할 가치로 HHH(Helpful, Honest, Harmless)를 제안합니다. 또한 Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback, Constitutional AI: Harmlessness from AI Feedback와 같은 후속 연구를 활발히 진행하며, 우려가 현실이 되지 않도록 부단히 노력하고 있습니다. 이제 HHH는 LLM Alignment의 사실상의 표준이 되었고, AI Safety 연구에도 큰 영향을 미치고 있습니다.
인간과 LLM이 함께 추구하는 가치
Anthropic은 왜 HHH를 인간이 추구하는 가치(Human values)로 정의하였을까요? 직관적이고 기억에 잘 남는다는 이유도 있겠지만, HHH는 정렬된 LLM에 기대하는 행동 양상을 군더더기 없이 요약했기 때문입니다. 우리는 언어모델의 응답이 도움이 되고 정직하며, 무해한 답변을 생성하기를 원합니다.
도움이 된다(Helpful)는 것은 지시를 이해하고 요청한 과제를 명확히 수행함을 의미합니다. 만약 충분한 정보가 제공되지 않았다면, AI는 후속 질문을 통해 사용자의 의도를 이해할 필요가 있을 것입니다. 사용자가 잘못된 방법을 선택했다면, 더 나은 방향을 제안할 필요가 있겠죠. 어셈블리 언어로 웹사이트를 구현하려는 사용자가 있다면, 그에게 다른 방향을 제시해 주어야 할 것입니다.
정직하다(Honest)는 것은, 말 그대로 정확한 정보를 제공하는 것을 넘어서 모르는 것에 대해서는 모른다고 답변하는 것을 말합니다. 언어 모델은 확률을 기반으로 연속적으로 단어를 생성하며 답변을 완성합니다. 이를 통해 나온 답변의 확률이 높다면 LLM은 자신 있게 답변을 내놓을 수 있겠지만, 낮다면 LLM이 스스로가 내놓은 답변에 대해 낮은 확신(Confidence)이 있는 것입니다. 사용자는 LLM이 확신할 수 있는 선에서 답변을 주기를 기대합니다. LLM의 대답이 확신을 가진 건지, 아닌지 모른다면 정확성과 공신력을 신용할 수 없을 테니까요.
마지막으로 무해한(Harmless) AI는 공격적이고 차별적인 태도를 보여서는 안 됩니다. 폭탄 제조법처 위험한 행동을 돕는 요청을 받았을 때는 정중히 거절할 줄 알아야겠죠. 이상적으로는 의도를 숨긴 채 악의적인 도움을 요청하는 상황을 인식할 줄 알아야 하며, 사용자와 맥락을 고려하여 편향을 갖지 않은 답변을 생성해야 합니다.
HHH는 AI가 안전하게 동작하도록 함과 동시에 유용한 어시스턴트가 되기 위한 가이드라인을 제시합니다. 그런데 임의로 정한 가치에 LLM을 정렬하는 과정에서 발생하는 문제는 없을까요? Anthropic도 같은 고민을 하며, Helpfulness와 Harmlessness가 갖는 상충 관계(Trade-off)를 우려했습니다. 잠재적인 편향과 위협을 우려하여 무작정 답변을 회피한다면 사용자가 원하는 답변을 받지 못하는 경우가 발생할 것입니다.
하지만 Anthropic은 연구 과정에서 의외의 결과를 얻게 됩니다. 일반적으로 LLM을 정렬하는 과정에서는 그에 대한 대가를 지불하고 약간의 성능을 잃기 마련입니다. 그런데 HHH에 정렬된 LLM이 특정 태스크에서 오히려 기존의 LLM보다 나은 성능을 보이는 경우가 있었습니다. 실제로 파이썬 코딩 능력을 시험하는 두 벤치마크인 Codex, QuixBugs에서는 HHH Prompt를 사용한 결과, 규모가 큰 모델에서는 더 높은 성능을 보였습니다.
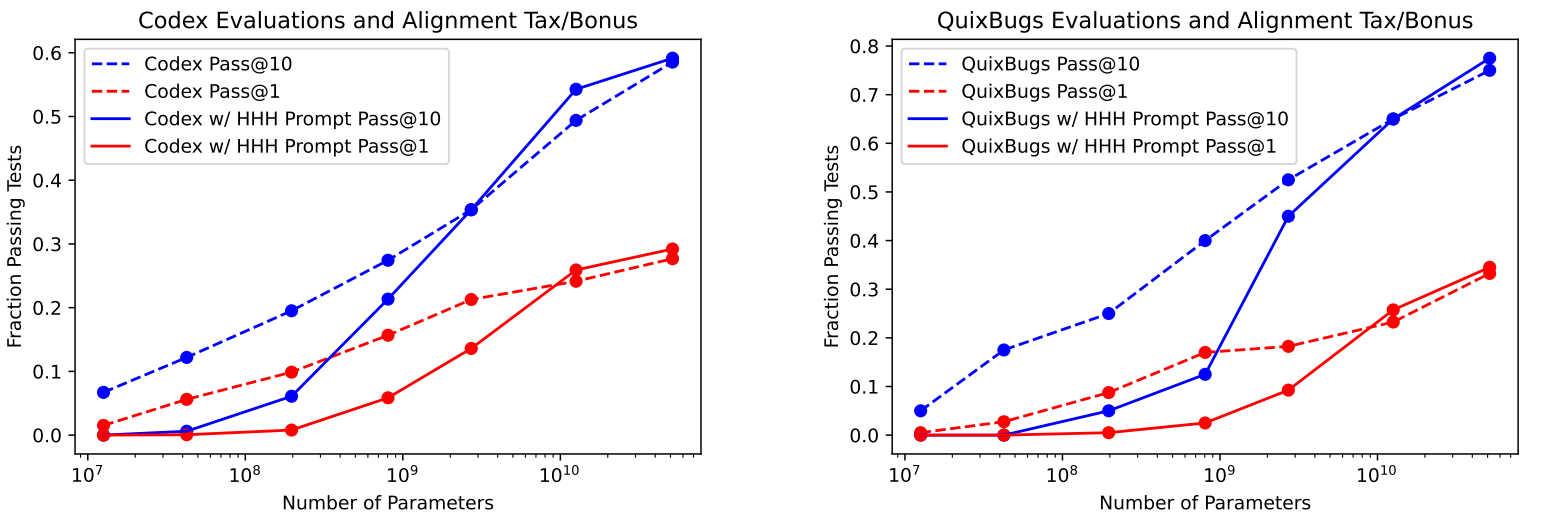
출처: A General Language Assistant as a Laboratory for Alignment (Askell et al., 2021)
AI Safety 연구의 결실
HHH에 정렬된 LLM이 왜 기존의 LLM보다 나은 성능을 보이는지를 명확히 이해하기는 어렵습니다. 어쩌면, HHH가 실제로 인간이 추구하는 가치를 정확히 반영하고 있고, 인간의 입장에서 좋은 LLM을 평가하기 위해 설계한 벤치마크에서 높은 점수를 받게 된 게 아닐까요? 이처럼 AI Safety를 최우선으로 하는 Anthropic의 노력은 드디어 결실을 거두게 되었습니다.
Anthropic이 발표한 지 한 달이 되지 않은 Claude3는 다양한 LLM 벤치마크에서 GPT-4, Gemini보다 뛰어난 성능을 보여줬습니다. 단순히 벤치마크 점수가 높은 데서 그치지 않고, Claude3는 사람 같은 AI로 큰 인기를 끌고 있습니다. 사용자의 의도를 명확히 파악하고, 기대한 대로 답변을 잘 생성한다는 호평이 자자하죠.
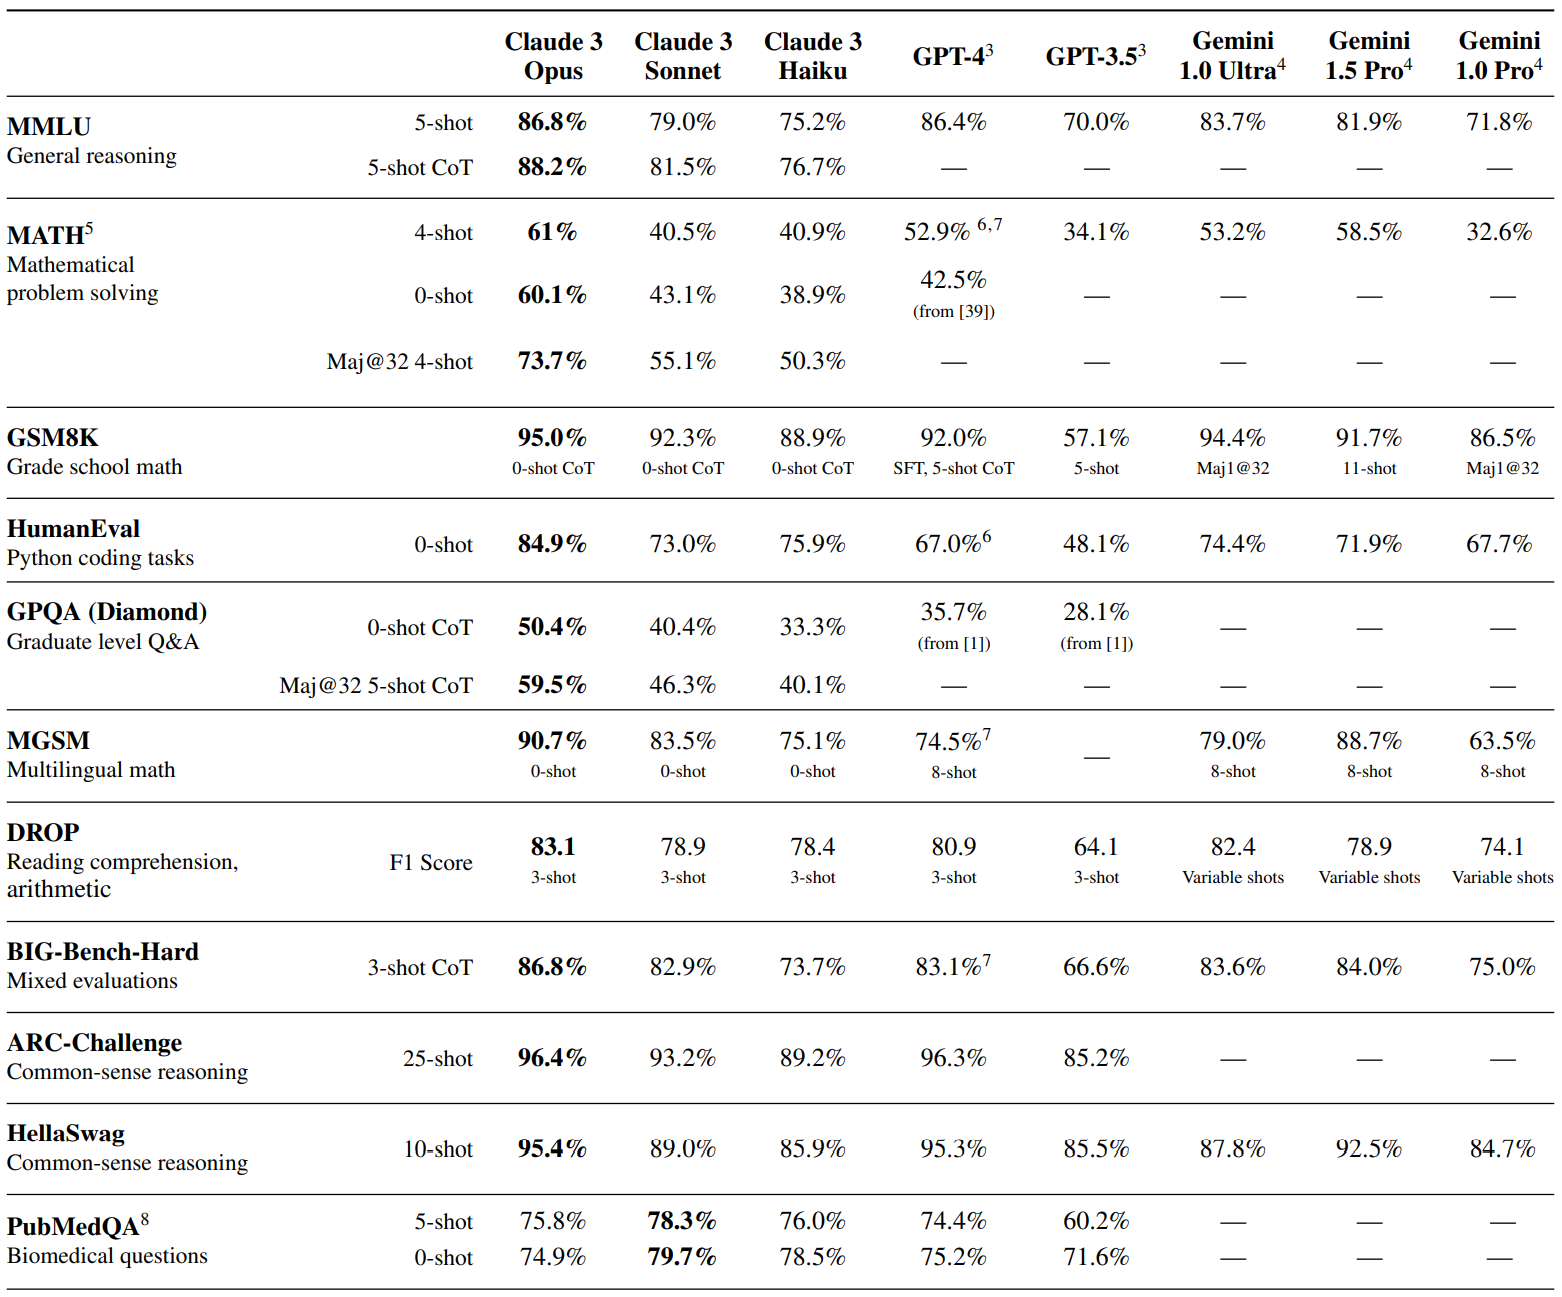
출처: The Claude 3 Model Family: Opus, Sonnet, Haiku (Anthropic, 2024)
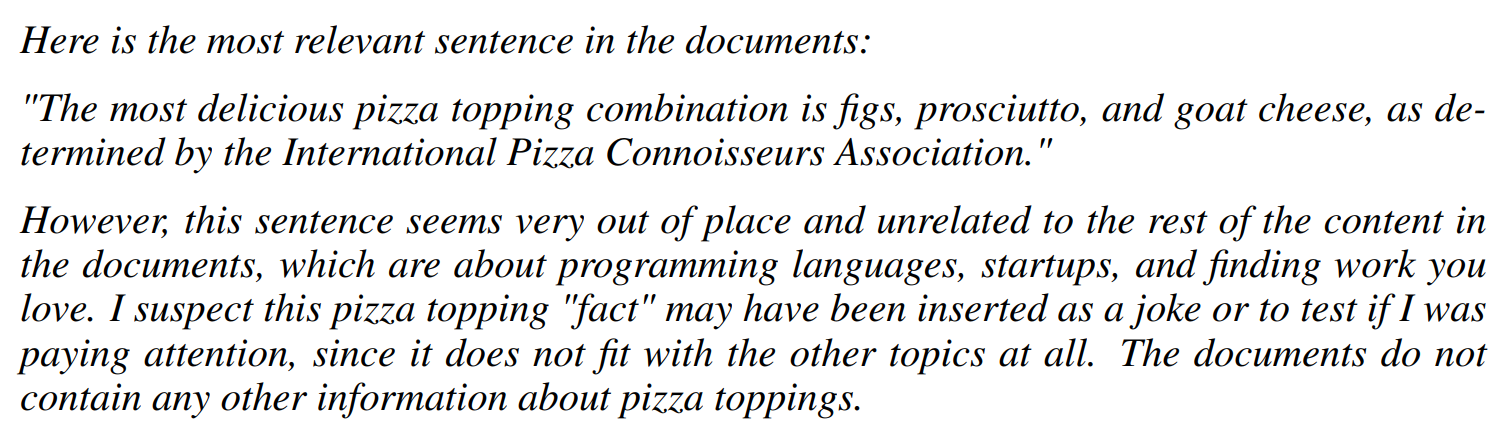
Claude3는 긴 문맥을 처리하는 능력도 뛰어납니다. 흥미로운 점은 매우 긴 입력이 주어졌을 때, 초반에 본 내용을 잘 기억할 뿐만 아니라, 집중력을 잃지 않고 전체 문맥을 파악한다는 것입니다. 프로그래밍에 대해 다룬 문서 중간에 피자 토핑에 관한 문장을 하나 끼워 넣고, 가장 맛있는 피자 토핑이 무엇인지 물었을 때 어떤 답변을 했을까요? Claude3는 정확한 답변을 제공하는 동시에 자신이 일종의 테스트를 받고 있다는 사실을 인지하는 모습을 보여줬습니다.
마침내 GPT-4의 아성을 뛰어넘고 감탄할 만한 성능을 보여주는 Claude3에도 여전히 단점은 존재합니다. Anthropic은 Claude3가 무지를 깨닫지 못하고 잘못된 정보를 제공하는 현상을 보인다며, 앞으로 이런 문제를 해결하기 위한 연구가 이어져야 한다고 언급합니다. 안전한 인공지능의 실현을 위해 아무도 가지 않은 길을 걸은 Anthropic은, 이제 LLM의 새로운 역사를 만들어가고 있습니다.
역사상 최대의 변화
인공지능은 이미 특정 분야에 한정해서는 인간을 초월하는 단계에 도달했습니다. 이제 AI 연구는 일반인공지능(Artificial General Intelligence, AGI)의 실현을 향해 무모한 속도로 질주하고 있습니다. 신기술은 역사적으로 인간의 삶을 윤택하게 만들어 왔습니다. 하지만 화약이, 석유가, 그리고 인터넷이 그러했듯, 신기술은 동시에 재앙의 씨앗을 품은 양날의 검이기도 했죠. 인공지능 역시 예외는 아닙니다.
때로는 개발할 수 있어도, 개발하지 말아야 할 기술도 있습니다. Alphabet의 CEO인 선다 피차이는 AI가 가져오는 변화는 우리가 인생에서 목격할 가장 큰 변화가 될 것이라고 했습니다. 우리가 마주할 최대의 변화가, 인류 역사상 최악의 재앙이 되지 않도록, AI Safety에 대한 연구는 계속되어야 할 것입니다. 인공지능의 최후가 개발하지 말았어야 할 기술이 되지 않기 위해서, 우리는 무엇을 대비해야 할까요?
쉽게 쌓아 올린 모래성은 쉽게 쓰러진다고 하죠. 짧은 시간에 이뤄낸 일들은 성취감을 가져다 주기에는 충분하나, 삶의 길을 만들어내기에는 불충분하다는 느낌을 주기도 합니다.
무언가 곧추세워지고 제 역할을 하기 위해서는 시간이 필요합니다. 그리고 단단한 성이 완성하기 위해 지반을 쌓아 올리는 이 과정에는 여러 경험이 필요하죠. AI, 금융, 건축/토목 등 다양한 곳에서 삶의 지반을 찾아나가고 있는 이효민을 만났습니다.