
A/B Test용 제목 잘못된 과녁을 향하는 화살
인생은 시험의 연속이라고 하죠. 왜 우리는 고통스러워하면서도 끊임없이 시험을 치르고, 자신의 위치를 확인하고 싶어 할까요? 어쩌면 이건 무엇이든 줄 세우고 비교하기를 좋아하는 인간의 습성에서 기인한 것일지도 모릅니다.
올려다본 하늘에 펼쳐진 별들의 밝기를 비교하고, 숨 가쁘게 땅을 박차고 결승선을 통과한 뒤에는 남들보다 얼마나 빨리 달렸는지 확인합니다. 어쩌면 인간이 무언가를 묘사하는 데 사용하는 모든 말은 결국 비교를 위한 게 아닌가 싶기도 합니다.
인간의 손에서 탄생한 인공지능도 이런 운명을 피할 수는 없습니다. ChatGPT 탄생 이래 전 세계를 뜨겁게 달군 언어 모델의 열기는 아직 식지 않고 있습니다. 연일 새롭게 등장하는 인공지능 모델 또한 각자의 우수함을 증명하기 위해 끊임없는 평가를 받습니다. 그리고 연구자들은 항상 좋은 LLM을 만들기 위해서 노력하죠.
내가 아니라 시험이 잘못된 거 아니야?
Open LLM Leaderboard에는 누구나 사용할 수 있도록 공개된 LLM의 순위가 매겨져 있습니다. 거대 기업이나 연구소가 아닌 경우, 비용 문제로 인해 자체적으로 LLM을 개발하기가 어렵습니다. 그래서 여건이 되는 일부 조직에서는 개발한 모델을 공개하여 업계의 주목을 받고, 작은 규모의 기업이나 개인은 공개된 모델을 사용합니다.
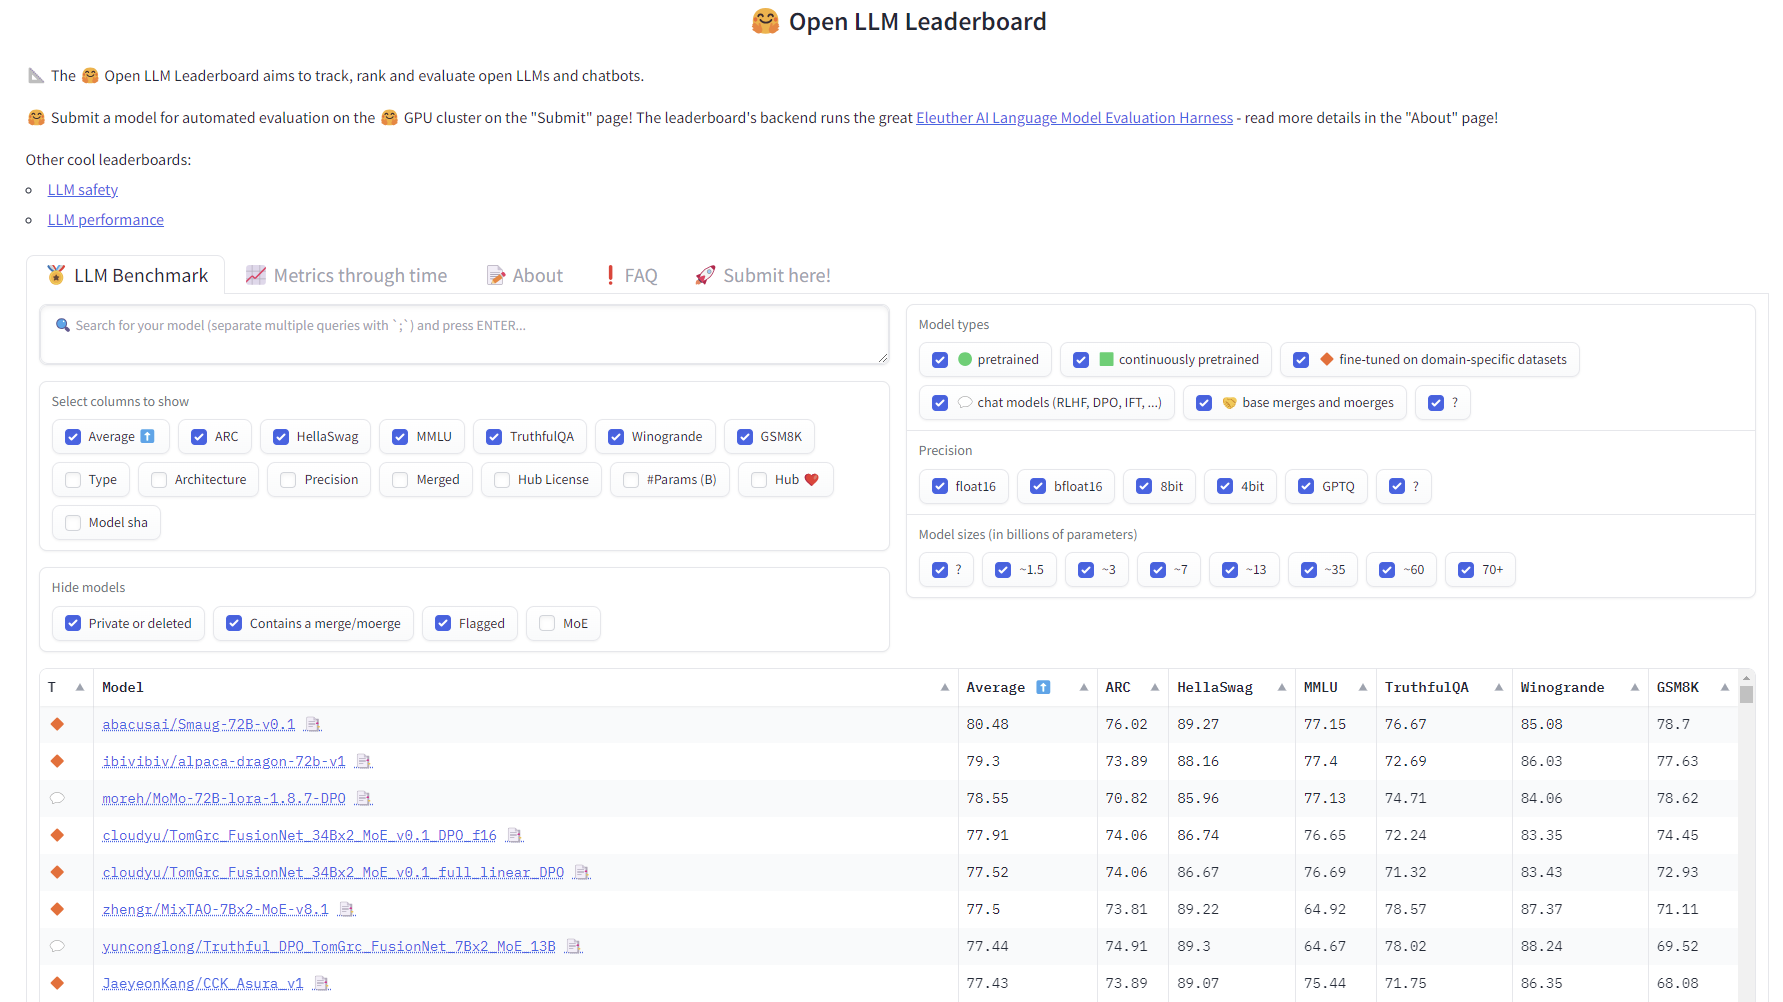
문제는 LLM 학습에 드는 비용 못지않게, 운용하고 배포하는 비용도 만만치 않다는 것입니다. 그래서 사용할 모델을 최초에 잘 선택하는 것이 매우 중요합니다. LLM의 순위가 필요해지는 순간이죠. 비용 문제를 고려할 수밖에 없는 상황에서는 각각의 LLM이 어떤 문제를 특히 잘 푸는지, 일반적인 성능은 어떠한지를 미리 파악해야 합니다. 그래서 리더보드를 잘 살펴보고 좋은 LLM을 선택해야 합니다.
그런데 좋은 LLM이란 무엇일까요? 높은 벤치마크 점수를 받고 리더보드 상위권에 위치했다고 좋은 LLM이라고 단정 짓기는 어렵습니다. 좋은 LLM이라는 표현은 상당히 추상적입니다. 끊임없이 시험을 보고 평가를 받다가 문득 이런 생각도 듭니다. “만약 시험이 잘못 설계되어 있다면? 시험 성적이 정말 다라고 할 수 있을까?” 언어 모델의 관점에서는, 높은 벤치마크 점수가 인간이 기대하는 수준의 작업 성능을 갖추었음을 의미할까요?
그런데 이런 의문은 시험에 지친 누군가의 단순한 투정이 아니었을지도 모릅니다. 사우디아라비아의 국립 AI 연구 기관인 NCAI에서 발표한 논문 When Benchmarks are Targets: Revealing the Sensitivity of Large Language Model Leaderboards는 현재 널리 사용되고 있는 LLM(대규모 언어 모델) 평가의 적절성에 대한 의문을 제기합니다.
벤치마크가 목표가 될 때
현재 LLM을 평가하는 일반적인 방법은 MCQ(Multiple Choice Questions, 선다형 문제)를 사용하는 것입니다. MCQ를 사용한 평가는 직관적이며, 자동화될 수 있고, 정량화가 가능합니다. 대표적인 LLM 평가 벤치마크인 MMLU도 선다형 문제로 구성되어 있습니다.
하지만 MCQ를 사용한 방식에 대한 문제점은 계속해서 지적되었습니다. 최근 이루어진 두 연구(Zheng et al., 2023; Pezeshkpour and Hruschka, 2023)에서는 선택지의 배치 순서에 따라 LLM의 성능이 크게 좌우될 수 있으며, 모델이 특정한 토큰에 편향을 갖기도 한다고 언급하였습니다.
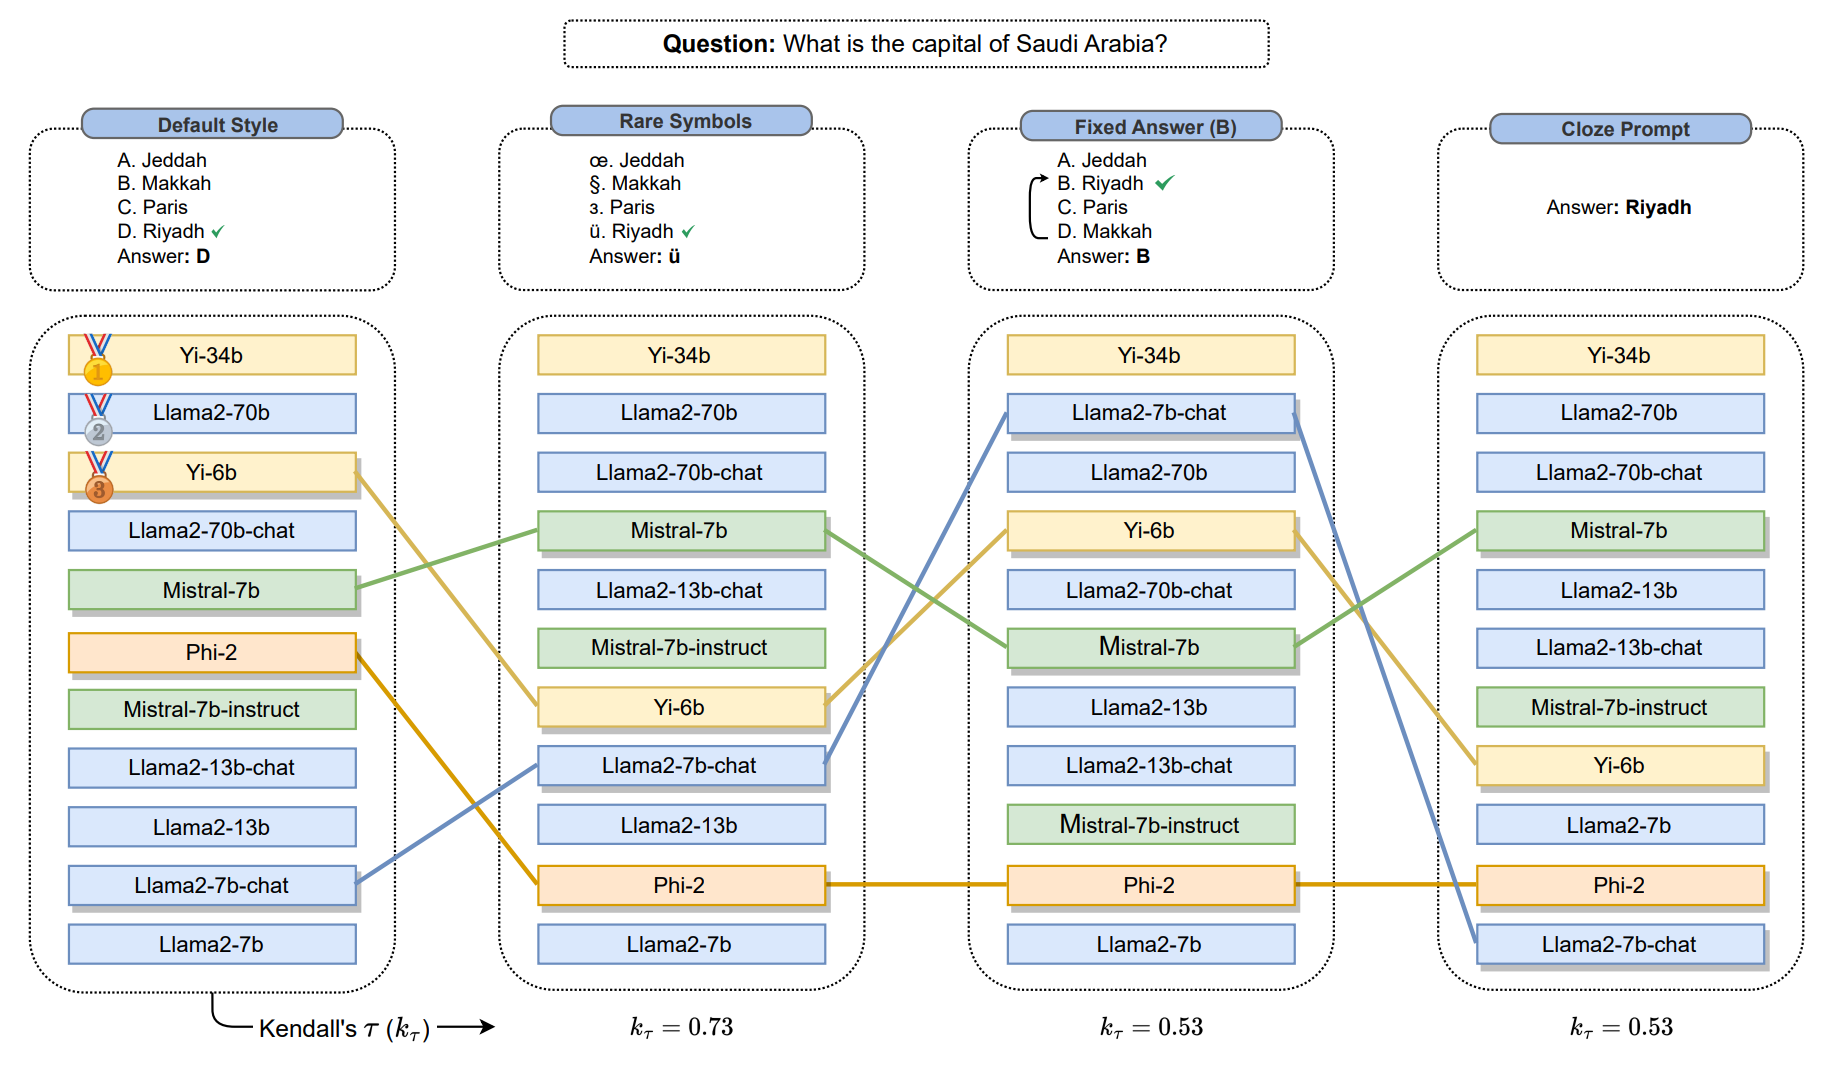
이 논문에서는 기존의 두 연구를 확장하여, 벤치마크의 미세한 변동(Perturbation)이 LLM의 성능에 미치는 영향을 분석합니다. 아래 그림에는 LLM 평가 방식이 변화함에 따라 리더보드의 순위가 어떻게 바뀌는지를 나타냅니다. 이 중 LLama2-7b-chat 모델은 평가 방식에 따라 순위가 8위나 오르는 결과를 보이기도 합니다.
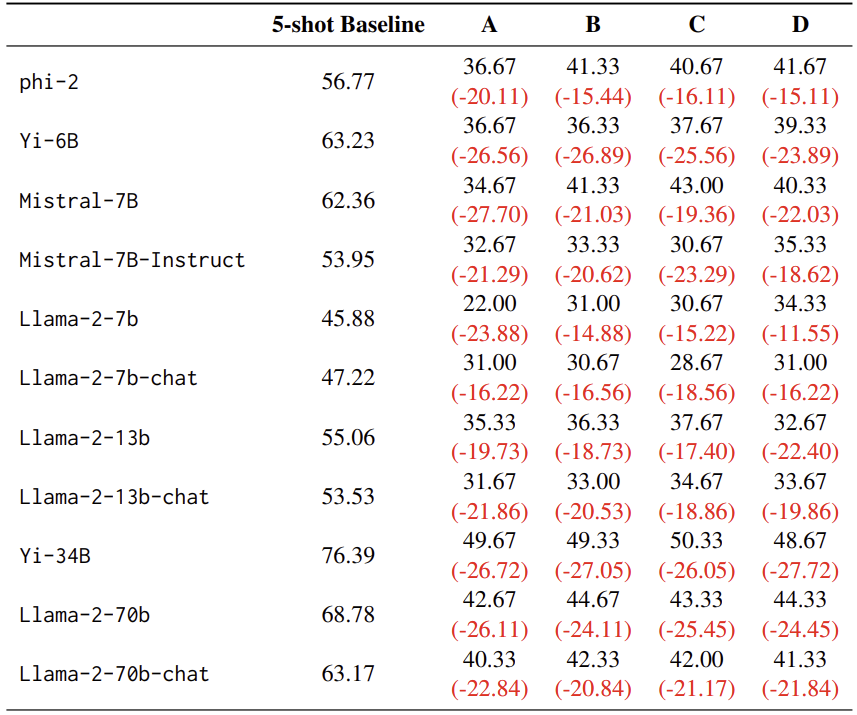
조금 더 구체적으로 살펴보겠습니다. 논문에서는 먼저 MCQ에 주어진 선택지의 배열을 바꾸는 방법을 시도합니다. 주어진 선택지를 임의로 섞었을 때는 모델의 답변 정확도가 최대 9.68점 하락하였고, 정답을 4개의 선택지 중 하나로 고정한 경우에는 답변 정확도가 아래 표와 같이 무려 30점 가까이 떨어지기도 하였습니다. 이처럼 벤치마크 문항에서 발생한 특정한 패턴은 편향을 유발하여 모델이 정답을 내는 데 방해가 되기도 합니다.
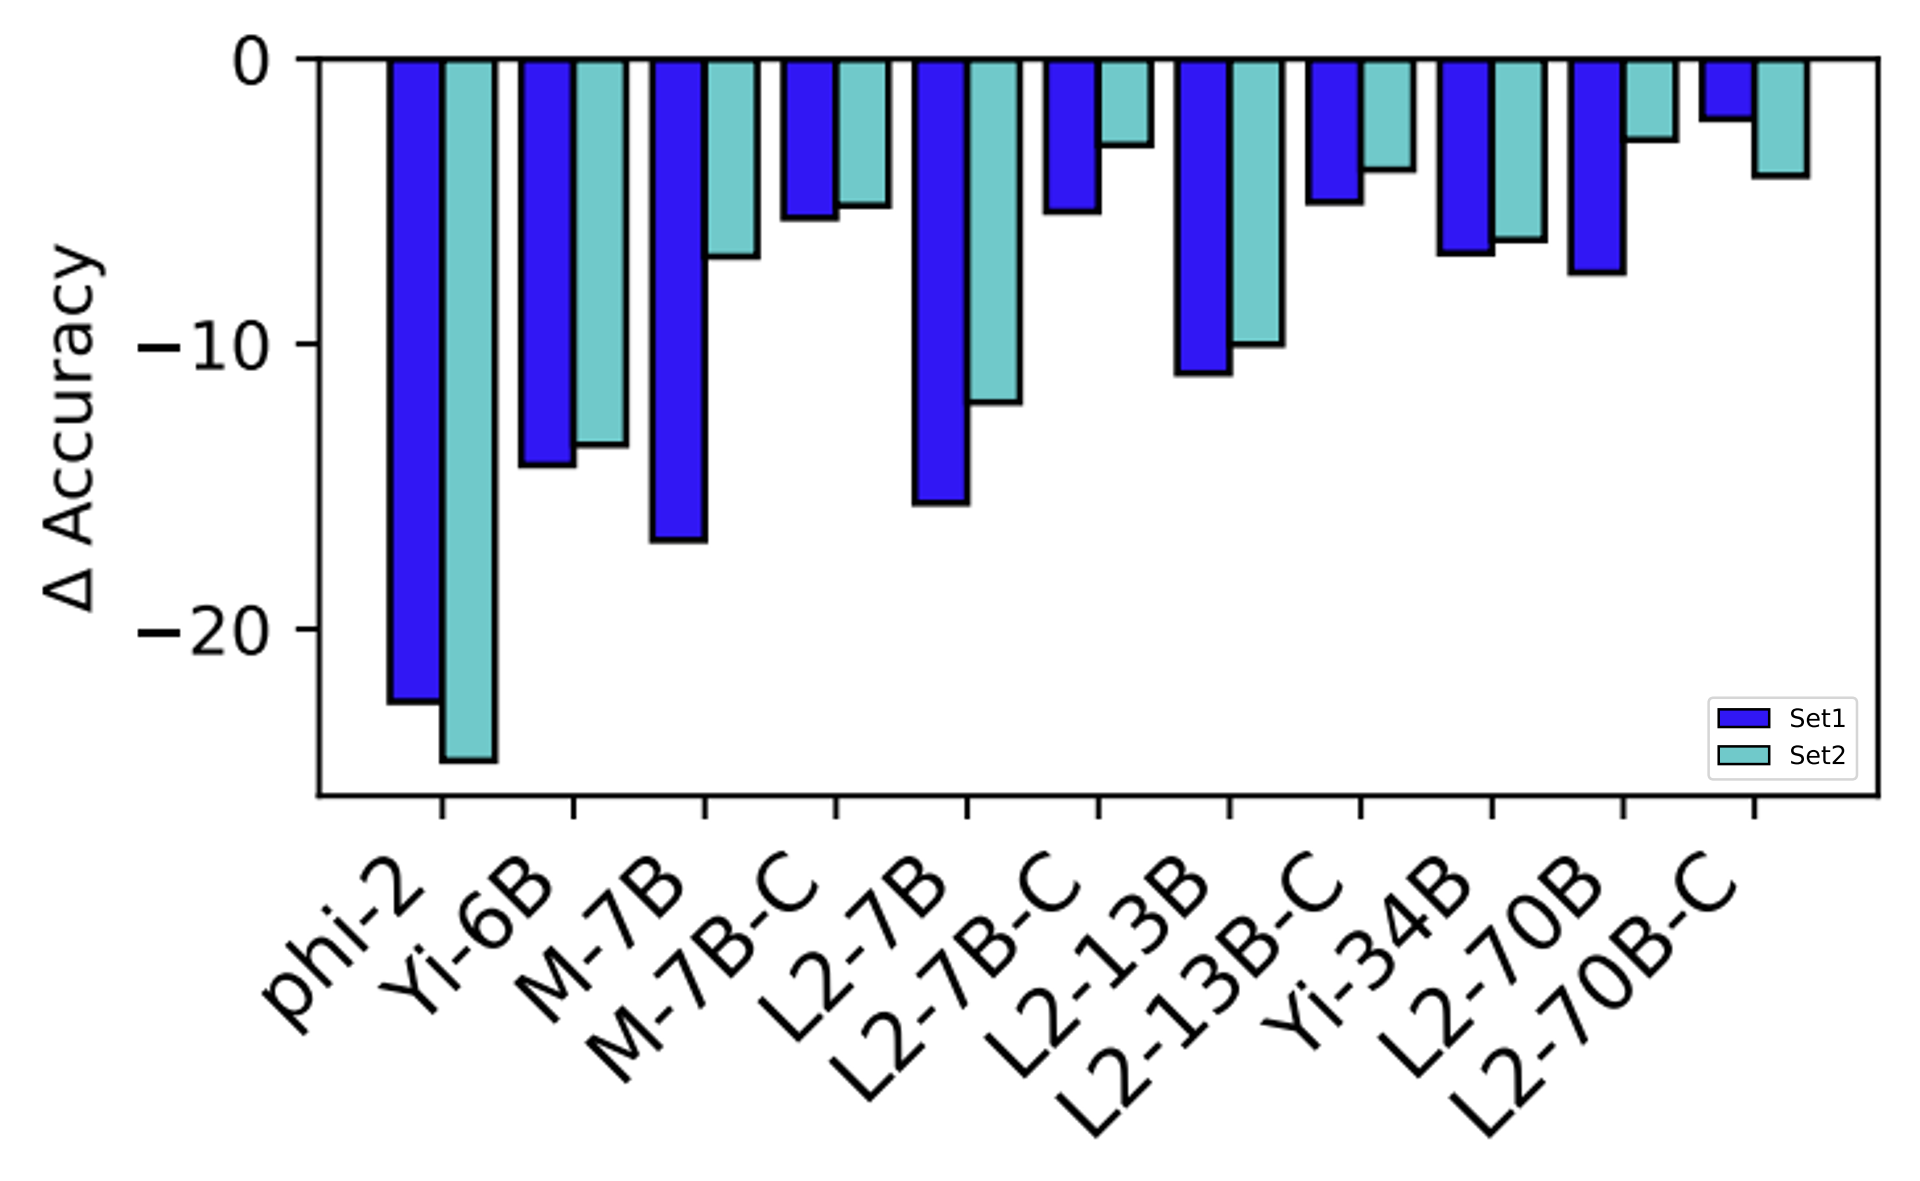
이어지는 실험에서는 기존에 선택지로 사용된 토큰인 A, B, C, D를 다른 토큰으로 대체한 결과를 분석하였습니다. Set1에서는 $, &, #, @와 같이 특정 언어와 독립적인 토큰을 사용하였고, Set2에서는 œ, §, Ze (키릴 문자), ü와 같이 매우 드물게 사용되는 토큰을 사용하였습니다. 결과는 아래와 같이 모든 경우에 모델 성능이 하락하였습니다.
시험이 아니라 내가 잘못된 건가?
논문에서 보인 바와 같이 벤치마크의 미세한 변화에도 모델의 성능은 크게 달라집니다. 선택지의 배열을 바꾸고, 사용한 기호를 변경하는 것은 일반적으로 생각했을 때 결과에 영향을 미치지 않아야 합니다. 그런데도 불구하고 리더보드의 순위가 크게 바뀌었다는 건, 현재의 모델 평가 방식이 공고(Robust)하지 못함을 의미합니다.
반대로 시험 문제의 작은 변화에도 크게 흔들릴 정도로 처음부터 학습 방식이 잘못되었을지도 모른다는 의문이 들 수도 있습니다. 물론 실험의 해석은 관점에 따라 다르게 이루어질 수 있습니다. 하지만 평가 방식이 우연에 의해 편향을 학습한 모델에게 이점을 가져다주도록 설계되었다면, 과연 그 방식에 문제가 없다고 할 수 있을까요?
다시 한번, 좋은 LLM이란?
현재 언어 모델이 경쟁적으로 쏟아져 나오고 있는 상황에서, 어떤 모델이 좋은 것인지, 무엇이 내게 필요한지를 결정하기는 매우 어렵습니다. 모든 연구에서는 자신이 출시한 모델을 최고로 여기며 기존에 출시한 모델들과 비교한 성능을 과시하죠. 하지만 만약 언어 모델의 성능을 잘못 측정하고 있다면 어떤 기준에서 그들을 비교해야 할까요? 애초에 모든 LLM을 공정하게 평가할 수 있는 일관된 기준을 세울 수가 있을까요? 적어도 아직은 그렇지 않아 보입니다.
언어 모델은 이제 다양한 작업을 높은 수준으로 수행할 수 있는 제너럴리스트(Generalist)가 되었습니다. 이 논문에서는 이들의 좋고 나쁨을 가릴 방법을 제시하지는 않습니다. 하지만 LLM 연구가 나아가야 할 방향이 무엇인지는 분명히 재고해 봐야 합니다. 그렇다면, 좋은 LLM이 만들어지기 위해서, 연구에서 추구해야 할 가치는 무엇일까요?