
인공지능이 인간처럼 세상을 바라본다면?
안녕하세요, 에디터 ARI입니다.
에디터 ARI로서는 처음 인사드립니다. 여러분께 뉴스레터를 전하게 됐는데요. 1년이 넘는 시간동안 deep daiv.에 몸 담으며 얻었던 지식과 인사이트를 함께 나누고자 합류하게 됐습니다. 비즈니스 미디어에서 활동했던 경험을 발판 삼아, 앞으로 좋은 콘텐츠를 전하기 위해 노력하겠습니다.
요즘 인공지능 업계의 화두는 단연코 영상 생성입니다. 지난달 15일, ChatGPT로 전 세계를 놀라게 했던 OpenAI가 영상 생성 모델 Sora를 공개하며 또 한 번의 지각변동을 일으켰기 때문인데요. 타이핑 몇 번으로 고화질 영상을 만들 수 있다는 사실은 수많은 AI 연구자와 영상 업계에 긴장감을 조성하고 있죠.
하지만 AI로 영상을 만든다는 건 새로운 개념이 아닙니다. 런웨이의 Gen2나 구글의 VideoPoet, StabilityAI의 Stable Diffusion 등 시장에는 이미 영상 생성 모델이 쏟아져 나오고 있었습니다. 사실 Sora가 공개된 당일에도 새로운 영상 모델이 또 하나 공개됐었는데요. 바로 Meta의 V-JEPA입니다. 영상을 만들어낸다는 점에서 언뜻 Sora와 비슷해 보이지만 두 모델은 완전히 다른 노선을 취하고 있는데요.
얀 르쿤이 말하는 지능의 의미
OpenAI를 비롯해 많은 연구자는 모델의 크기가 커지면 예상하지 못했던 질적인 변화, 즉 창발(Emergence)이 일어난다고 믿습니다. 충분히 거대한 모델을 만들면 처음 본 문제도 해결하는 능력이 자연스럽게 나타난다는 것입니다. 실제로 CoT(Chain of Thought)와 같은 방법론의 존재는 거대 언어 모델이 꽤나 좋은 추론 능력을 갖추고 있음을 증명하는 것 같은데요. 얼마 전 Sora의 등장으로 이러한 창발 능력이 언어뿐만 아니라 이미지나 비디오 영역으로도 확장될 수 있음을 보여주고 있죠.
🙏
하지만 Meta의 수석 연구원 얀 르쿤은 정반대의 생각을 가지고 있습니다. 지금의 LLM이 도달한 지능은 그다지 좋지 않은 수준이며, 적어도 오늘날의 인공지능으로는 아무것도 발명(Invent)할 수 없다고 이야기합니다. 그보다는 자신의 ‘세계 모델(World model)’로 인공지능을 이해하고자 하는데요.
얀 르쿤은 사람을 포함해 동물의 뇌가 세상에 대해 일종의 시뮬레이션을 실행한다고 믿습니다. 시뮬레이션은 상황과 관련된 추상적인 정보에 대해서만 일어나며, 이를 학습하면 현재 상황을 인식하고 다음 상황을 예측하는 능력인 ‘상식’을 얻습니다. 우리가 상식을 가질 수 있는 이유는 유아기에 이를 충분히 학습했기 때문이며, 상식이 바로 지능의 본질이라는 것이죠.
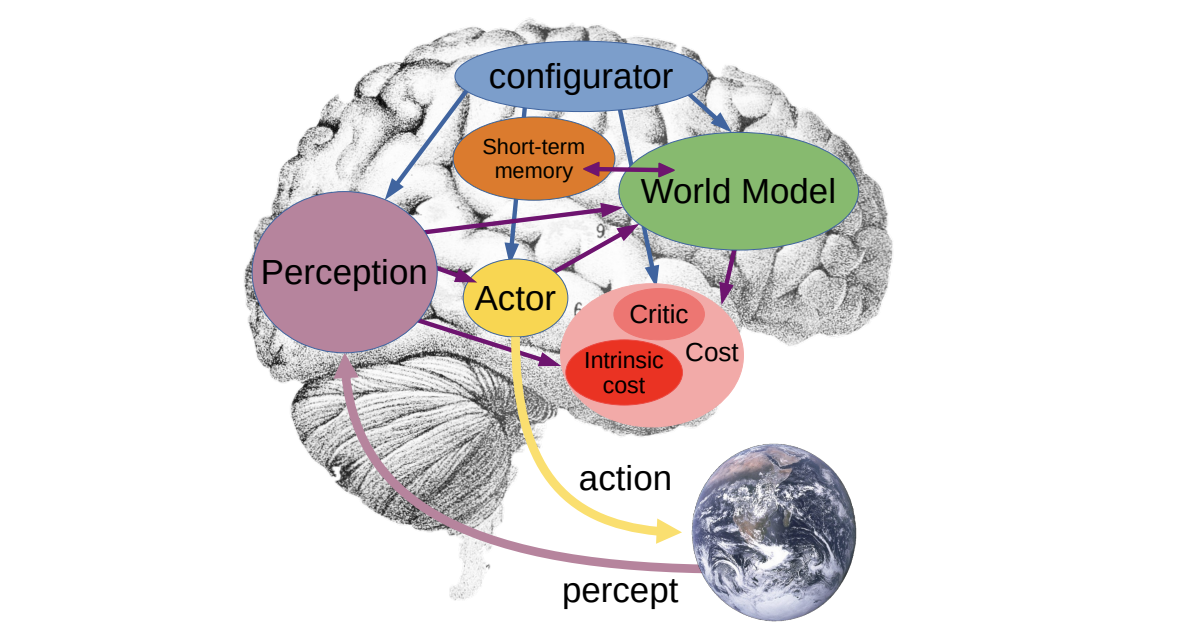
출처: A Path Towards Autonomous Machine Intelligence (Yann LeCun, 2022)
지금의 인공지능이 동작하는 방식은 이와 반대입니다. 예를 들어, 책상 모서리에 펜이 아슬아슬하게 걸쳐져 있고, 펜의 중심이 흔들리는 모습을 사람이 보고 있다고 가정해 봅시다. 책상 주변에 얼마나 많고 다양한 종류의 사람·사물이 있던 그것은 ‘책상이 흔들려서 펜이 떨어진다’는 상황을 직관하는 데 필요하지 않습니다. 즉, 펜이 떨어지는 ‘장소’ 자체를 완전히 묘사하지는 않는 것이죠. 그렇기 때문에 얀 르쿤은 사람은 그저 ‘펜이 곧 바닥에 떨어질 것이다’라는 추상적인 원칙을 예측할 뿐이라고 주장합니다.
하지만 인공지능은 다릅니다. 사람은 펜이 정확히 어디에 떨어지는지 따위를 생각하지 않지만, 오늘날의 딥러닝 모델은 장소 자체를 정확히 묘사하는 데 집중하죠. Sora와 같은 ‘생성형’ 인공지능이 동작하는 방식입니다.
결국 얀 르쿤은 이를 비판하며 인간의 상식과 딥러닝을 결합하는 방법을 찾아냅니다. 그것이 세계 모델 이론을 바탕으로 한 JEPA(Joint-Embedding Predictive Architecture) 구조인데요. 이 JEPA의 아이디어를 이미지에 담은 I-JEPA가 지난해 6월, 비디오에 담은 V-JEPA가 지난 2월에 공개된 것입니다.
JEPA가 모방하는 세계
I-JEPA와 V-JEPA를 관통하는 JEPA 구조는 SSL(Self-Supervised Learning) 학습 방법을 사용합니다. 픽셀 하나하나에 집중하는 것이 아니라, 이미지의 특정 부분으로부터 추상적인 시각적 표현을 학습하고 예측하는 방법인데요. JEPA는 복잡한 증강(Augmentation)을 사용하지 않은 순수한 정보와 아주 적은 양의 학습만으로도 최고 수준에 준하는 성능을 보였습니다.
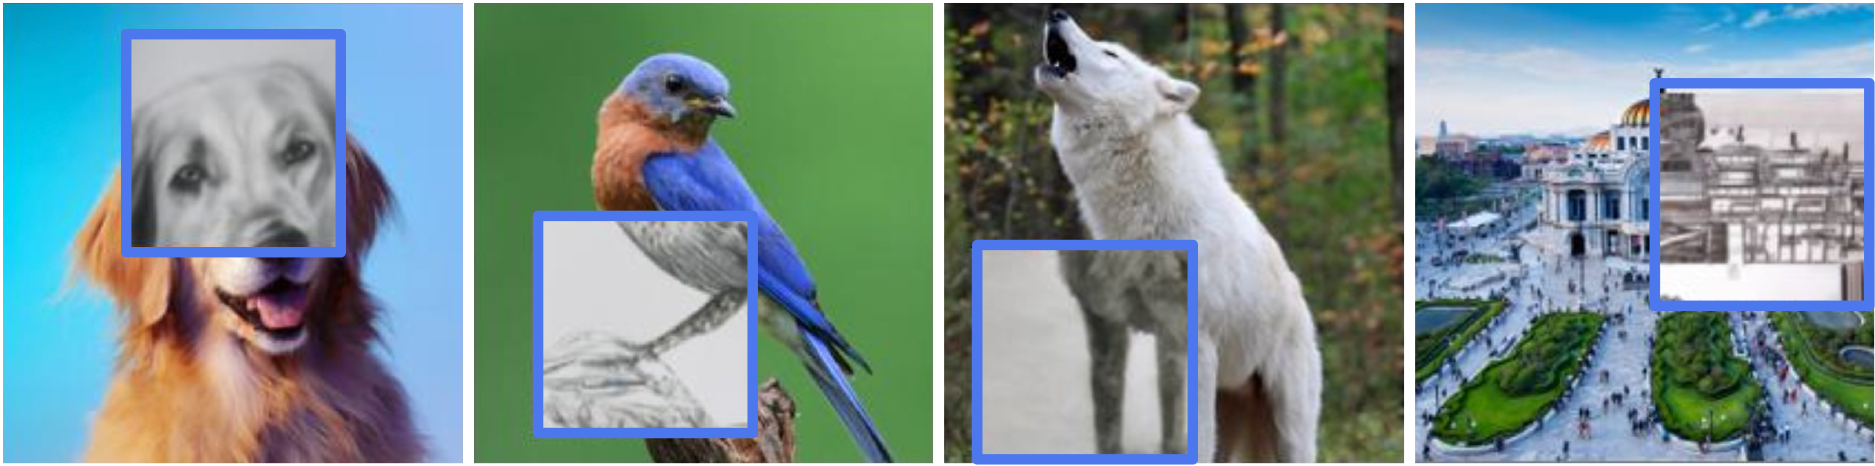
출처: I-JEPA: The first AI model based on Yann LeCun’s vision for more human-like AI (Meta, 2023)
이러한 JEPA 구조를 이미지에 적용한 모델이 바로 I-JEPA(Image-based Joint-Embedding Predictive Architecture)입니다. 아키텍처 안에는 3가지 요소 즉, 어떤 부분을 복원할 것인지 Target, 모델에게 어떤 부분을 보여줄 것인지 Context, 복원을 학습하는 네트워크 Predictor가 존재하는데요. 구체적으로, 패치 형식 4개의 Representation Target과 특정 블록 이외의 영역을 모두 마스킹해서 얻은 Context representation을, Predictor가 비교하며 어떤 부분을 어떻게 복원해야 할지 Latent space를 학습합니다.
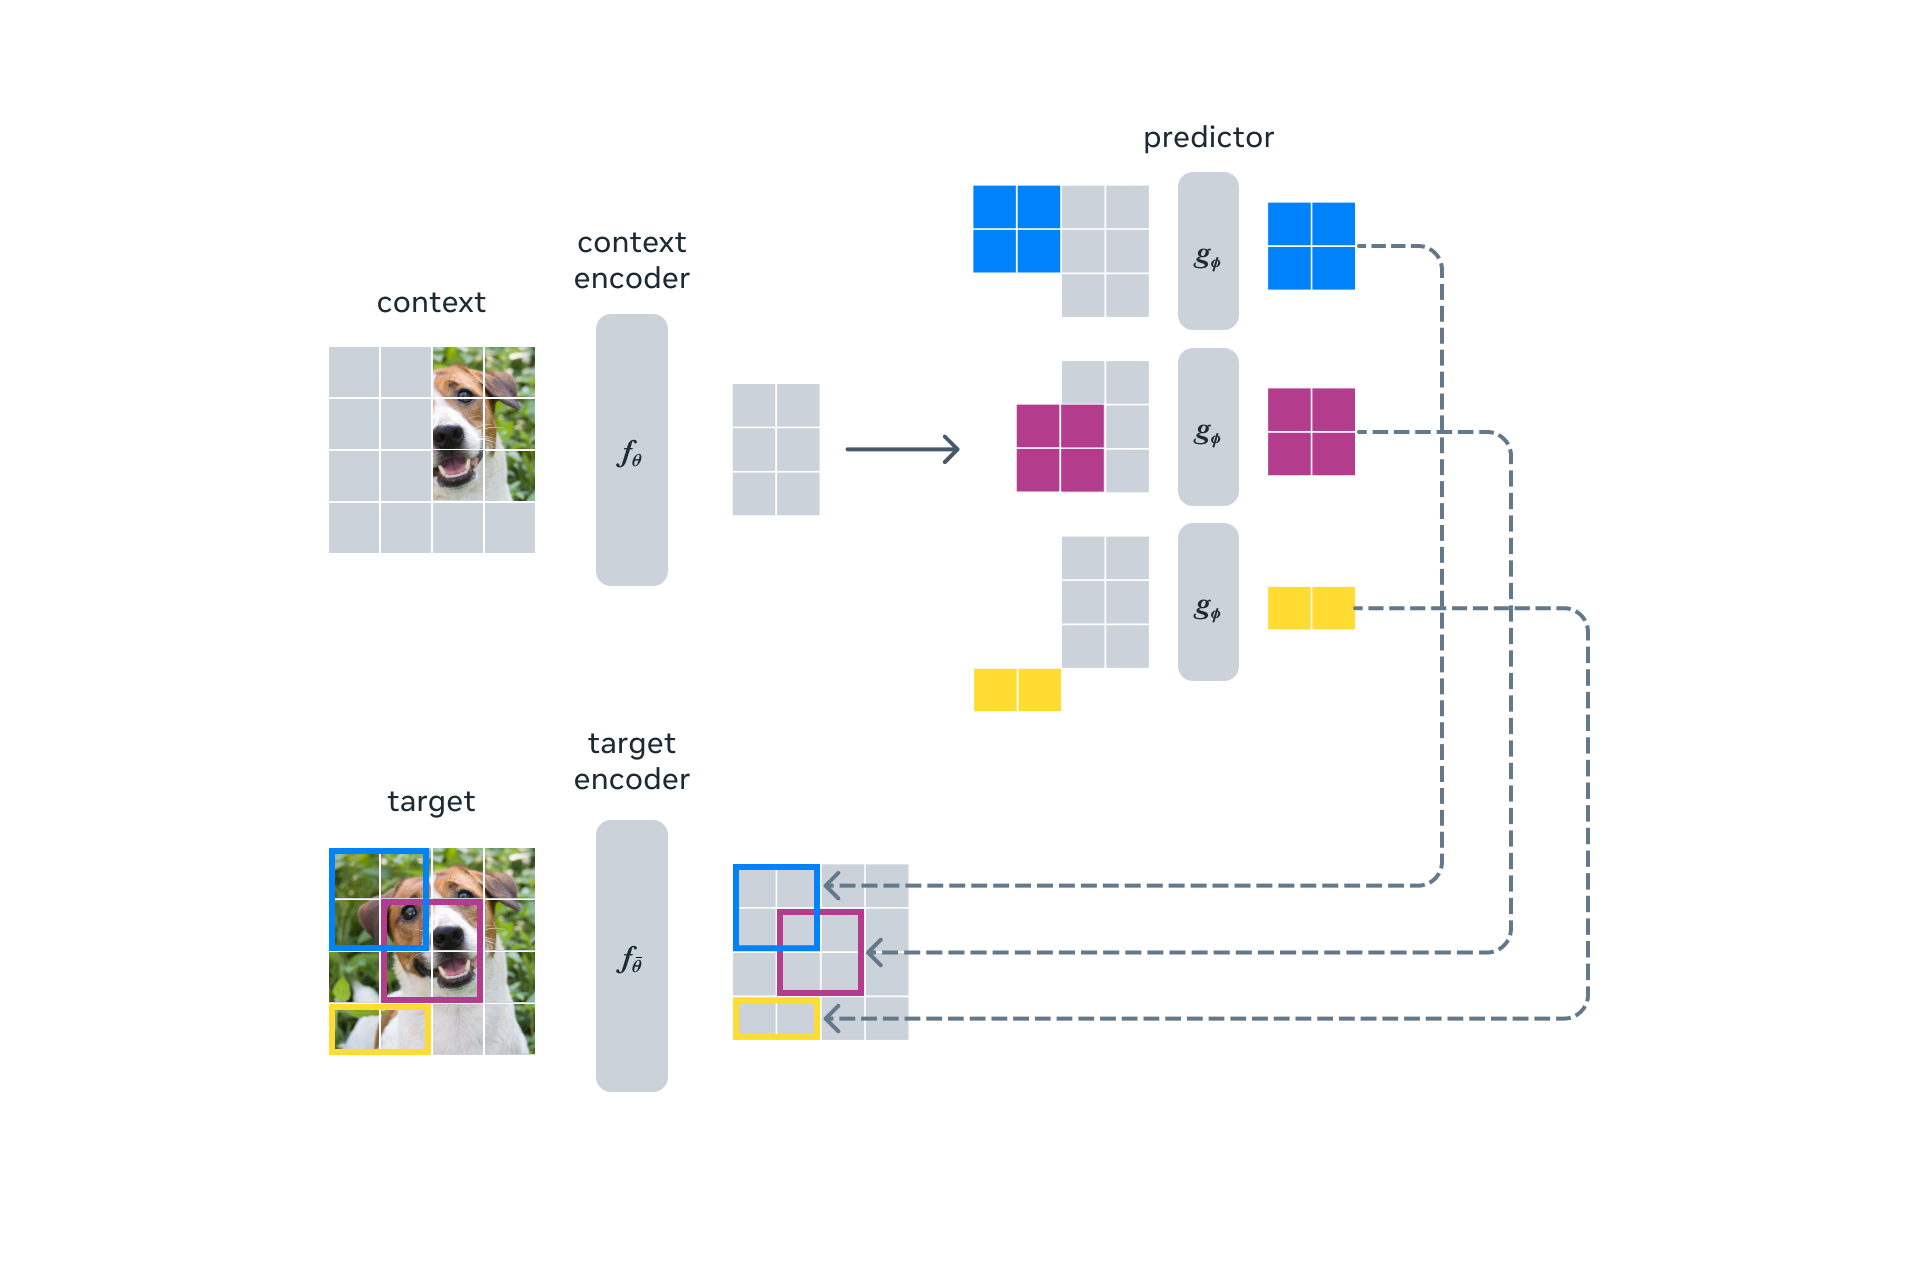
출처: I-JEPA: The first AI model based on Yann LeCun’s vision for more human-like AI (Meta, 2023)
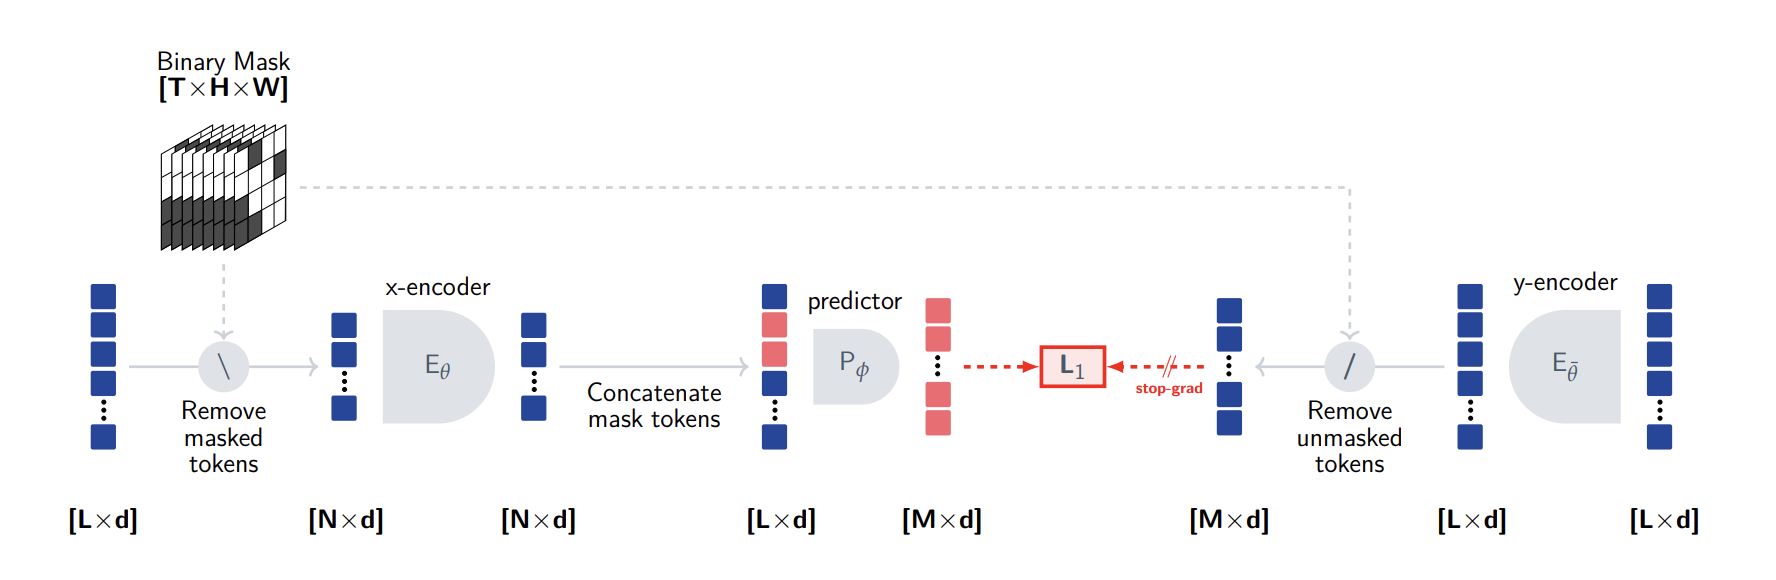
이번에 공개된 V-JEPA에도 이 구조가 그대로 반영됐는데요. 어쩐지 아래의 V-JEPA 구조와 위의 I-JEPA 구조가 상당히 유사해 보이지 않나요? 기존의 I-JPEA가 보여준 아이디어는 픽셀 수준을 벗어나 좀 더 고차원의 의미론적(Semantic) 학습을 하자는 것이었는데요. 기본적인 철학은 유지하되, Meta는 이미지 모델을 영상 모델로 확장하기 위해 마스킹 방법에 심혈을 기울였습니다.
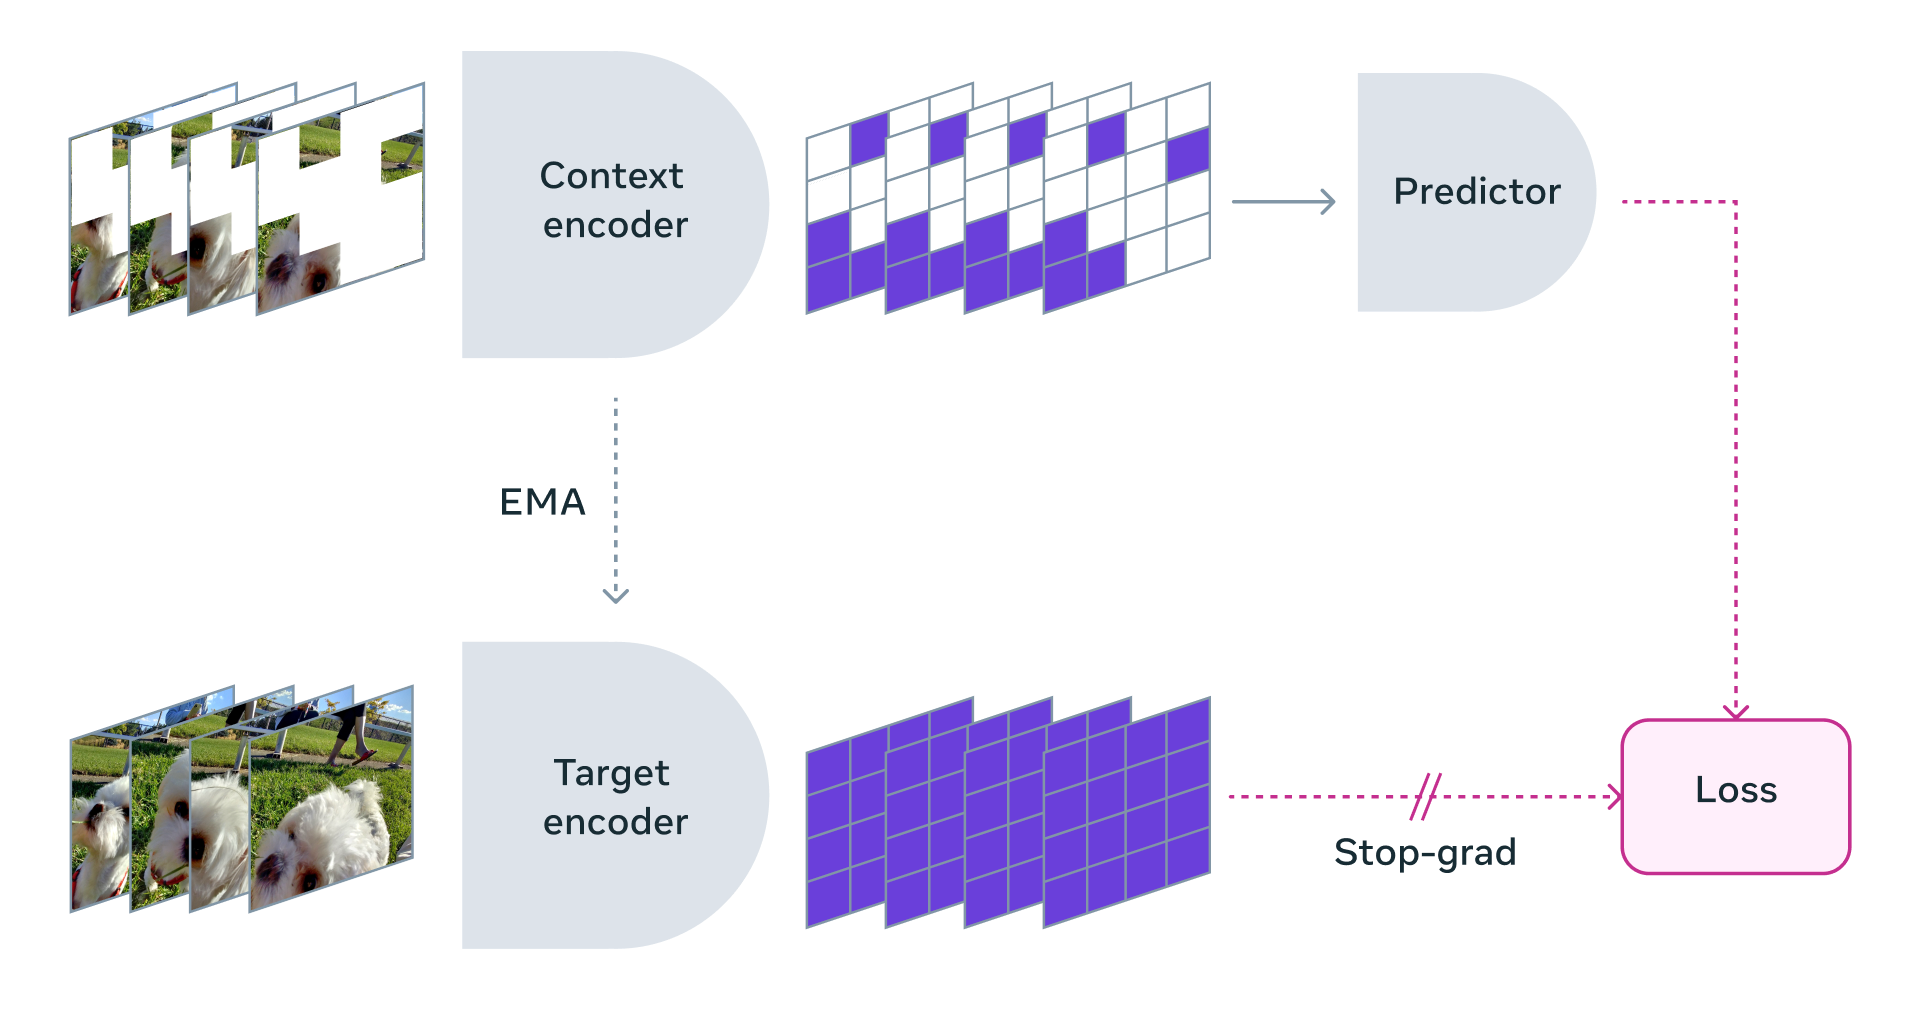
출처: V-JEPA: The next step toward Yann LeCun’s vision of advanced machine intelligence (AMI) (Meta, 2024)
마스킹을 위한 두 가지 원칙이 있는데요. 첫째, 모두 동일한 패치를 마스킹합니다. 모델이 제대로 학습하기 위해서는 학습해야 할 패치를 참고할 수 없도록 구성해야 합니다. 예를 들어, 눈을 Target으로 해 학습을 진행해야 하는데, 이미 Context에 눈에 대한 정보가 있다면 모델에게는 복원이 매우 쉬운 일이 되죠. 추가로 너무 작은 패치만을 마스킹하는 것도 막아야 합니다.
둘째, 시공간을 전부 마스킹합니다. 이미지와 비디오의 가장 큰 차이는 시간에 따른 공간의 변화가 드러난다는 점입니다. 둘 중 하나만 마스킹하거나, 매우 짧은 시간 범위 내에서만 마스킹하는 것도 문제가 됩니다.
이러한 원칙 하에 V-JEPA가 어떻게 설계됐는지 간단히 살펴볼텐데요. T개 프레임의 영상이 있고, 한 프레임 내에는 L개의 토큰이 있으며 그중 M개는 마스킹, N개는 마스킹 되지 않았다고 가정해 보겠습니다. 먼저, Context를 구성하기 위해 N개의 토큰만을 인코더에 넣어 임베딩 벡터로 변환합니다. 그 후 시공간에 대한 정보를 담고 있는 M개의 토큰을 이어 붙여 다시 L개의 토큰을 구성합니다. 이를 Predictor에 넣으면 재구성된 마스킹 토큰 M개가 나오는데요. 이를 Target인 실제 M개의 토큰과 비교하며 그 차이를 학습합니다.
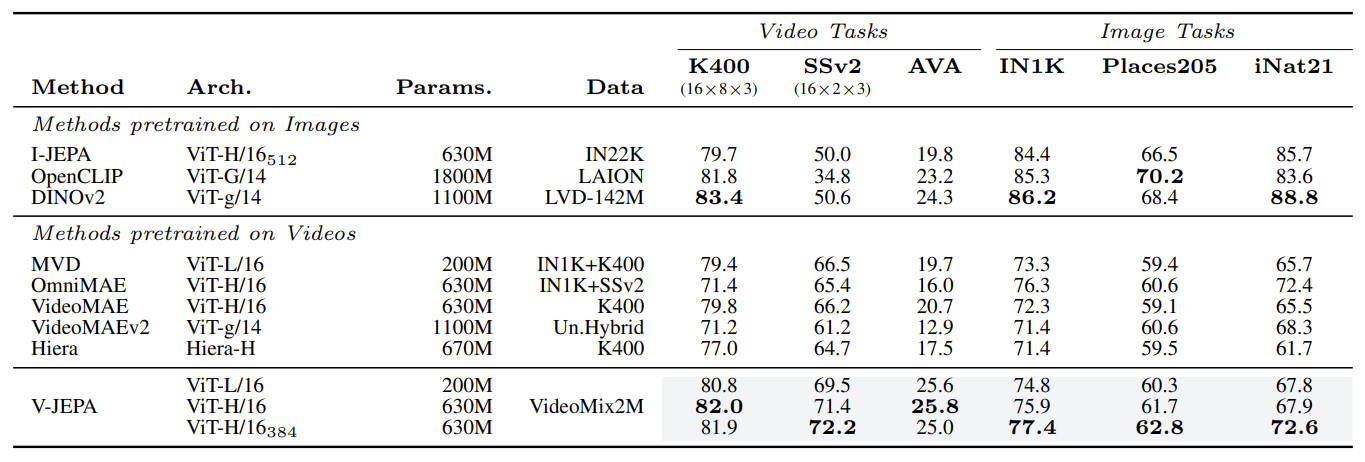
V-JEPA는 영상 태스크에서 상당히 좋은 결과를 보여주고 있는데요. 이미지 관련 태스크에서는 이미지를 위해 설계된 모델인 OpenCLIP, DINOv2에 뒤처지기는 하지만, 비디오 부분에서는 기존의 SOTA 모델에 버금가는 성능을 보여주고 있습니다. 실제로 V-JEPA가 만든 영상을 보면 패치 경계에서 안 맞는 부분들이 있지만, 아래의 상황에서 ‘스케치북을 넘기며 글을 쓴다’는 상황에 매우 걸맞은 영상을 예측하고 있습니다. 게다가 V-JEPA는 효율성이 높다는 평을 받는데요. 예측할 수 없는 부분은 버리면 되기 때문에 모든 픽셀에 힘을 들일 필요가 없습니다. 덕분에 유연성이 높아 훈련 및 샘플 효율성도 1.5배~6배 향상되는 결과를 가져왔죠.
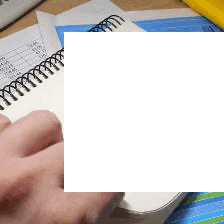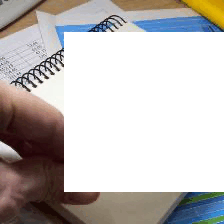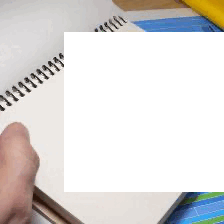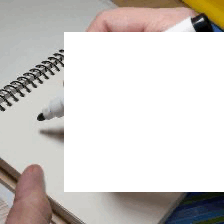
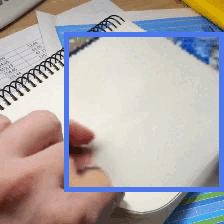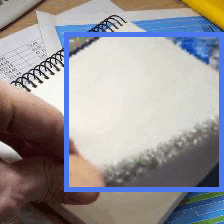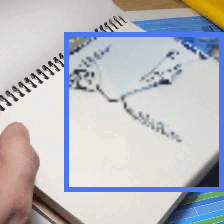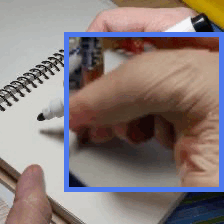
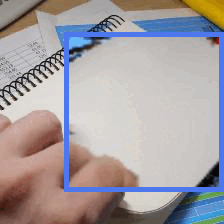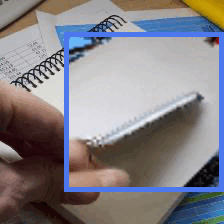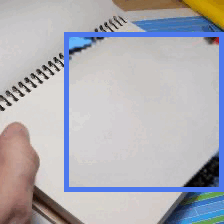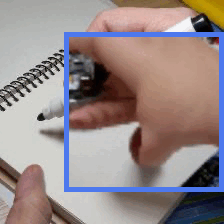
출처: V-JEPA GitHub (Meta, 2024)
ChatGPT로 경험한 인공지능의 세계, 그리고 Sora가 보여준 엄청난 비디오 생성 능력을 보면 거대한 생성 모델이 특정 임계점을 넘어가고 있다는 것을 부정할 수 없습니다. 하지만 얀 르쿤이 말하는 ‘세계 모델’에 따르면 Sora와 GPT 모델로 구성된 오늘날의 AI 시스템은 사람의 지능과는 상당히 거리가 멉니다. 그는 사람의 상식은 엄밀하고 논리적으로 정의될 수 있으며, 모델이 그러한 사고를 최대한 모방할 수 있도록 설계하죠. I-JEPA와 V-JEPA의 꽤나 좋은 성능은 더이상 인공지능의 창발 능력에 기댈 필요가 없음을 보여주는 것 같기도 합니다.
동시에 JEPA의 등장은 사람의 지능이 어떻게 발생하는가에 대한 매우 근원적인 물음을 던집니다. Sora가 보여주는 촘촘한 영상 생성 능력은 분명 놀랍습니다. 몇 번의 텍스트 입력만으로 사람도 곧바로 상상하기 어려운 수준의 결과물을 만들어내죠. 하지만 사람이 아주 자연스럽게 해낼 수 없는 일을 해내는 인공지능을 보고 ‘인간적’이라고 할 수 있을까요? 인간 수준의 사고력을 지향하는 인공지능이, 인간과 다른 방식으로 동작한다면 우리는 인공지능을 어떻게 바라봐야 할까요? 과연 인간의 지능은 어떻게 나타나는 것일까요?
[AI NEWS]
[Subheading 1]
[Subheading 2]
[Subheading 3]
[딥 다이브 소식]
[WIL]
[WIL]
[다만사]
거대한 세계로 나아가는 여정은 언제나 두근거리는데요. 잔뜩 웅크린 몸을 일으켜 익숙한 곳에서 벗어나는 것, 새로운 문화를 받아들이고 새로운 사람을 만나는 과정은, 무엇이든 할 수 있다는 무모한 용기를 쥐여주기도 하죠.
이 용기를 쥔 채로 사람들은 ‘기회의 땅’이라 불리는 곳을 찾아 떠납니다. 연구원이든, 엔지니어이든, 혹은 개발자든, 더 많은 것을 꿈꿔볼 수 있다는 사실이 그곳을 매력적으로 만들죠. 오늘은 미국에 교환학생을 다녀온 후로 실리콘 밸리로의 여정을 준비하는 이원행을 만나보았습니다.