
🐚 Sora
안녕하세요, 에디터 배니입니다.
지난주 목요일(15일) 다시 한번 OpenAI가 세상을 떠들썩하게 만들었습니다. 이미지를 넘어 영상을 생성하는 모델 Sora를 공개했기 때문입니다. 모델이 공개된 지 일주일도 채 지나지 않았지만, 벌써 많은 연구자들과 기업인들이 모델에 대해서 언급하며 기대감을 나타내고 있습니다.
영상 생성, 그중에서도 Text-to-Video 모델이 이번에 처음 공개된 것은 아닙니다. 하지만 Sora는 분명 이전 모델과는 다릅니다. 영상 퀄리티는 차원이 다른 수준이고, 다양한 연출이 가능하며 전문가들도 하기 힘든 영상 합성 기술을 선보이기도 합니다. 백문이 불여일견. 아래 영상을 먼저 보겠습니다.
매머드가 화면을 뚫고 나올 것 같은 기세로 걸어나오는 모습입니다. 매머드의 주름이나 눈보라 치는 모습까지 정말 사실적인데요. 다른 영상들도 마찬가지입니다.
그렇다면 어떤 원리로 이렇게 고퀄리티의 영상을 만들 수 있었을까요? OpenAI는 아직 Sora의 논문을 공개하지 않았습니다. 대신 웹사이트를 통해 기술 보고서(Technical Report)를 공개했는데요. 해당 보고서에는 모델을 어떤 아이디어로 개발했는지 설명돼 있습니다. 이번주 뉴스레터에서는 기술 보고서를 토대로 Sora를 살펴보도록 하겠습니다.
Sora는 어떻게 ‘실제 세계’의 영상을 만들 수 있었을까?
OpenAI가 발간 Sora의 기술 보고서는 Video generation models as world simulators 입니다. 기술 보고서에 따라 Sora의 구조를 살펴보면 다음과 같습니다.
그리고 여기에는 다양한 학습 아이디어들이 녹아들어 있는데요. 하나씩 살펴보도록 하겠습니다.
- 영상 압축(Video Compression)
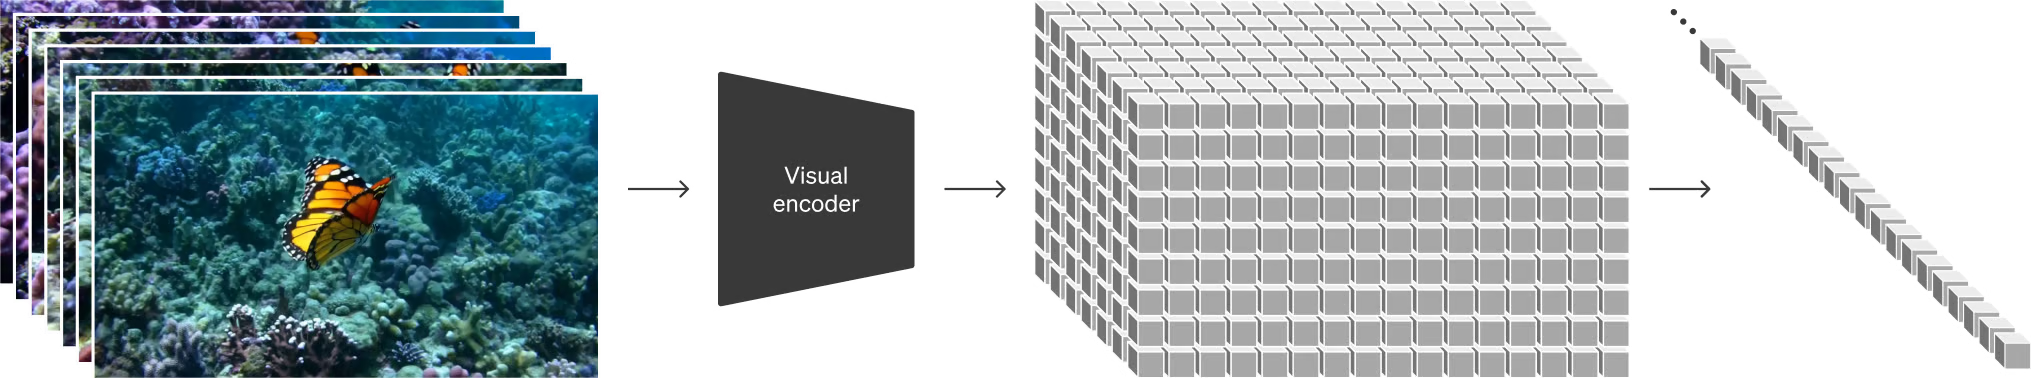
Sora는 영상이 입력되면 이를 잠재 공간(Latent Space)으로 인코딩합니다. 이는 Stable Diffusion에서 보여줬던 아이디어와 유사합니다. 잠재 공간으로 정보를 압축하게 되면 학습 속도를 크게 개선할 수 있을 뿐만 아니라 주요 특징에 대해서 추출하여 생성할 수 있다는 점에서 장점을 갖습니다. 이렇게 압축된 정보는 마지막 단계에서 디코딩되어 다시 픽셀 수준으로 복원됩니다.
- 시공간 패치(Spacetime Patches) 분할
연구진은 Sora를 개발하면서 LLM의 성공으로부터 아이디어를 착안했다고 밝혔습니다. LLM을 학습할 때 입력값을 여러 토큰으로 구분하여 코드나 수학 공식 생성으로 확장한 것처럼, 이미지의 일부를 ‘토큰’처럼 여기고 이를 비전 분야의 생성으로 확장하고자 한 것입니다. 이렇게 토큰화된 이미지를 패치(Patch)라고 부릅니다.
“이미지를 단어를 본다?” 어디에서 많이 들어본 아이디어입니다. 16 × 16의 이미지를 하나의 ‘단어’로 취급했다는 점에서 ViT(Vision Transformer)와 아이디어가 유사한데요. 그동안 ViT는 뛰어난 성능을 보여주었습니다. 다만 이 정보로 영상을 생성하는 것은 다른 영역입니다. 여기에 새로운 학습 구조가 반영됐기 때문에 가능했는데요. 다음으로 Diffusion Transformer에 대해서 계속 알아보겠습니다.
- Diffusion Transformer 기반 영상 생성
압축된 정보로부터 패치로 분할된 정보는 Diffusion Transformer에 입력됩니다. Diffusion Transformer란 Diffusion 모델과 Transformer 모델의 장점을 결합한 학습 방법입니다. Diffusion은 고퀄리티의 이미지를 생성하고, Transformer는 높은 확장성을 가집니다. Sora가 다른 모델들과 차별화되는 지점이라고 할 수 있는데요.
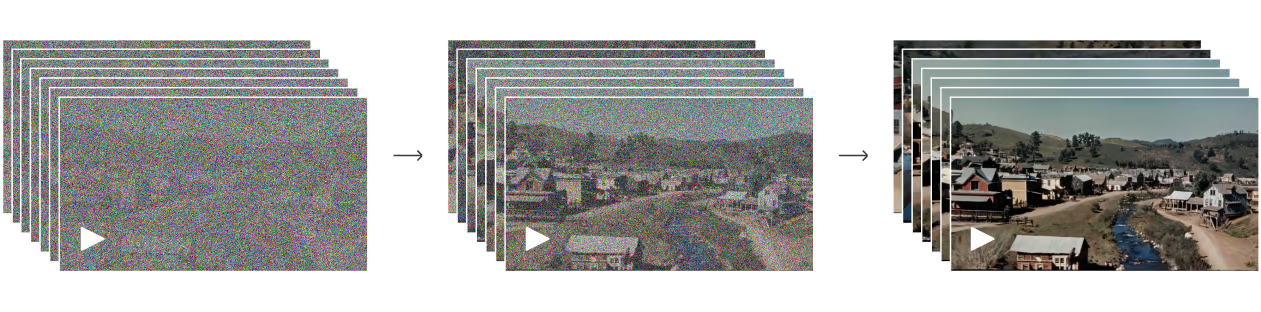
일반적인 Diffusion 모델의 학습 구조처럼, Transformer로 추출된 패치에 노이즈를 주입하고 원본의 이미지를 생성하는 구조로 학습을 진행합니다. 이 방식으로 스케일 확장이 가능해지면서 1분 가까이 되는 영상을 고화질로 생성할 수 있게 됐습니다. 기존에 다른 모델들은 짧은 길이의 영상이나 고정된 비율밖에 생성이 불가능했다는 것을 생각하면 한 단계 더 나아갔다고 볼 수 있습니다.
- 훈련 데이터 양의 증가
학습 구조의 변화뿐만 아니라 훈련 데이터의 양과 질도 달라졌습니다. 텍스트로 영상을 생성하는 모델을 만들기 위해서는 영상을 설명하는 텍스트인 캡션(Caption)이 필요합니다. 하지만 우리가 AI에게 요청하는 텍스트와 실제 학습 데이터인 캡션에는 약간의 차이가 있을 수 있습니다.
우리가 요청하는 텍스트를 작성할 때는 ‘묘사하듯’ 작성하지만, 일반적인 데이터의 경우 포괄적인 설명에 그치는 경우가 많습니다. 이 간극을 극복하기 위해서는 학습 데이터의 캡션을 재생성해야 합니다.
이를 위해 영상의 내용을 묘사하도록 캡션을 생성하는 모델을 먼저 훈련시키고, 해당 모델로 다른 학습 데이터에 적용하여 많은 양의 데이터에 대해서 레이블링했습니다. 이를 Re-Captioning이라고 합니다. 또한 생성된 텍스트를 더 상세하게 작성하도록 만들기 위해 GPT를 활용했습니다. 이 전략은 DALL·E 3에서 활용된 전략과 유사합니다. 덕분에 높은 충실도의 텍스트를 생성할 수 있습니다.
Sora로 가능한 것들
Sora는 비전 생성 분야의 다양한 태스크를 수행할 수 있습니다. 이미지에 애니메이션을 더해 영상처럼 만든다거나, 입력된 영상의 앞뒤 부분을 생성할 수도 있습니다. 또한 입력된 영상의 스타일을 바꾸도록 편집할 수도 있고 서로 다른 두 개의 영상을 매끄럽게 연결하기도 합니다. 영상 전문가들도 하기 힘든 편집 기술이라는 점을 고려하면 Sora가 영상 분야를 위협한다는 말이 마냥 허무맹랑한 이야기는 아니라고 느껴지네요. 아래는 OpenAI가 공개한 영상입니다. 두 눈으로 직접 확인해보세요!
이뿐만이 아닙니다. 대규모로 훈련된 Sora는 창발 능력(Emergent Ability)을 보이기도 합니다. 마치 Sora가 물리적 세계의 사람, 동물, 자연 환경 등을 시뮬레이션하듯이 보여준다는 것인데요. 대량의 데이터를 학습하면서 인간의 세상을 학습했다고 보는 것입니다.
이렇게 뛰어난 Sora의 능력에도 OpenAI 연구진은 실패 사례를 공개하며 한계점을 제시합니다. 아래와 같이 컵이 깨져야 물이 새는 것이 자연스러운데, 컵의 아래로 물이 쏟아지는 모습입니다.
이렇듯 연구진은 Sora가 여전히 세계의 물리적 현상을 완전하게 시뮬레이션하지 못한다고 본 것인데요. 아무래도 OpenAI가 해결해야 할 다음 과제로 보입니다.
그럼에도 불구하고, Sora의 기술 보고서를 보면 지금까지 AI 분야가 집적해온 지식의 정수를 보여준다는 느낌이 듭니다. Stable Diffusion, ViT, DALL·E 3 등 그동안 세상을 깜짝 놀라게 한 모델들의 원리가 모두 녹아들어 있습니다. 이번에 새롭게 마일스톤이 될 Sora는 미래 세대에게 어떤 놀라움을 선사하게 될까요?