
개발자 생태계에는 한 가지 특이한 문화가 있습니다. 며칠 밤을 새워가며 공들여 작성한 코드를 아무런 대가 없이 인터넷 세상에 공개해 버립니다. 심지어 자신의 작업물을 마음대로 베껴 쓰도록 내버려두고, 상업적으로 사용해도 전혀 문제 삼지 않는 경우도 흔히 보입니다. 이른바 오픈소스(Open Source) 문화인데요, 이런 바람직한 문화를 바탕으로 전 세계의 개발자들은 서로 소통하며 자신의 실력은 물론 관련 산업을 빠르게 발전시켜 왔습니다.
대표적인 오픈소스의 성공 사례인 리눅스(Linux)는 수천 명의 개발자의 기여로 완성되어, 다양한 플랫폼에서 널리 사용되고 있습니다. 코드를 통해 세상과 소통해 본 사람 중 Git을 모르는 사람은 없을 것입니다. 버전 관리 시스템으로 사용되는 Git 또한 개발자 커뮤니티에서 광범위하게 사용되는 오픈소스입니다.
AI가 전 세계를 떠들썩하게 만드는 지금도 오픈소스 문화는 여전히 성행하고 있습니다. 대표적인 머신러닝 프레임워크인 텐서플로우(TensorFlow)와 파이토치(PyTorch)는 모두 오픈소스로 공개되어, 누구나 쉽게 사용할 수 있죠.
공유문화는 단순히 코드에서 그치진 않았습니다. 인공 일반 지능(Artificial General Intelligence, AGI)을 향하는 열쇠로써 현재 언어 모델은 전세계의 관심을 끌고 있습니다. 문제는 인공지능 모델을 학습하는 비용이 점점 커져, 규모가 큰 기업이나 연구소가 아니면 언어 모델을 훈련하기가 어렵습니다. 그래서 일부 연구 집단은 오픈 소스 정신을 이어 거금을 들여 학습된 모델을 대중에게 공개하기도 하였습니다.
현존하는 최고의 언어 모델인 ChatGPT를 탄생시킨 OpenAI도 그 이름에서 알아볼 수 있듯이 과거엔 개방성을 표방하며 전 인류에게 이익을 가져다주는 비영리 집단임을 주장했습니다. 현재는 대규모 언어 모델의 남용 가능성을 우려해 기술을 공개하고 있지는 않지만 이처럼 오픈소스는 인공지능의 시대에도 개발자 생태계의 중요한 한 축을 담당하고 있습니다.
그런데 인공지능 학습 비용에 대한 부담이 커지는 동시에, 인공지능의 가능성과 상업성이 입증되며 점점 많은 집단은 오픈소스에서 등을 돌렸습니다. 인공지능 연구는 더 이상 누구나 기여할 수 있는 영역에서 벗어나 거대 자본을 가진 일부가 독점하는 듯했습니다.
그러던 와중 메타(Meta)에서는 LLaMA 모델을 연구용으로 무료로 사용할 수 있도록 공개하였고, 이어 한층 업그레이드 된 LLaMA-2 모델을 상업적 용도로 사용 가능하도록 배포하였습니다. 최근 인기를 끌고 있는 Mistral을 비롯해 여러 대규모 언어 모델이 연달아 대중에게 공개되며 오픈소스 진영과 사유 소프트웨어(Proprietary Software)의 격차를 좁히려는 시도가 잇따르고 있습니다.
다 같은 오픈소스가 아니다?
그런데 공개된 모델들이 진정한 의미에서 오픈소스라고 말할 수 있을까요? 최근 공개된 진정한 오픈소스를 자처하는 OLMo(Open Language Model)를 제안한 논문인 OLMo: Accelerating the Science of Language Models(Groeneveld et al., 2024)에서는 개방성(Openness)에도 단계가 있다고 말합니다.
예를 들어 Mistral 8x7B 모델은 모델 가중치만을 제공하지만, LLaMA는 학습 과정까지도 자세하게 공개하였습니다. Mosaic Pretrained Transformer는 어떤 데이터로 학습했는지를 매우 구체적으로 밝혔지만, 데이터 자체는 공개되지 않았습니다. 반면 Falcon 모델은 사전 학습에 사용한 데이터도 일부 배포하였습니다. Pythia나 BLOOM과 같은 모델은 모델 학습에 사용한 코드와 학습 데이터를 전부 공개하였습니다.
이처럼 겉으로는 오픈소스를 표방하는 듯한 모델들도 대중들에게 모든 정보를 공개하진 않는 경우가 대부분입니다. 반면 Allen AI에서 공개한 OLMo는 언어 모델을 구축하고 학습하는 데 사용한 모든 정보를 공개하였습니다. 학습 데이터 뿐만 아니라 학습과 모델 평가에 사용한 모든 도구를 포함하여, 여러 하드웨어에서 실행 가능한 코드를 동시에 공개하였습니다.
진짜 오픈소스, OLMo 프레임워크
그렇다면 OLMo 모델은 어떻게 학습되었으며, 어떤 구조를 가질까요? 먼저 OLMo 모델은 1B, 7B, 65B로 크기에 따라 세 가지 버전이 존재합니다. 각 모델의 학습에 사용된 하이퍼파라미터는 훈련 과정에서의 안정성을 최대화하는 방향으로 선택되었다고 합니다.
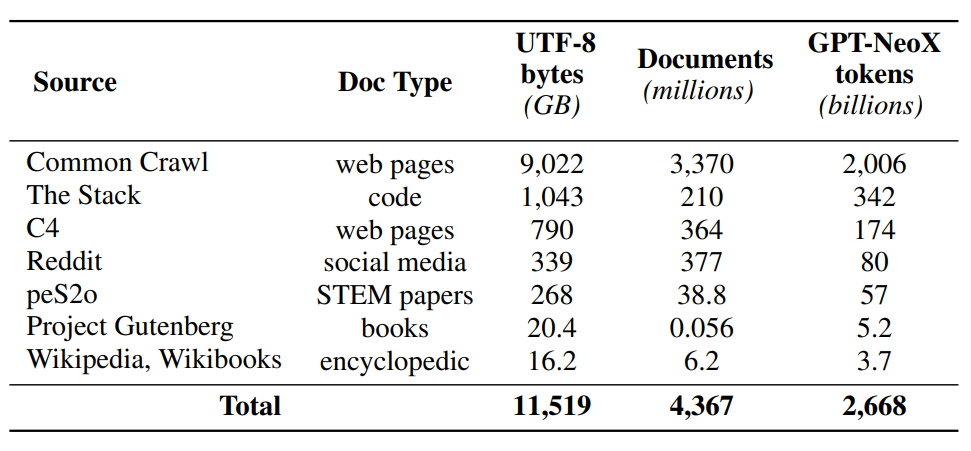
기존에 공개된 모델들은 대부분 학습에 사용한 데이터는 자세히 밝히지 않았습니다. 반면 OLMo는 학습에 사용한 데이터셋인 Dolma(Soldaini et al., 2024)를 공개하여 학습 데이터가 모델의 성능에 미치는 영향을 연구할 수 있도록 하였습니다. Dolma는 대규모 언어 모델 학습에 주로 사용되는 공개된 7개의 서로 다른 데이터셋을 한데 모은 것입니다. 이 데이터셋은 50억 개의 문서로 구성되며 총 3조개의 토큰으로 이루어져 있습니다. 데이터셋의 구성에 대한 자세한 내용은 다음과 같이 논문에 명시되어 있습니다.
OLMo의 또 한 가지 특별한 점은 NVIDIA와 AMD GPU에서 모두 사용할 수 있는 코드를 공개하였다는 것입니다. 4개의 AMD MI250X GPU로 구성된 클러스터에서 학습된 버전과, 8개의 NVIDIA A100 GPU 클러스터에서 학습된 버전은 학습 최적화를 위해 일부 하이퍼파라미터가 각각 다르게 설정되었지만, 성능은 거의 동일한 수준이라고 합니다.
오픈소스 모델의 성능은?
하지만 결국 중요한 건 성능입니다. 누구나 사용할 수 있는 오픈소스 모델이어도 돈을 주고 사용하는 서비스보다 성능이 크게 뒤떨어진다면 전혀 메리트를 느끼지 못하겠죠. 아래의 표는 OLMo를 9개의 태스크에서 성능을 측정하여 공개된 6개의 다른 모델과의 성능을 비교한 결과입니다.
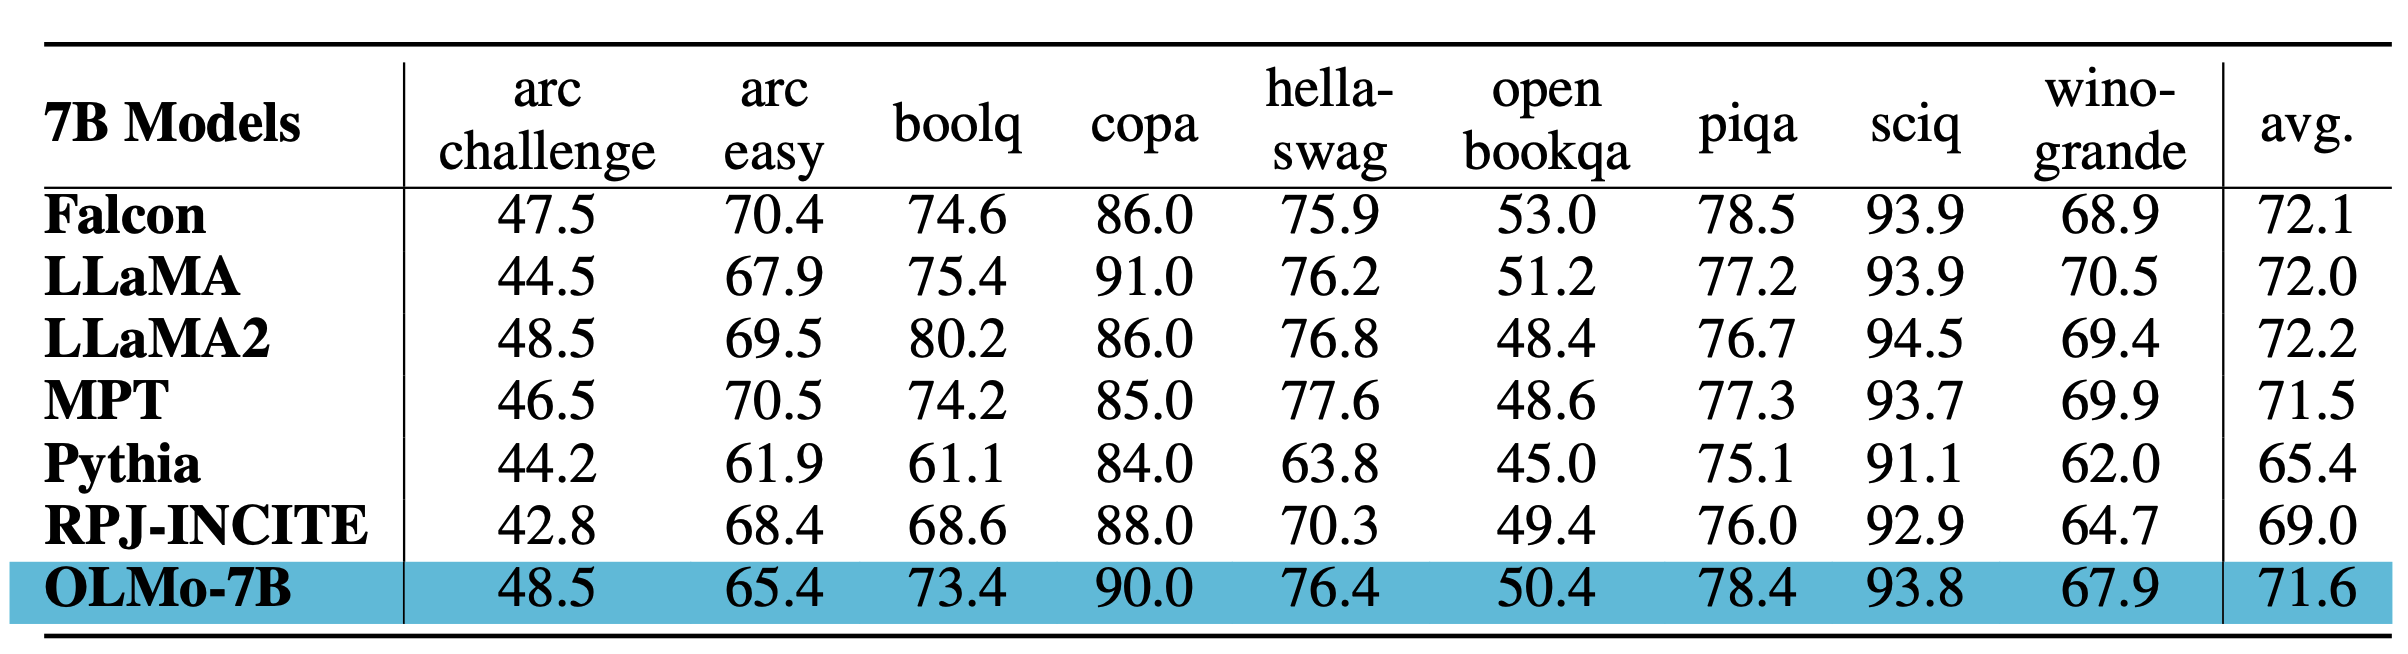
대부분의 태스크에서 OLMo는 우수한 성능을 보이며, 경쟁력 있는 모델임을 입증하였습니다. 특히 모델 가중치와 추론에 필요한 코드만이 공개된 다른 모델들과 달리 OLMo는 학습에 사용된 모든 정보가 공개되어 있다는 점에서 이 결과는 더 큰 의의를 갖습니다. 독점적인 기술을 사용하지 않고도 베일에 쌓여 있는 모델에 뒤지지 않는 성능을 보이는 OLMo에 새로운 기술이 더해지면 어떤 결과를 낳게 될까요?
Closed Source를 따라잡을 수 있을까?
오픈소스 진영과 독점적인 기술을 가진 회사들이 끊임없이 경쟁하며 언어 모델은 나날이 발전하고 있습니다. 아래 그래프는 두 진영에서 내놓은 모델의 성능 차이를 시간에 따라 나타낸 것입니다. 오픈소스 진영은 빠르게 발전하고 있으며 사유 언어 모델과의 격차를 빠르게 좁히고 있습니다.
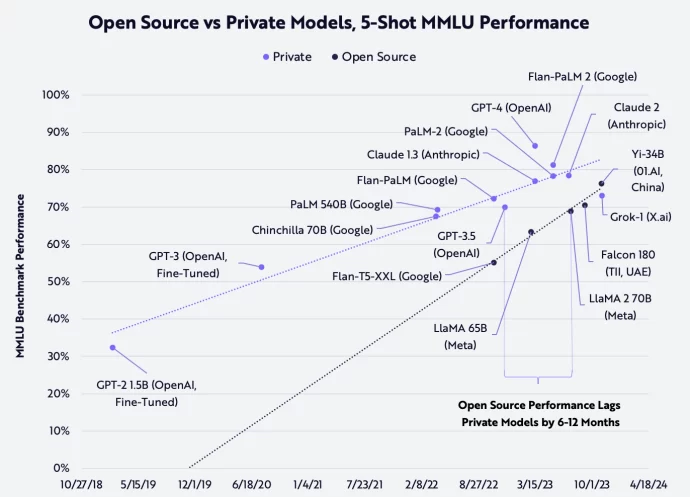
오픈소스의 위대함은 이런 것이라고 생각합니다. 비록 거대한 자본의 힘을 바탕으로 재빠르게 트렌드를 주도하지는 못할지도 모릅니다. 하지만 수많은 사람의 기여가 모여 느리지만, 꾸준히 발전하고 있습니다. OLMo의 등장은 오픈소스 진영의 발전에 박차를 가하고, 언젠가는 Closed Source의 벽을 부술 수 있을까요?