
얼굴 인식(Face Recognition)의 원리
안녕하세요, 에디터 잭잭입니다.
이달 말, 일부 편의점에서 얼굴 결제 기능을 선보인다고 합니다. 얼굴 결제는 사용자 얼굴 정보를 기반으로 카드나 스마트폰 없이 결제할 수 있는 서비스입니다. 양쪽 주머니가 모두 가벼워질 날이 다가왔네요. 그런데 어떤 날은 기분이 안 좋아 무표정일 수도 있고, 또는 전날 라면을 먹고 자서 얼굴이 부었을 수도 있습니다. 처음 기기에 얼굴을 등록했을 때와 100% 일치하지는 않는데, 어떻게 ‘나’인 것을 알아볼 수 있을까요?
이처럼 수많은 사람들의 얼굴 사진들 중 ‘나’를 정확히 찾을 수 있는 기술에는, 이미지 매칭(Image Matching) 기술이 숨겨져 있습니다.
[이미지 매칭 프로세스]
A라는 사용자가 자신의 얼굴로 휴대폰의 잠금을 해제한다고 했을 때 예시를 들어보겠습니다. 사용자의 얼굴을 최초로 등록한 정보가 스마트폰에 있다고 가정했을 때, 얼굴 인식에서의 이미지 매칭은 크게 네 단계로 나뉩니다.
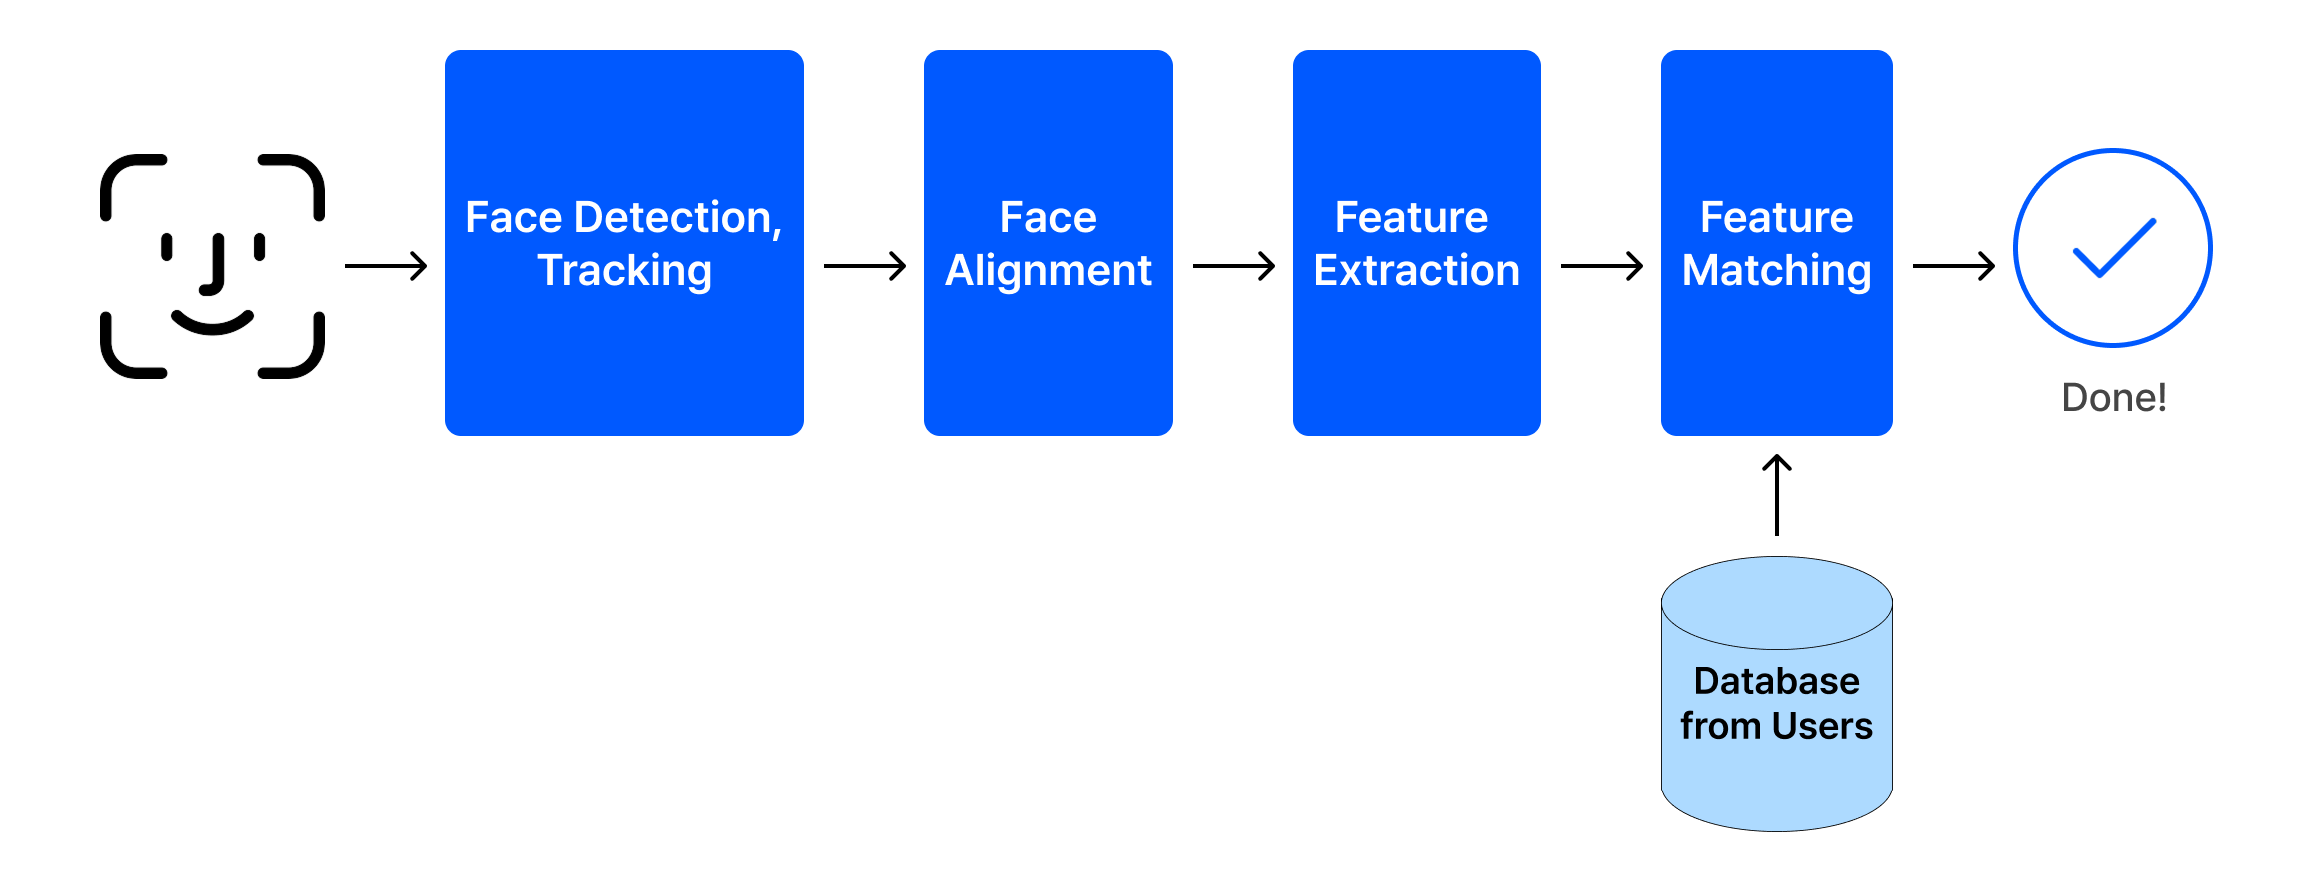
첫 단계는 스마트폰 카메라가 Face Detection 하며 사진 속에서 A의 얼굴을 찾아내는 단계입니다. 사용자가 얼굴 방향을 바꾸어도 계속 추적(Tracking)하며 움직이는 사용자의 얼굴을 계속 포착하죠.
이후 얼굴의 위치와 각도를 조정하는 과정이 이루어집니다. 이를 Face Alignment라고 하는데요. 얼굴이 조금 기울어지거나 다양한 표정을 지었을 때에도, ‘눈, 코, 입, 턱, 얼굴 점’과 같은 주요 특징점들(Key points)의 위치를 기준으로 얼굴을 일직선으로 정렬하여 얼굴을 정확하게 인식할 수 있도록 합니다.
그 다음, Feature Extraction 단계에서는 얼굴에서 중요한 특징들을 추출하는 과정이 이루어집니다. 라면을 먹고 얼굴이 부었거나 기분이 안 좋을 때 얼굴의 모습이 조금 달라져도, 여전히 얼굴의 주요한 특징은 크게 변하지 않습니다. 얼굴 인식 시스템은 이러한 특징을 고유한 숫자 벡터로 변환하죠. 비슷한 얼굴을 가진 사람들도 이 단계에서 서로 다른 특징을 추출하여 구분할 수 있게 됩니다. 즉, 얼굴의 변형이나 표정 차이에도 불구하고 시스템은 중요한 특징을 찾아내어, 사용자가 누구인지 정확히 인식할 수 있도록 돕습니다.
마지막으로 Feature Matching 단계는 사진 두 장을 놓고 사용자 A가 맞는지, 아닌지 비교합니다. 여러 사용자들의 얼굴 정보가 담긴 데이터베이스로부터 A와 일치하는 얼굴 정보가 있는지 확인하는데요. 만약 얼굴이 정확히 일치하면 스마트폰은 A의 얼굴을 인증하고 잠금을 해제합니다.
[Vision Mamba VS ViT]
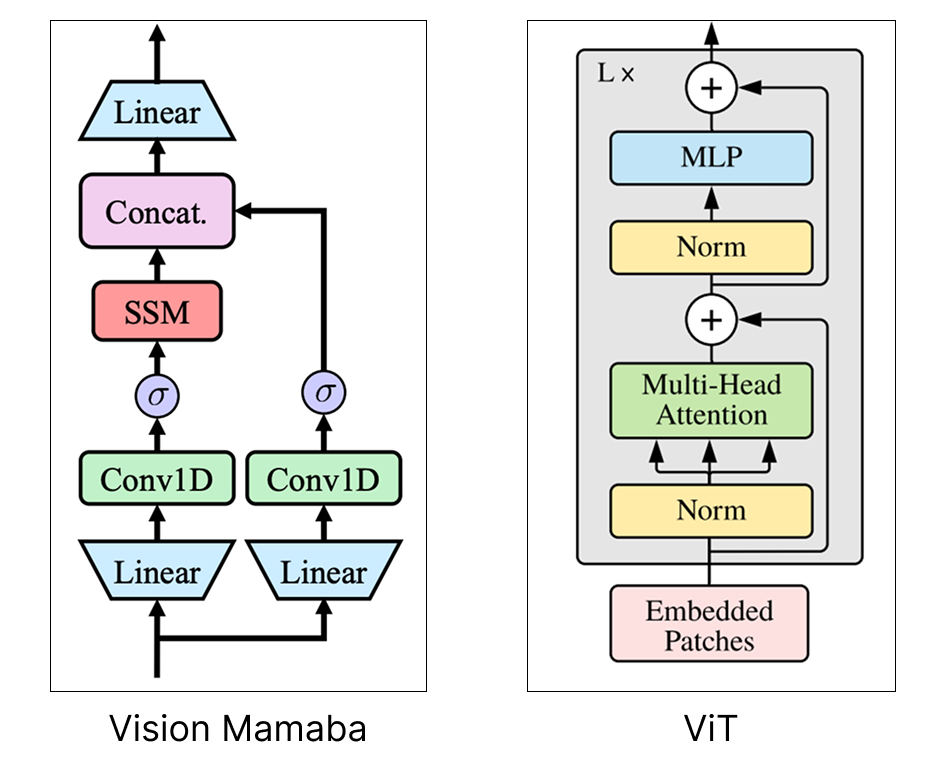
이미지 매칭 모델에서 Vision Transformer(ViT)와 Vision Mamba는 각기 다른 방식으로 특징점을 처리합니다. ViT는 Self-Attention을 사용해 모든 토큰 간의 상호작용을 학습하기 때문에 입력 길이(n)에 따라 연산량이 O(n^2)으로 커지고, 자원 소모가 크다는 한계가 있습니다.
반면, Vision Mamba는 Selective Focus를 활용해 중요한 정보만 유지하고 불필요한 연산을 줄이며, 선형 시간 복잡도 O(n)로 효율적으로 처리한다는 장점이 있는데요. Selective Focus란 선택적으로 중요한 상태만 업데이트하는 방식을 말합니다. 그러나 장기 의존성을 학습하기 어려울 수도 있다는 단점이 있습니다.
[MambaGLUE 아키텍처]
따라서 최근 연구들은 Self-Attention의 전역 문맥 학습 능력과 Selective Focus의 연산 효율성을 결합하려는 시도를 이어가고 있어요. 특히, 기존 Transformer 기반 모델들이 강력한 표현력을 지닌 반면 계산량과 메모리 사용량이 크다는 점을 보완하기 위해, Mamba 기반의 새로운 하이브리드 구조가 등장하고 있는데요.
이러한 맥락에서 최근 주목받고 있는 연구가 바로 MambaGlue입니다. MambaGlue는 Transformer와 Mamba의 강점을 결합하여, 각 레이어의 성능을 획기적으로 향상 시키면서도 낮은 지연 시간(low latency)을 유지합니다. MambaGlue에서 새롭게 제안한 방법은 이미지 전체를 입력받는 것이 아닌, 이미지에서 추출된 특징점과 그 특징점의 위치 정보만을 입력으로 받습니다. 그리고 이를 위해 Feature Matching 단계에서 ViT가 아닌 Vision Mamba의 구조를 사용하죠.
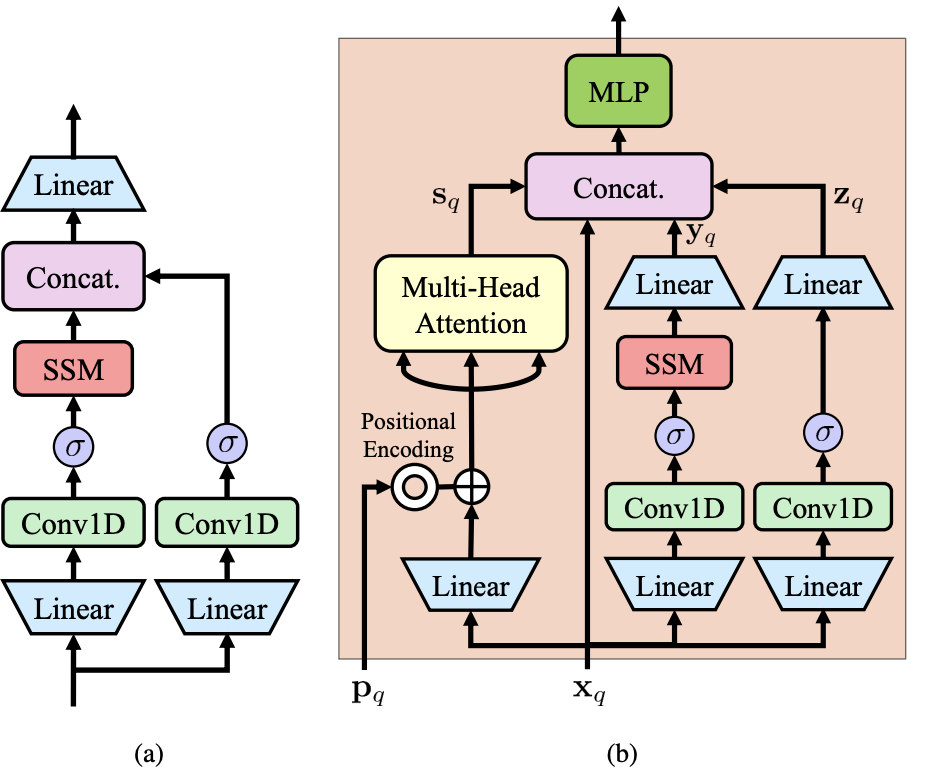
블록은 크게 세 부분으로 나뉩니다. 먼저, 얼굴에서 추출한 여러 특징점들의 좌표(p_q)를 Self-Attention 블록에 넣어 각 특징점 간의 상대적 위치 관계를 파악합니다. 다음으로, 원래의 특징점 벡터(x_q)를 그대로 통과시켜 얼굴 특징을 그대로 유지합니다. 마지막으로 특징점 벡터가 기존의 Vision Mamba 기반 블록을 거치면서, 필요한 정보를 더욱 강조하고 불필요한 정보를 거르도록 설계했습니다. 이렇게 세 가지 부분을 모두 결합(Concatenation) 하면, 이후 단계에서 얼굴의 특징을 더욱 정교하게 활용할 수 있는 형태로 만들어집니다.
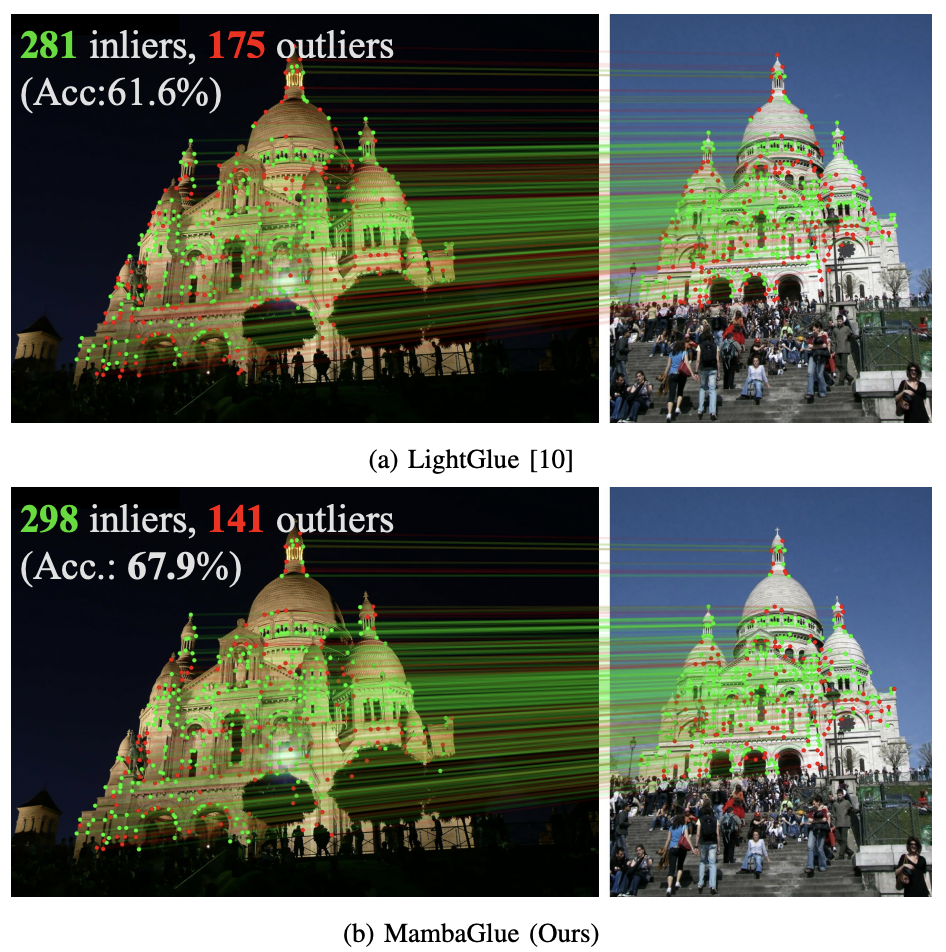
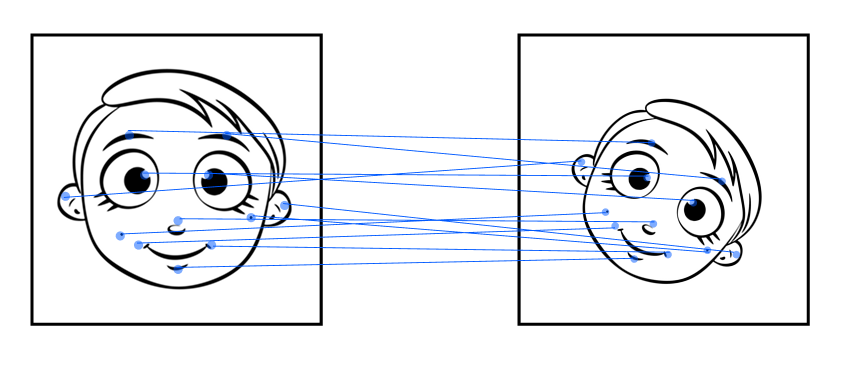
아래에 있는 그림은 MambaGlue를 적용했을 때 Feature Matching 결과입니다. 밤에 찍은 사진과 낮에 찍은 사진의 크기와 각도, 배경이 다른 상황에서도 특징점을 잘 연결하고 있는 모습을 확인할 수 있습니다. 특징점 간의 잘못된 연관 관계(Correlation)를 의미하는 Outlier도 감소시키며, 기존의 SOTA 방법론인 LightGlue 보다 높은 정확도를 달성했습니다.
얼굴 인식의 작동 원리부터 시작하여, 새로운 하이브리드 Feature Matching 기법을 제안한 MambaGlue까지 알아보았습니다. 스마트폰 잠금을 해제하기 위해 얼굴 인식 기능을 사용하면서도, 짧은 시간에 이렇게 많은 단계를 거친다고 생각해 본 적이 없는 것 같습니다.
개인적으로는 굉장히 닮은 형제, 자매 혹은 일란성 쌍둥이에 대해서도 잘 구별을 할 수 있을지 궁금했는데요. 애플의 Face ID 관련 공식 설명에서는 "사용자와 얼굴이 닮은 형제자매 및 쌍둥이의 경우, 그리고 만 13세 미만 어린이의 경우 뚜렷한 얼굴 특징이 완전히 발달한 상태가 아닐 수 있기 때문에 인식 오류가 발생할 통계적 확률이 더 높습니다"라고 언급되어 있는데요. 아직 기술적으로 보완할 점이 조금은 남아 있어 보입니다.
생체 인식(Biometric) 기술의 발전으로 결제, 본인 확인 등 사용자 경험이 점점 더 편리해지고 있습니다. 다음에는 어떤 생체 인식 기술이 시장에 도입될까요? 혹은 보안을 위해 얼굴, 목소리, 홍채 등 여러 개의 생체 신호를 동시에 인식해야 한다면, 오히려 비밀번호를 입력하는 방법으로 돌아가고 싶을 것 같다는 생각도 해봅니다. ⓒ deep daiv.