
말뭉치가 많다고 좋은 것은 아니다?
올해 8월 24일, 네이버가 'HyperCLOVA'라는 생성형 AI를 출시하며 생성형 AI 기술 개발 시장에 출사표를 던졌습니다. HyperCLOVA는 출시와 동시에 한국어에 가장 최적화된 생성형 AI라는 긍정적인 평가를 받고 있는데요, 지금부터 HyperCLOVA의 제작과정에서 알려진 흥미로운 연구결과를 소개합니다🔬
👀💭 말뭉치와 모델의 성능?
언어모델 학습에 이용되는 '말뭉치' (a.k.a 학습 데이터)는 언어모델의 성능을 좌우하는 가장 중요한 요소들 중 하나입니다. HyperCLOVA가 학습과정에서 6500배 더 많은 한국어를 학습시켰다는 것은 곧 6500배의 한국어 말뭉치가 학습 데이터로 이용되었다는 말과 같아요.
여기서 잠깐❗️학습시키는 말뭉치가 인컨텍스트 러닝(In-Context Learning)*에 영향을 미쳐 학습된 말뭉치의 종류에 따라 모델의 성능이 달라진다는 사실, 알고 계셨나요?
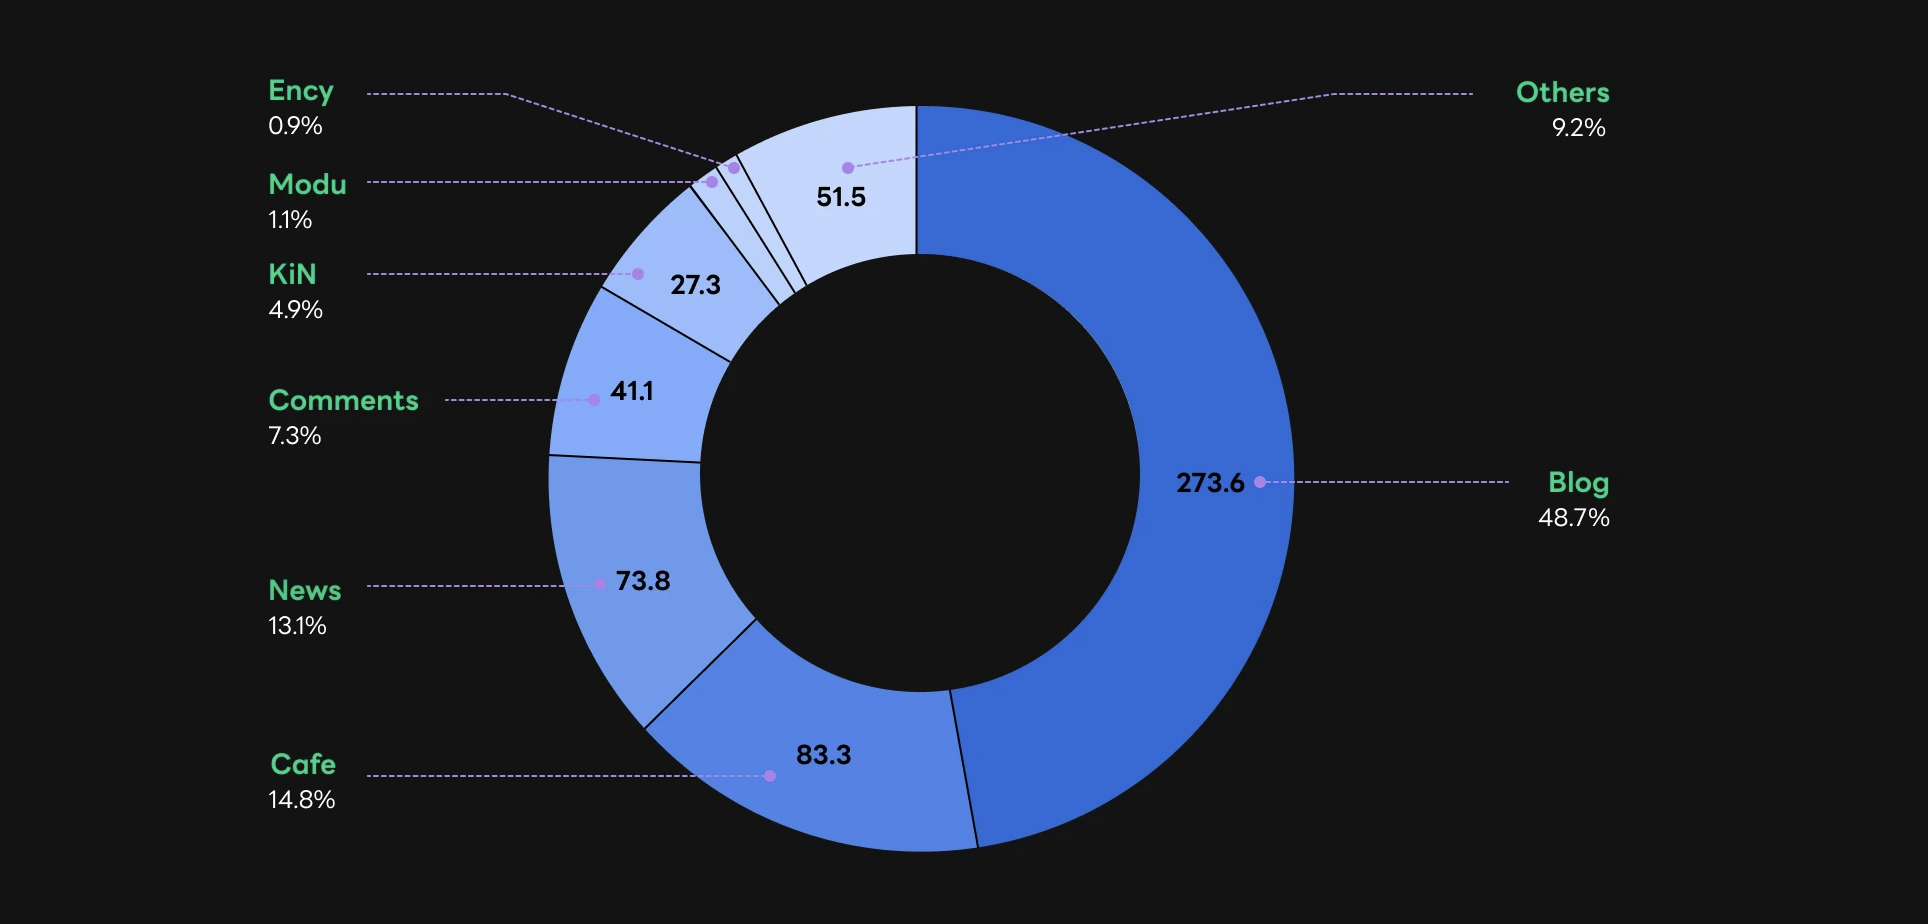
지난해 5월, 네이버의 CLOVA AI 팀은 CLOVA Engineering Blog를 통해 말뭉치의 조합에 따른 모델의 성능에 관한 실험결과를 공개했습니다🔎
HyperCLOVA에서는 총 7개의 말뭉치로 (네이버 블로그/ 네이버 카페 / 네이버 뉴스 / 네이버 댓글 / 네이버 지식인 / 모두의 말뭉치 / 위키피디아) 실험을 설계했습니다. 그리고 각각의 말뭉치를 사용하여 모델을 학습시킨 후 영화 1. 리뷰 감성 분석, 2. 문서 독해, 3. 한영 번역, 4. 영한 번역, 5. 뉴스 제목 분류 총 5가지 과제에 대한 성능을 평가했는데요, 다음은 실험의 결과입니다🕵🏻
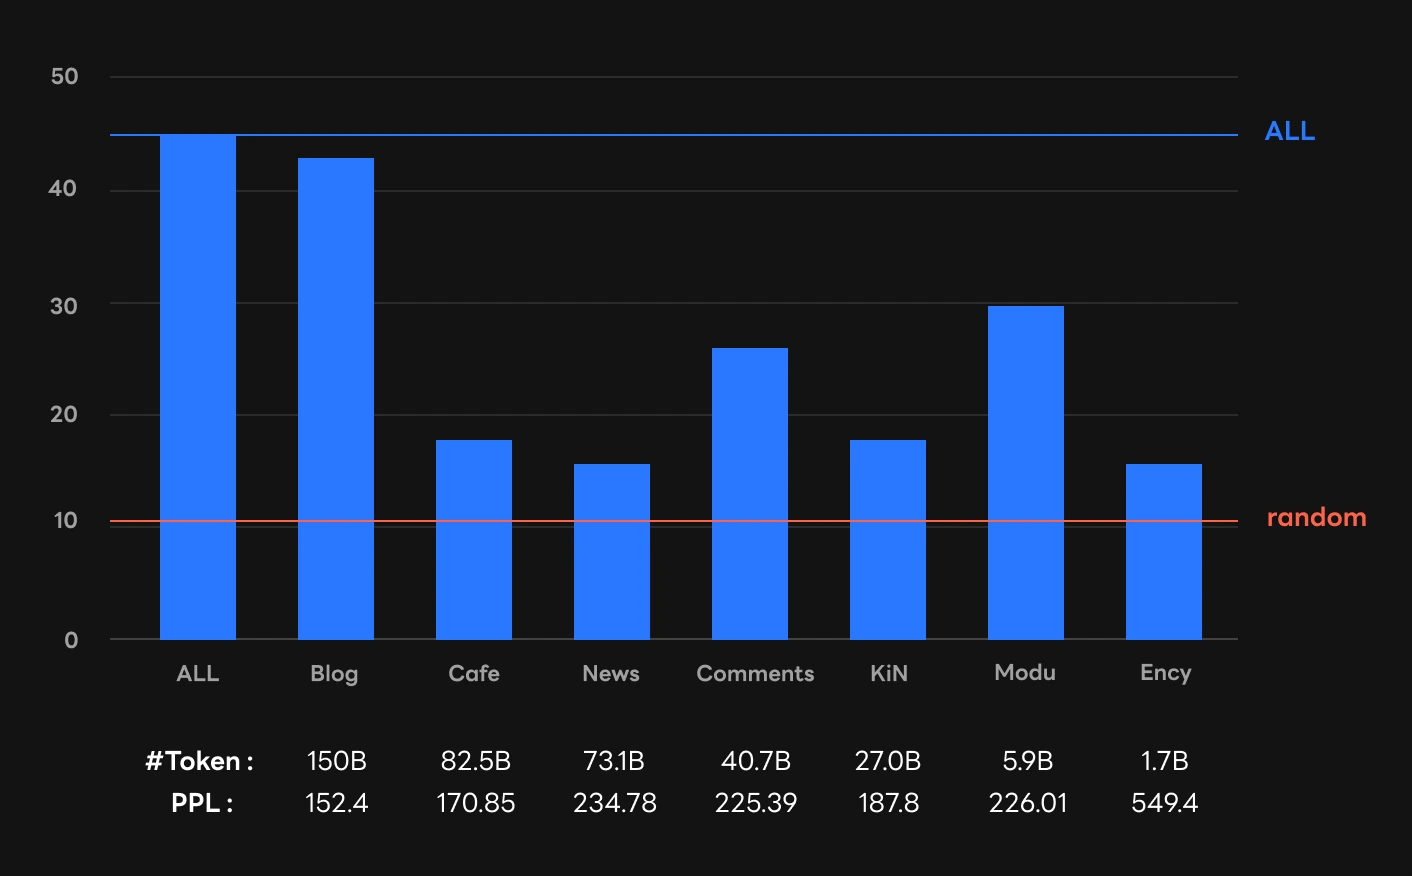
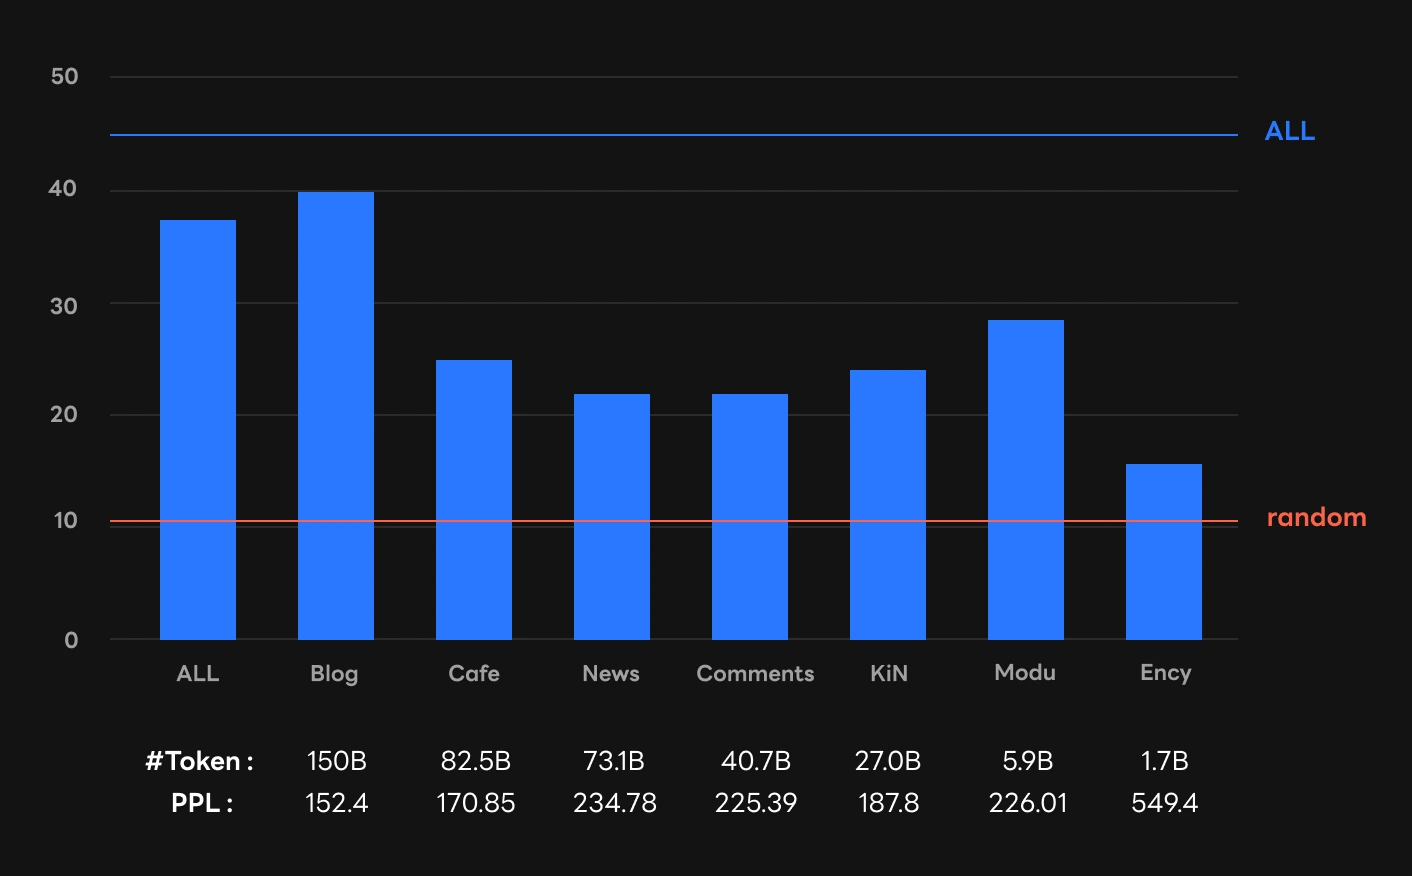
1️⃣ 첫 번째로, 학습시킨 말뭉치의 종류에 따라 상이한 인컨텍스트 러닝 성능을 보였습니다.
블로그 데이터를 학습한 모델은 인컨텍스트 러닝 성능이 7개 전체 말뭉치를 학습한 모델의 성능에 근접하지만 나머지 말뭉치를 통해 학습된 각각의 모델들은 현저한 격차로 성능이 떨어졌어요. 자유로운 포스팅이 가능하며 일기장의 성격이 강하고, 네트워크 형성 중심적이라는 비슷한 속성을 가진 블로그와 카페 데이터를 각각 학습한 언어모델이 인컨텍스트 러닝에서 상이한 성능을 보이는 신기한 결과입니다🤔
여기서 또 주목할 점은 자연어 처리 분야에서 언어 모델의 성능을 평가하는 데 사용되는 지표인 **퍼플렉시티(Perplexity)*와 인컨텍스트 러닝 성능은 비례하지 않는다**는 점입니다. 인컨텍스트 러닝 성능 측정결과와 다르게 카페의 PPL은 7개 전체 말뭉치를 학습한 모델 다음으로 2번째로 높았거든요. 실험결과에 따라 HyperCLOVA는 PPL과 모델의 실제 성능 사이에는 괴리가 있다고 주장합니다.
2️⃣ 두 번째로, 말뭉치를 잘 조합하면 새로운 능력이 생기거나 기존의 성능이 오히려 낮아지기도 합니다.
조합한 데이터들 사이에 일관성이 없으면 서로 다른 정보나 관점이 충돌하여 불안정한 결과를 생성할 수 있기 때문입니다. 또, 데이터 소스가 특정 주제나 관점을 과도하게 대표하는 편향성을 띠는 문제와 도메인이 일치하지 않아서 생기는 기술적인 문제도 발생할 수 있어요.
이에 따라 학습시키는 말뭉치들의 조합에 따라 성능측정 결과는 상이합니다. 네이버 카페와 KiN, Ency를 각각 학습한 경우에는 성능이 낮았지만, KiN+Ency나 Cafe+KiN 모델은 인컨텍스트 러닝 성능이 상대적으로 준수했습니다.
3️⃣ 세 번째로, 과제와 비슷한 말뭉치로 사전 훈련된다고 해서 높은 성능이 보장되지 않습니다.
뉴스 말뭉치를 학습시키면 뉴스 제목 분류하기 과제에서 고득점이 예상되지 않나요? 하지만 실험 결과는 예측을 빗나갑니다. 제로샷에서는 예측대로 뉴스 말뭉치가 포함된 모델의 성능이 전체 7개 말뭉치를 학습한 경우보다 좋았지만 퓨샷은 뉴스가 포함될 경우 오히려 모델의 성능이 낮아졌습니다.
기존의 파인 튜닝 연구에서는 사전훈련과제와 과제가 비슷할수록 성능이 증가하는 경향이 발견되었지만 퓨샷에서는 이런 경향성이 적용되지 않습니다. 따라서 퓨샷 러닝과 파인 튜닝은 말뭉치와 과제의 유사도에 따른 성능 측면에서 상이하다는 것을 확인할 수 있었습니다.
학습 말뭉치에 따라 모델의 성능이 달라지고, 심지어 말뭉치를 어떻게 결합하느냐에 따라서 성능이 좋아지기도 나빠지기도 한다는 사실이 정말 흥미로운데요🤩 아쉽게도 왜 이러한 결과가 나왔는지에 대한 정확한 분석까지는 이루어지지 않았습니다. 한국어 말뭉치만을 대상으로 실험했다는 점에서도 분명히 한계가 존재하고요.
그러나 이러한 연구 결과는 인컨텍스트 러닝, 더 나아가서 하이퍼스케일 언어 모델의 능력을 이해하고, 이를 토대로 독자적인 우리나라만의 생성형 AI를 제작하는 밑거름이 될 것입니다. 지금까지 네이버는 국내 AI 분야에서 뛰어난 역량을 보여왔습니다.
지난 8월 24일, 많은 관심 속에 'HyperCLOVA’를 한층 업그레이드한 ‘HyperCLOVA X’를 공개했고 지난 9월 20일부터 생성 AI 기반 검색 서비스 ‘큐:(Cue:)’도 베타 서비스를 시작했습니다. 아직 초기 단계이더라도 한국어 기반의 언어 모델을 구축하고자 한다면 이런 실험과 연구는 계속되어야 합니다. 다양한 실험적인 연구들을 통해 자체 개발되고 있는 한국의 생성형 AI의 발전을 응원합니다💪