
[MoE(Mixture of Expert)]
안녕하세요, 에디터 잭잭입니다.
MoE(Mixture of Experts)는 최근 대규모 AI 모델에서 활발히 활용되고 있는 아키텍처로, DeepSeek, Gemini, GPT-4 와 같은 최신 모델에서도 적용되고 있습니다. 인공지능 모델의 규모가 커질 수록 성능이 개선되지만, 모델의 파라미터 수가 늘어날수록 많은 계산을 필요로 하기때문에 추론 시간이 지연되는 문제가 있었죠.
MoE는 여러 개의 전문가(Expert) 네트워크 중 일부만 활성화하여 연산을 수행함으로써 연산량을 줄이면서도 높은 성능을 유지할 수 있는 것이 특징입니다.
[MoE의 발전 과정]
초기 MoE는 모든 전문가(Experts)에게 입력을 분배하는 방식이었어요. 이러한 방법을 Dense MoE라고 하는데요. 즉, 모델의 모든 전문가가 동시에 활성화되었으며, 각 전문가가 산출한 출력을 Softmax 가중치를 이용해 합산하는 구조였습니다. 당시에는 연산 효율성과 확장성의 한계로 인해 큰 주목을 받지는 못했으나, 이후 딥러닝 기술이 발전하면서 대규모 신경망에 적용되며 다시 떠오르기 시작했습니다.
2016년, Google이 Sparse MoE를 제안하며 MoE의 활용 가능성을 대폭 확장하였습니다. 기존 MoE 모델이 모든 전문가를 동시에 활성화했던 것과 달리, Sparse MoE는 입력마다 일부 전문가만 선택해 연산을 수행하는 방식을 도입해 연산량을 크게 줄이면서도, 높은 성능을 유지할 수 있도록 했습니다. 이를 통해 1370억 개의 파라미터를 가진 모델을 개발하면서도, 실제 활성화되는 파라미터 수는 훨씬 적어 효율적으로 운용할 수 있었어요.
최근에는 OpenAI, Google, DeepSeek 등의 연구팀이 MoE를 대규모 언어 모델(LLM)에 적용하며 이를 한층 더 발전시키고 있습니다. 최근 프랑스의 인공지능 기업인 Mistral AI에서 공개된 Mixtral 모델은 MoE 구조를 활용하면서도 기존의 단점을 개선하며 화제가 되었습니다.
[MoE에서 전문가(Experts)란?]
MoE를 직역하면 “전문가들의 집합”이라는 뜻입니다. 여기서 ‘전문가(Expert)’는 모델의 특정 부분을 의미하는데, 각 전문가는 서로 다른 데이터 패턴을 학습한 Weight
예를 들어:
- 수학 문제를 잘 푸는 전문가
- 자연어 이해를 잘하는 전문가
- 코드 분석을 잘하는 전문가
이처럼 여러 개의 전문가가 존재하고, 입력 데이터의 특성에 맞춰 가장 적절한 전문가가 활성화된다.
모델에 입력이 들어 왔을때, 해당 부분을 가장 잘 처리할 수 있는
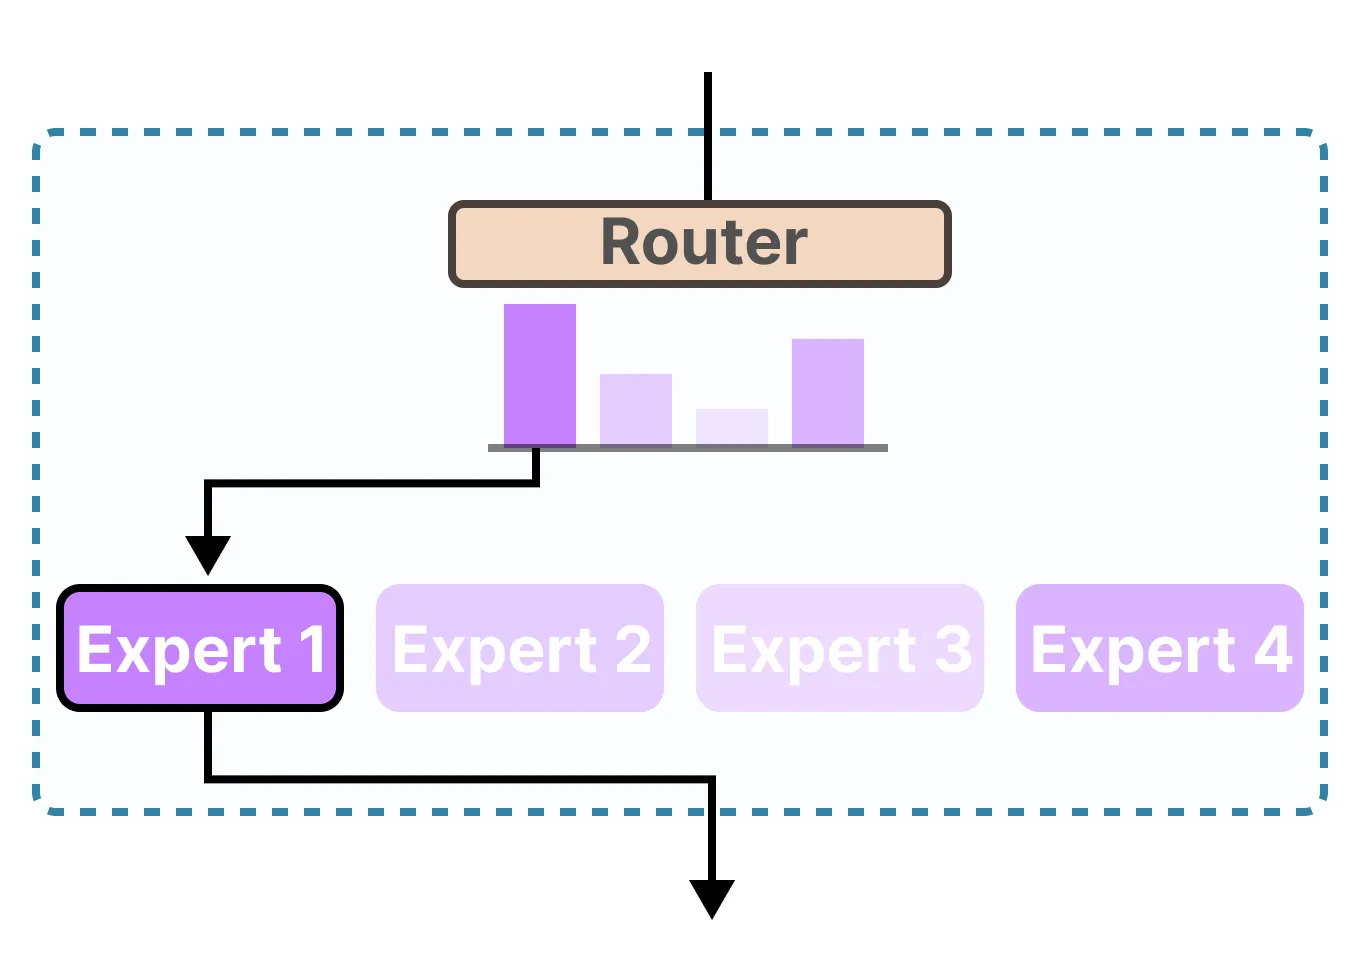
조금 더 풀어서 설명해 보자면 모든 전문가(Experts)가 동시에 활성화되지 않고, 각 입력에 대해 일부 전문가만 선택되어 활성화됩니다. 예를 들어, 4-way MoE에서는 4명의 전문가 중에서 일부만 선택되어 계산에 참여하게 됩니다. 이렇게 함으로써 계산 비용을 줄이고, 모델의 파라미터 수는 크게 증가시키면서도 인퍼런스 단계에서의 latency를 크게 줄일 수 있습니다.
그렇다면 어떤 전문가가 필요한지 모델이 어떻게 스스로 결정할까요?
입력 토큰에 따라 어떤 전문가를 활성화할지 결정하는 모듈을 라우터(Router)라고 합니다. 아래 그림을 보시면, 라우터는 전문가 그룹의 앞 레이어에 존재합니다.
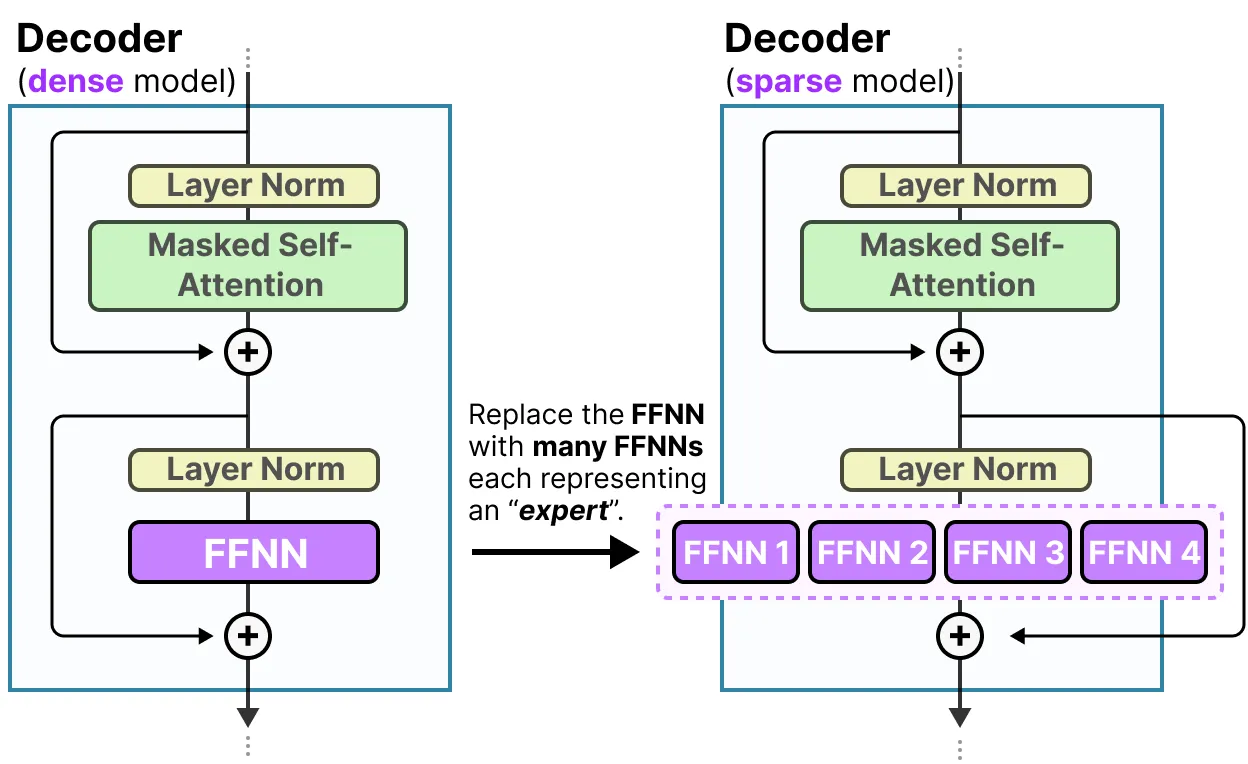
출처: A Visual Guide to Mixture of Experts (MoE)
왼쪽은 일반적인 Transformer Decoder모델이다. 오른쪽은 4개의 Experts를 가진 Sparse한 Decoder 모델이다.
FFNN은 어떻게 학습시키지?
→Mixtral of Experts (8개의 task에 대해 각각 학습시켰다고함)
[MoE의 작동 원리]
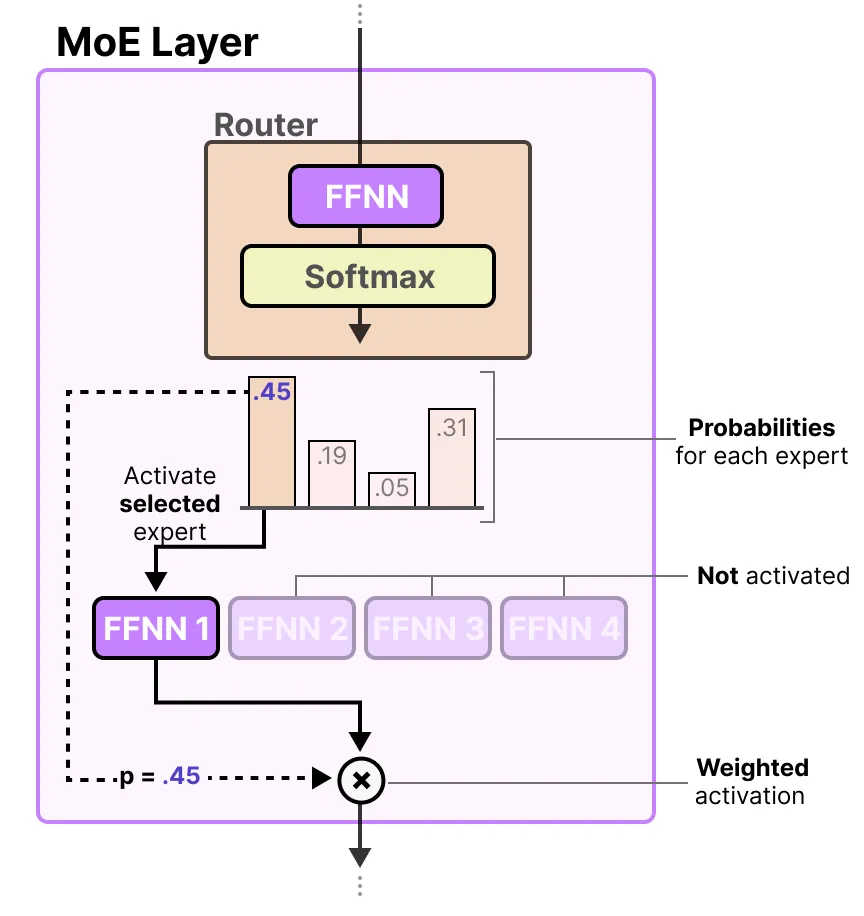
Experts의 바로 앞에는 라우터(Router)가 추가 되는데, 라우터는 주어진 토큰에 대해 어떤 expert를 골라야 하는지를 학습한다.
입력 x가 들어와 라우터 G(x)를 거쳐, 전문가인 E_i(x)가 활성화 되는 과정은 아래와 같다.
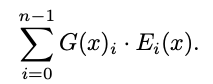
라우터는, 주어진 전문가들에 소프트맥스(Sotmax)를 취하여 상위 K개의 전문가를 선택한다.
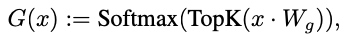
만약 k=2라면, 최종 출력은 아래와 같다.
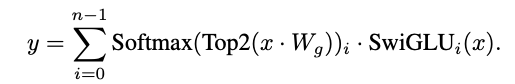
[MoE를 활용한 모델의 성능]
[MoE는 “항상” 효율적이지는 않다.]
Inference시에만 활성화 되는것은 맞으나 Pre-train 시에는 동일하게 파라미터가 업데이트 되어야 하고, 서버에 해당 파라미터를 항상 가지고 있어야 한다는 것이 어찌 보면 비효율적이라는거죠.
✅ 장점:
- 추론(Inference) 시에는 연산량이 감소 (활성 전문가만 사용).
- 기억(memory-intensive) 작업에서 강력한 성능을 보임.
- 동일한 FLOP에서 더 큰 모델을 사용할 수 있음.
❌ 단점:
- Pre-training 시에는 모든 전문가가 업데이트되므로 연산량 증가.
- 전문가 간의 로드 밸런싱 문제가 발생하여 일부 전문가가 과부하될 수 있음.
- 분산 학습 시 통신 오버헤드가 증가하여 클러스터 환경에서 병렬 효율성이 떨어짐.
📌 결론: MoE는 "항상" 효율적이지 않다.
- Inference 시에는 장점이 있지만, Pre-training에서는 비효율적인 측면이 많음.
- 전문가 간의 부하 분산과 모델 학습 비용 문제를 해결하지 않으면 Dense Model이 더 나을 수도 있음.
- MoE를 적용할 때는 "어떤 작업에 적합한가?"를 먼저 고려해야 함.
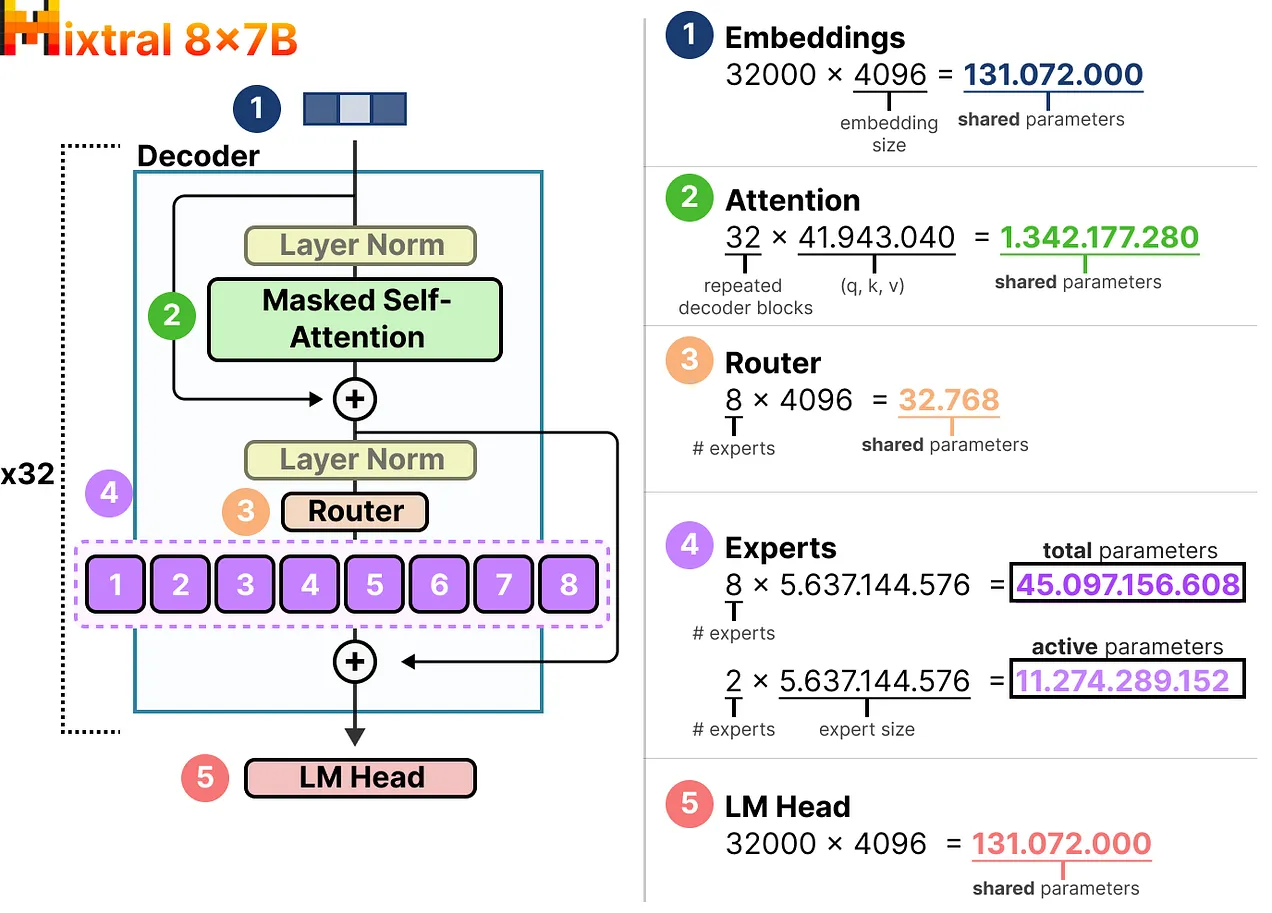
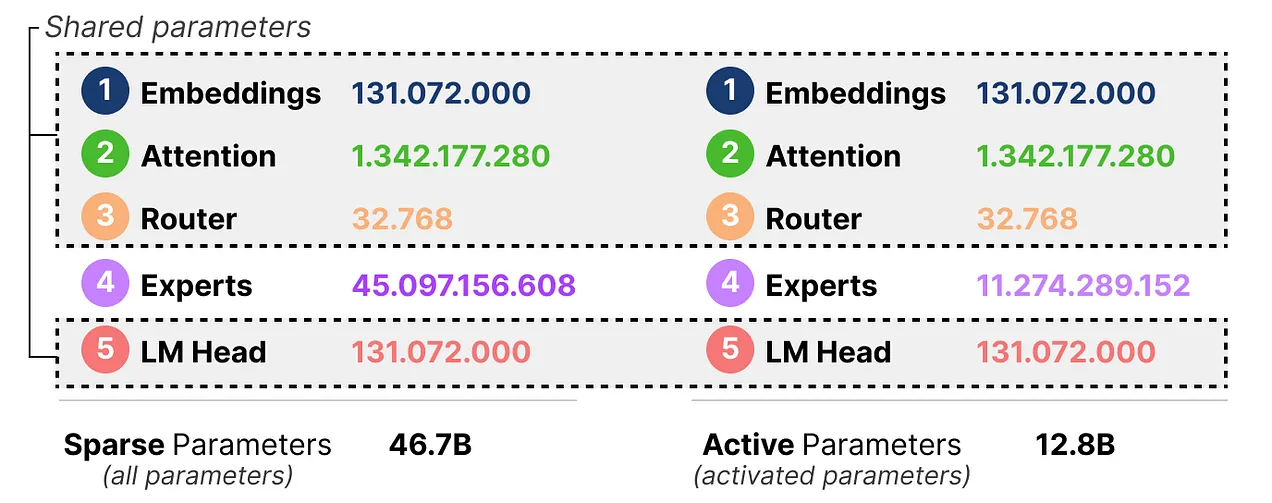
Mixture-of-experts(MoE) 모델은 일반적으로 밀집(dense) 모델보다 추론 비용이 저렴하지만, 활성화된 파라미터 수가 적어서가 아니라 층 수가 적고 네트워크 통신이 덜 필요하기 때문에 그렇다. 즉, MoE 모델은 동일한 크기의 밀집 모델에 비해 전방 패스(forward pass) 시 필요한 네트워크 통신이 적다. 따라서 MoE의 추론 비용을 활성화된 파라미터 수만 보고 추정하는 것은 잘못된 결과를 초래할 수 있다. (How do mixture-of-experts models compare to dense models in inference?)
MoE는 더 많은 sparse parameters를 로드해야 하지만, 추론시에는 일부 전문가만 활성화되므로 (active parameters) 더 적은 매개변수가 사용된다. 즉, 모델을 실행할면 모든 전문가를 포함한 전체 모델을 장치에 로드하기 위해 더 많은 VRAM이 필요하지만, 추론 속도는 더 빠르다.
[어떤 작업에 적합할까?]
MoE는 매 토큰마다 특정 몇면 전문가의 파라미터만을 활성화하기 때문에, 인퍼런스 속도가 빠르다는 장점이 있습니다.
MIXTURE OF PARROTS : EXPERTS IMPROVE MEMORIZATION MORE THAN REASONING 에서는 MoE가 역사와 같은 단순 암기 task에서는 성능이 좋으나, Experts를 많이 늘려도 수학과 같은 Reasoning task에서는 특정 시점에 한계가 있음을 밝혔습니다.
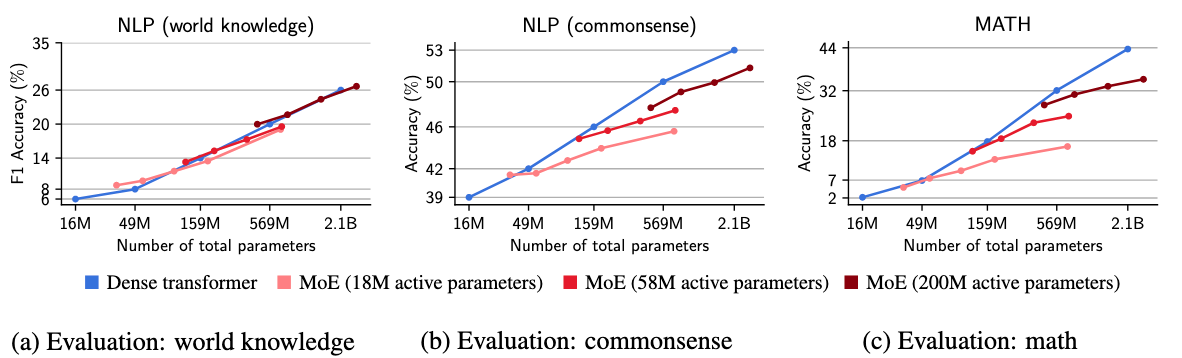
출처: Mixture of Parrots: Experts improve memorization more than reasoning(Jelassi et al.,2024)
MoE(Mixture-of-Experts) 모델은 그 특성뿐만 아니라 파인튜닝을 할 때 기존 모델들과 다르게 동작한다. 실제로, MoE는 과적합(overfitting)에 더 취약하다. 일반적으로 전문가의 수가 적을수록 모델을 파인튜닝하는 것이 더 쉬워진다. 그러나 TriviaQA 데이터셋과 같은 예외도 있으며, 이 경우 파인튜닝된 MoE가 뛰어난 성능을 보인다.
비록 MoE가 파라미터의 일부만 사용하더라도, 여전히 모델과 모든 전문가를 메모리에 로드해야 한다. 따라서 MoE를 사용하려면 VRAM(비디오 RAM)을 갖춘 머신이 필요하다.
이 특성은 MoE를 선택해야 하는 경우가 충분한 VRAM이 있고 고속 추론(inference speed) 이 필요한 경우임을 강조한다. 그렇지 않으면, 밀집 모델(dense model)(MoE가 아닌)이 더 적합할 것이다. (MoE: faster & more powerful, the new kings of LLMs!)