
사람처럼 학습하는 인공지능
안녕하세요, 에디터 잭잭입니다.
사람이 가진 학습 능력을 인공지능도 가질 수 있을지에 대한 의문은 오래전부터 이어져 왔습니다. 이러한 질문에 답하기 위해, 강화학습(Reinforcement Learning)은 사람의 학습 방식을, 메타러닝(Meta-learning)은 사람의 학습 능력을 인공지능에 적용하려는 시도로 발전해왔습니다.
사실 이 두 방법은 전통적인 사전 학습(Pre-training)과 사후 학습(Post-training)의 관점에서 바라보면 약간 다른 성격을 가지고 있는데요. 그렇지만 이해를 돕기 위해, 강화 학습은 사전학습에 가깝고 메타러닝은 사후학습에 가깝다고 생각해주셔도 될 것 같습니다.
최근 Test-Time Compute를 최적화하는 연구에서 Meta-RL을 도입할 것을 제안했는데요. Meta-RL은 이름에서 알 수 있듯이 강화 학습에 메타러닝을 적용한 방법입니다. 왜 이 두 학습법을 결합하게 된 것인지, 그리고 강화 학습과 메타러닝이 무엇인지 알아보려고 합니다.
강화학습(RL)이란
강화 학습은 LLM이 다양한 추론 과제를 해결하기 위한 방법론으로 자주 언급되고 있는데요. 얼마 전 오픈소스로 공개된 DeepSeek R1과, GPT-o1 모델에서도 추론 성능을 높이기 위한 생각의 사슬(Chain-of-Thought) 과정을 내재화하기 위해 강화학습이 사용되었습니다.
우선, 강화 학습에서 사용되는 몇 가지 용어들을 간단히 알아보려고 합니다.
가장 먼저 에이전트(Agent)는 주어진 환경에서 보상(Reward)을 받음으로써 학습하는 객체인데요. 여기서 말하는 환경(Environment)이란, 에이전트를 둘러싼 외부 시스템이나 세계를 말합니다. 또한 보상을 주는 규칙은 정책(Policy)이라고 부릅니다.
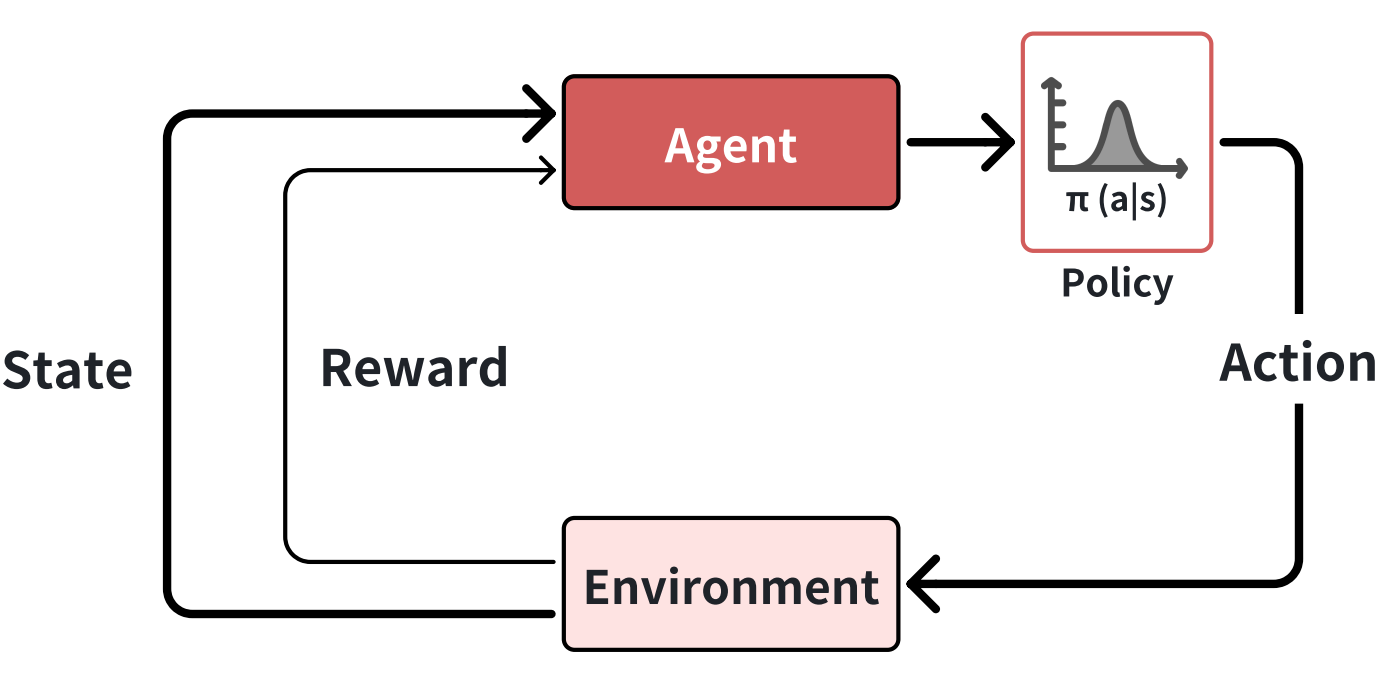
주요 용어를 익혔으니 강화학습의 주요 원리를 담은 그림과 함께 살펴볼까요?
그림을 보면, 에이전트와 환경이 가장 눈에 띕니다. 위에서부터 시계 방향으로 살펴보면 에이전트는 정책을 통해 행동을 결정하게 되고, 이러한 행동에 따라 환경은 에이전트에게 상태와 보상을 전달하고 있네요.
이처럼 에이전트는 특정 상태에서 행동을 통해 환경으로부터 피드백을 받고, 이로부터 업데이트된 정책으로부터 보상을 최대화할 수 있는 행동을 선택합니다.
메타 러닝이란
이번에는 메타 러닝이 무엇인지 간단하게 알아보겠습니다.
메타(Meta)라는 말은 누군가에게는 익숙할 수도, 혹은 익숙하지 않을 수도 있는데요. “메타 인지”라고 하면 자신이 무엇을 알고 모르는지 아는 것을 뜻합니다. 이와 비슷하게, 메타 러닝은 “학습하는 방법을 학습하는 것”을 의미해요.
그렇다면 메타 러닝이 왜 필요할까요?
데이터가 부족한 경우에 적은 추가 학습을 통해서 특정 작업에 잘 적응할 수 있기 때문입니다. 일반적인 학습 방법은 특정 문제를 해결하는 데 초점이 맞춰져 있지만, 메타 러닝은 범용적인 학습 전략을 습득하는 데 초점을 두기 때문이죠. 예를 들어, 새로운 언어를 배울 때 특정 언어의 문법과 단어를 배우는 것도 중요하지만 언어를 배우는 방법 자체를 이해하면 다른 언어를 더욱 쉽게 배울 수 있는 것과 비슷한 원리입니다.
메타-강화 학습
지금까지 강화 학습과 메타러닝에 대해 알아보았는데요, 마지막으로 메타-강화 학습을 살펴보겠습니다.
강화 학습은 일반적으로 많은 양의 데이터와 반복적인 시뮬레이션을 요구하고, 사람이 이 과정을 구축하고 감독해야 한다는 한계가 있습니다. 이를 해결하기 위해 제안된 방법이 메타-강화 학습(Meta-RL) 입니다.
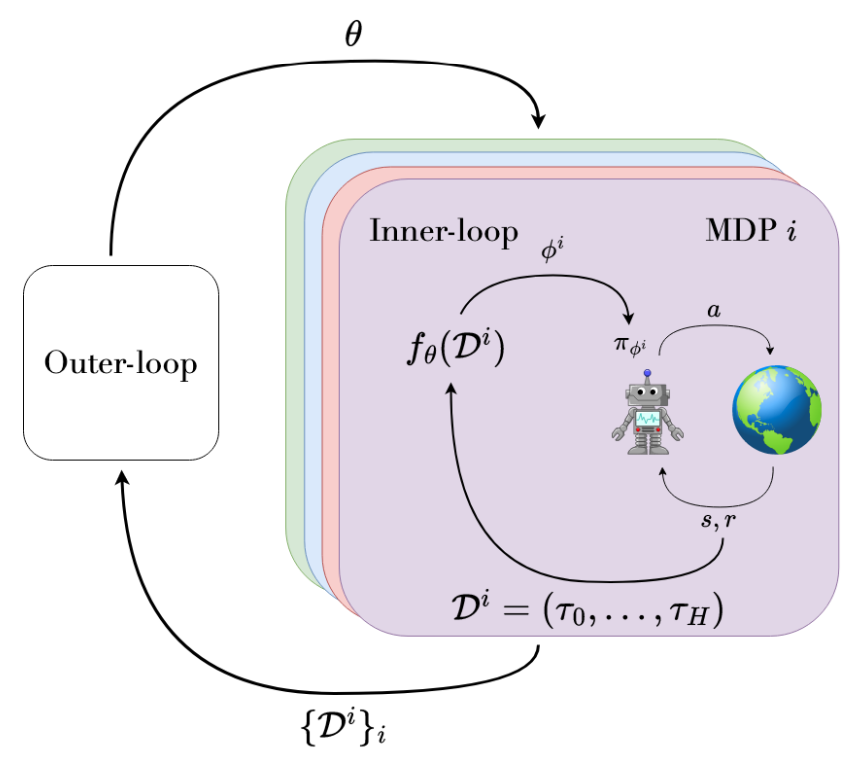
메타-강화 학습은 과거의 여러 작업들로부터 얻은 경험을 활용하여 새로운 태스크에서도 빠르게 최적의 정책을 학습할 수 있도록 합니다. 기존의 강화 학습은 단 하나의 환경에서 정책을 학습하는데, 메타-강화 학습은 다양한 환경의 분포를 학습시킴으로써 정책을 학습시키는 알고리즘을 학습한다는 점에서 차이가 있어요.
위 그림에서의 외부 루프는 메타 학습 과정이고, 내부 루프는 강화 학습을 통해 특정 작업에 적응하는 과정을 나타냅니다. 메타-강화 학습은 이 과정을 사람이 아닌 머신러닝을 통해 학습시킴으로써, 기존에 강화 학습에서 필요로 했던 인력을 줄일 수 있어요.
오늘은 강화 학습, 메타러닝, 그리고 메타-강화 학습까지 다양한 학습법을 알아보았는데요. 용어가 비슷해 조금 헷갈리실 수 있을 것 같습니다.
정리하자면, 강화 학습은 데이터 효율적이지 않고 정책이 일반적이지 않다는 문제점이 있었습니다. 이를 해결하기 위해 메타-강화 학습이 제안되었고, 이 학습법의 목표는 적은 데이터로도 기존의 작업으로부터 다른 작업에 적응할 수 있도록 하는 정책을 학습하는 것입니다.
이처럼 강화 학습의 한계를 보완하고 더 효율적인 학습을 가능하게 하기 위해 메타-강화 학습이 올해부터 다시금 주목받고 있습니다. 앞으로도 어떻게 발전하고 적용될지 기대가 됩니다.
오늘 뉴스레터가 여러분께 유익한 인사이트를 제공했길 바라며, 다음 시간에는 이번주 미국 증시를 떠들썩하게 만들었던 DeepSeek에 대해 흥미로운 주제로 찾아오겠습니다.😋
새해 복 많이 받으시고, 즐거운 하루 되세요