
2024년 AI 리서치 트렌드 결산
안녕하세요, 에디터 배니입니다.
즐거운 성탄절입니다! 어느새 2024년 마지막 뉴스레터입니다. 지난 7월에 2024년 상반기 트렌드를 전해드렸던 것 기억하시나요? 놓치신 분들이 있다면 링크 🔗를 따라 한 번 읽어보시는 것도 좋을 것 같습니다. 이번 뉴스레터에서도 2024년을 돌아보며 하반기에는 어떤 연구들이 진행됐는지 정리해보도록 하겠습니다.
AI 트렌드 1. 인간을 대신할 Agent
AI의 성능이 인간 수준에 이르렀다는 말은 많이 들어봤을 것입니다. 그렇다면 이러한 AI를 어떻게 활용할 수 있을까요? 인간이 어려워하는 일이나 단순한 반복 작업을 대신 시킬 수 있지 않을까 하는 생각이 드는데요. 이를 위해서 많은 AI Agent들이 개발되고 있습니다. 이제는 여러 개의 LLM을 결합하여 모델마다 역할을 만들어 인간의 사고를 흉내내거나, 실제로 인간이 작업하는 과정을 대신하도록 만드는 연구가 이어지고 있습니다.
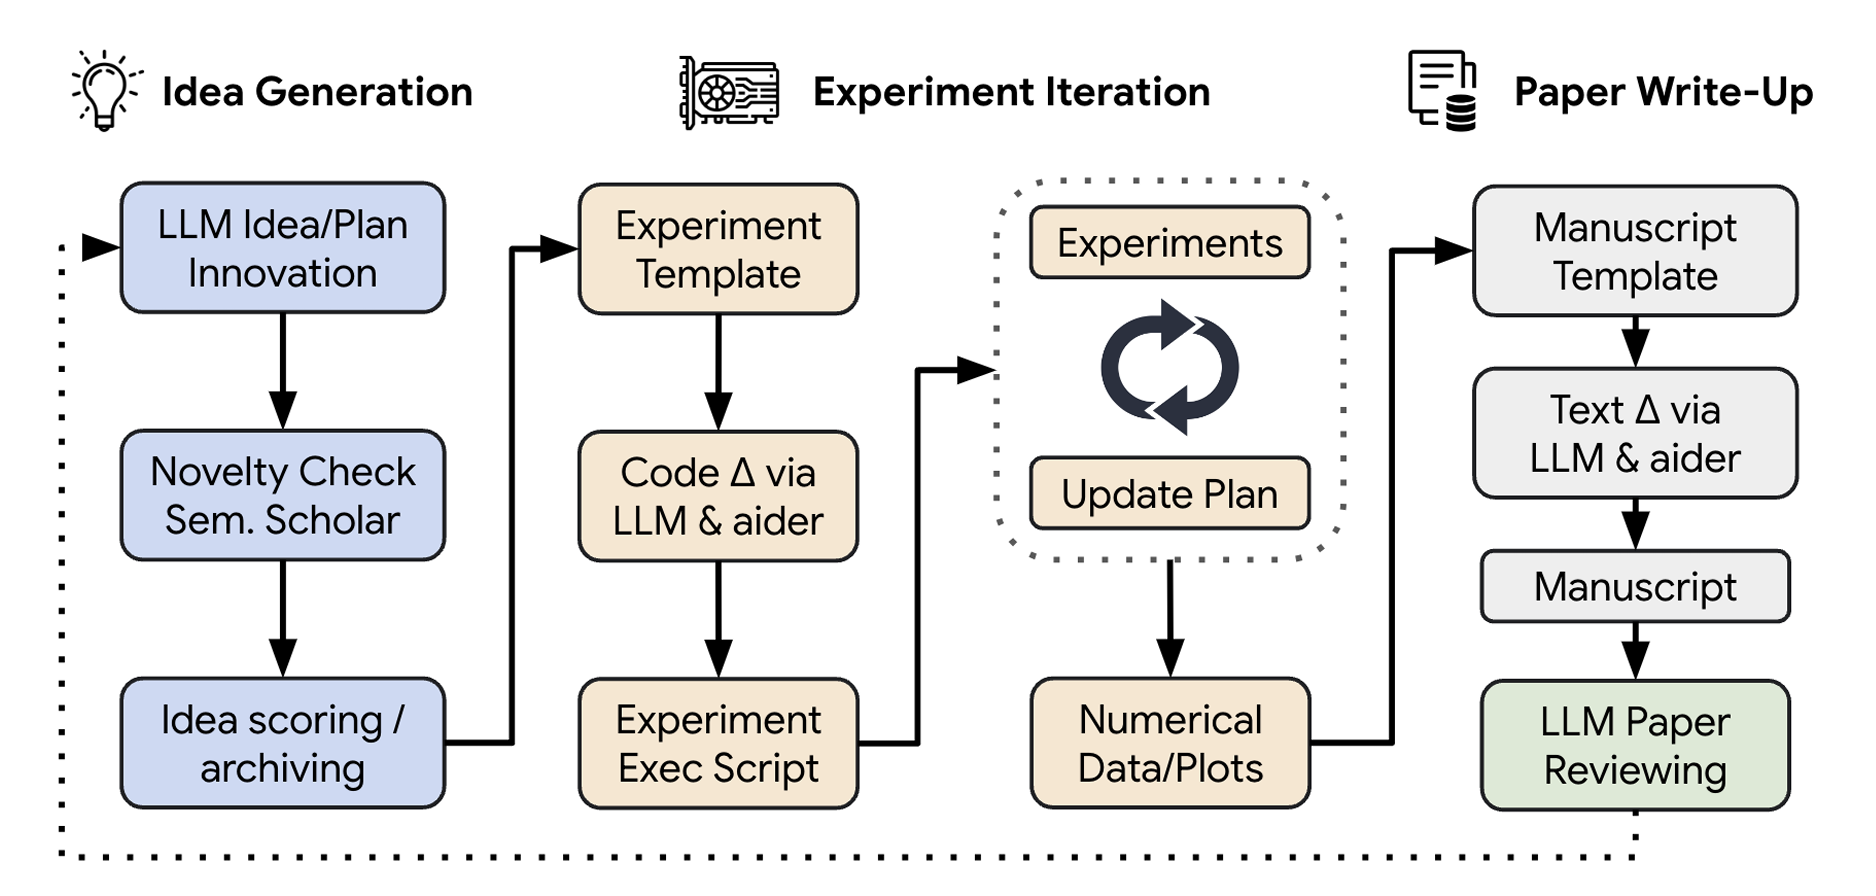
출처: The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery (Lu et al., 2024)
연구자들 사이에서 가장 화제가 됐던 연구는 The AI Scientist입니다. 말 그대로 AI가 AI 연구를 진행하는 것인데요. 아이디어를 제안하고 실험을 생성하며 실제로 논문을 작성하는 과정까지 모두 AI가 진행합니다. 가장 놀라운 점은 이렇게 연구 논문 하나를 작성하는 데 15달러만 지불하면 된다는 것입니다.
이외에도 어떤 사람의 인터뷰 내용을 토대로 AI Agent를 만들고, 실제 인간이 답한 설문과 AI Agent가 답한 설문이 얼마나 차이가 나는지 비교한 Generative Agent Simulation 연구도 있었습니다. 실험 결과 85%의 유사도를 보였는데요. 이렇게 1,000명의 생성형 에이전트를 개발하여 여러 페르소나를 가상화할 수 있다는 점에서 높은 연구 가치가 있습니다.
그리고 이제 특정 목적을 가진 Agent 개발을 넘어서서 Agent 개발에 필요한 기반을 자동화하고자 하는 연구도 발표됐습니다. 이는 Agent를 개발할 수 있는 Agent라는 점에서 Meta Agent라 불립니다. 또한 이렇게 개발된 Agent의 로그를 기반으로 다시 에이전트를 설계하며 디버깅하는 과정을 연구하기도 합니다.
AI 트렌드 2. 내가 필요한 정보를 찾아주는 RAG
ChatGPT, Claude와 같은 서비스는 많은 사람들이 함께 사용할 수 있도록 훈련됐습니다. 그러다 보면 어떤 상황에서는 일반적인 답변을 내놓는 경우가 있는데요. 어떤 때는 꼭 내가 참고하고 있는 문헌이나 지식 데이터베이스를 활용해서 답해야 하는 경우가 있습니다. 이런 데이터는 모델이 학습한 적도, 본 적도 없는 데이터일 가능성이 높습니다. 즉, 새로운 문서에 대해 사용자의 답변을 적절하게 답하기 어려운 상황인 것이죠. 이렇게 모델이 학습한 지식 외의 새로운 데이터에서 검색 결과를 증강해 답변을 생성하는 방식을 RAG(Retrieval-Augmented Generation)이라고 합니다. 최근 환각 현상을 줄이거나, 전문 분야 LLM 개발을 위해 RAG 연구가 활발하게 이뤄지고 있습니다.
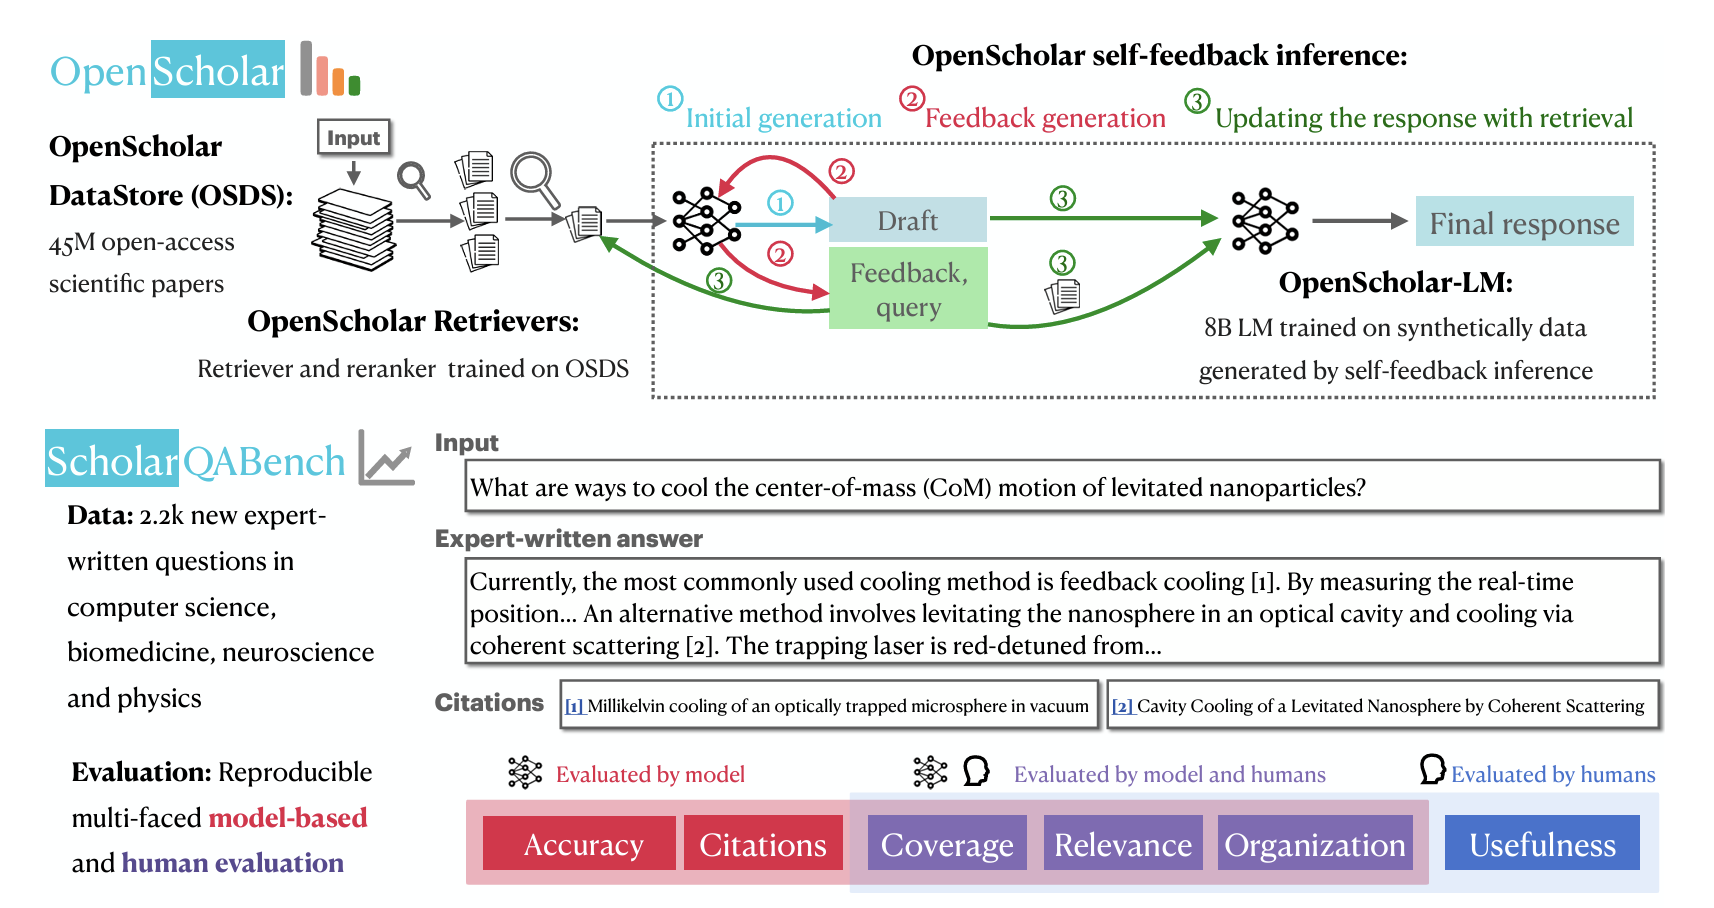
출처: OpenScholar: Synthesizing Scientific Literature with Retrieval-augmented LMs (Asai et al., 2024)
연구자 사이에서는 수많은 논문 중에서 내 연구를 도와줄 논문을 찾아준다면 참 편리하겠죠. 한 연구 주제는 보통 좁고 깊은 분야를 다루기 때문에 일반적인 답변으로는 원하는 결과를 얻기 어렵습니다. 이를 위해 과학 문헌을 쉽게 찾아줄 수 있는 OpenScholar 연구가 제안됐습니다. 이 모델은 다소 어렵고 전문적인 분야에 대한 내용에 대해서도 정확한 답변을 내고, 그와 관련된 인용 논문을 찾아주는 것이 특징입니다.
답변을 잘 생성하기 위해서는 수많은 문서 중에서 중요한 문서의 후보를 잘 만들어야 합니다. 예를 들어, ‘사기죄’와 관련된 법률 문서를 찾고 싶은데 수백 만 개에 달하는 모든 판례나 법률 조항 등의 문서를 찾아볼 필요는 없습니다. ‘사기’와 유사한 개념을 다루거나 ‘사기죄’와 관련된 다양한 판례 중심으로 찾는 것이 좋은 답변을 생성하는 방법일 것입니다. 이렇게 좋은 후보군을 만들기 위해서는 전체 문서에 대해 관련도 순위를 매겨야 하는데요. 기본적으로 검색된 문서에 대해 다시 순위를 매기는 과정인 Reranking 과정에 대한 연구도 이어지고 있습니다.
이를 위해서는 적절해서 검색 쿼리로 질문해서 좋은 후보 문서군을 만드는 것이 중요합니다. 즉, 좋은 질문을 던지는 것이 좋은 답변을 내는 지름길이라고 볼 수 있죠. 이를 위해서는 여러 차례 시도하면서 좋은 질문을 찾아나가는 과정이 필요합니다. 최근 Learning to Retrieve by Trying 연구에서는 검색 쿼리 자체를 학습 대상으로 삼고 유용한 결과를 반환하는 쿼리를 더 높게 평가하는 강화학습 방식으로 쿼리 품질을 향상시켰습니다.
지금까지는 텍스트에 국한된 얘기였는데요. 긴 문서 내에 포함된 이미지, 텍스트 등을 모두 이해하고 답변해준다면 훨씬 편리하게 정보를 검색할 수 있겠죠. 최근에는 RAG의 영역이 텍스트뿐만 아니라 멀티모달로 확장되고 있는 추세입니다. 하나의 이미지와 하나의 텍스트 프롬프트를 이해하는 수준을 넘어서 여러 페이지에 걸친 긴 문서의 데이터를 모두 해석하고 답변하는 모델에 관한 Multimodal RAG M3DocRAG 연구도 최근 발표됐습니다.
AI 트렌드 3. 효율적인 모델을 위한 양자화
AI 모델을 개발하기 위해서는 모델에 많은 데이터를 학습시켜야 합니다. 문제는 그런 모델을 개발하려면 영세한 기업에서는 감당하기 어려운 수준의 컴퓨팅 자원이 필요하다는 것입니다. 성능은 유지하면서 가벼운 모델을 개발하기 위해 적은 파라미터를 가진 모델이 지난해부터 꾸준히 제안됐습니다. 하지만 적은 파라미터라고 하더라도 여전히 실제 기기에서 연산하기에는 너무 많은 양이었는데요. 이때, 계산에 필요한 숫자 단위를 조정함으로써 연산량을 획기적으로 줄일 수 있습니다. 이렇게 컴퓨터 숫자 표현 범위 줄이는 방식을 Quantization(양자화)이라고 합니다. 예를 들어, 소수점 이하 100자리로 표현되던 숫자를 소수점 이하 4자리로 줄이게 되면 그만큼 필요한 연산량은 줄어들겠죠. 하지만 손실된 값만큼 정밀도는 떨어질 수밖에 없습니다. 때문에 정확도를 유지하면서 연산량은 줄이는 방법을 연구하고 있는 것이죠.
최근 제안되고 있는 많은 언어 모델은 Transformer 모델을 기반으로 합니다. 여기에는 Attention 매커니즘이 포함되어 있는데요. 이는 쉽게 말하면 두 행렬의 곱으로 이뤄집니다. 만약 입력된 문장의 길이가 100자(또는 100 토큰)이라고 하면 100 100의 10,000회의 연산이 필요합니다. 이보다 길이가 10배 늘어나서 1000자가 입력됐다면 1,000 1,000인 10,000,000회 연산이 이뤄집니다. 문장 길이가 10배 늘어나면 연산량은 100배 늘어나게 되죠. 이렇게 긴 문맥을 처리하기 위해서는 Attention 연산을 더욱 최적화하는 것이 중요합니다. 기존에 주로 활용하던 방식이 FlashAttention인데요. 지난 7월, FlashAttention의 세 번째 버전이 발표됐습니다. 이는 GPU의 메모리 읽기 / 쓰기 횟수를 줄여 성능을 개선하는 방식입니다. 두 번째 버전에서 GPU(H100)를 35% 정도밖에 활용하지 못한다는 사실을 알아내며 더 향상된 성능을 기대할 수 있었는데요. 이번에 블록 기반 연산과 Softmax 연산을 상호작용 방식으로 처리하여 GPU 자원을 더욱 효율적으로 활용하는 방법을 제안했습니다. 또한 정밀도가 낮은 숫자 표현에서도 성능을 유지하면서 동시에 정확도를 개선할 수 있는 방법을 제안하면서 Quantization 흐름에도 크게 기여했습니다.
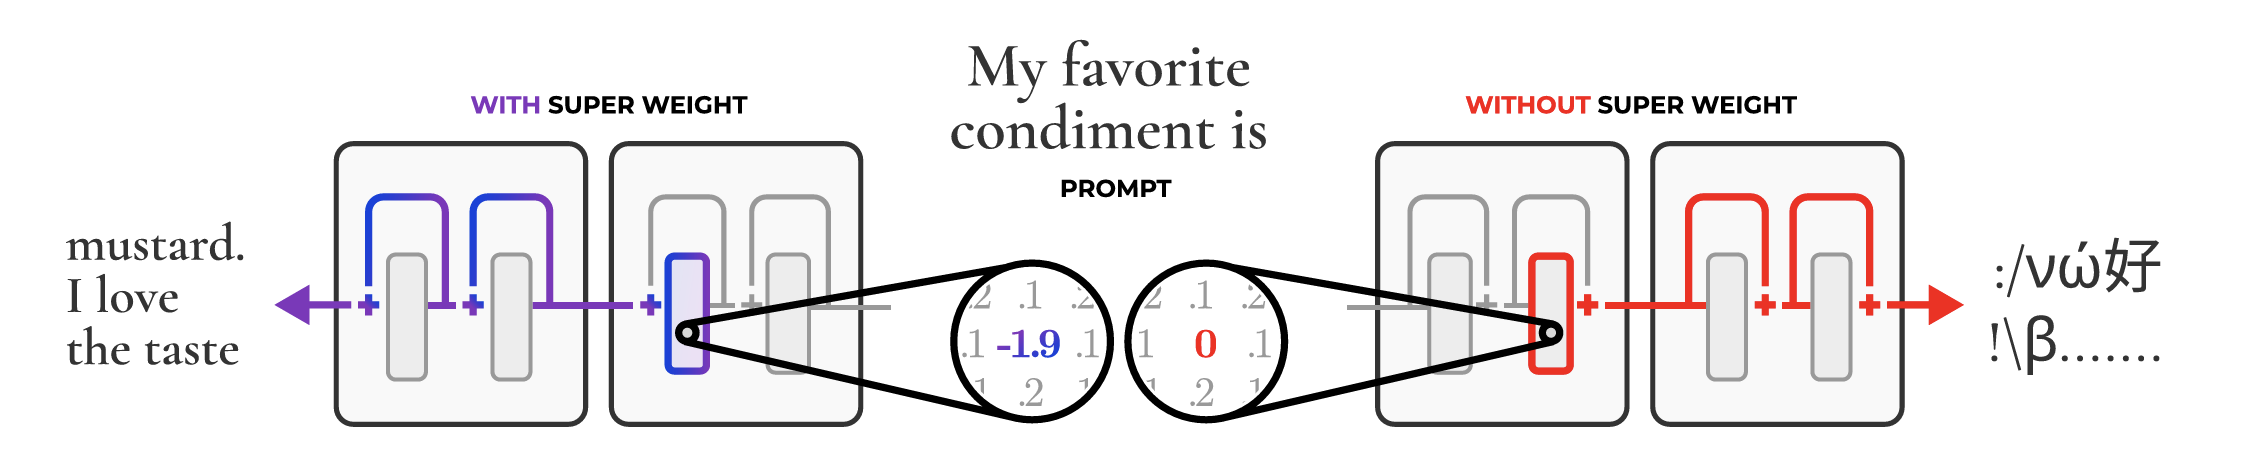
출처: The Super Weight in Large Language Models (Yu et al., 2024)
또한 Quantization이 높은 정밀도를 가진 숫자를 낮은 정밀도로 표현하는 만큼, 어떤 가중치가 실제 성능에 크게 영향을 미치는지 분석할 수 있습니다. 소수점 이하 100자리로 표현되던 값이 사실 정수와 같이 표현될 수 있었다면 그 값의 중요도를 매핑하는 것과 유사하다고 볼 수 있겠죠. 이런 아이디어와 관련해 전체 성능에 큰 영향을 미치는 일부 가중치가 발견됐다는 Super Weight 연구가 발표되기도 했습니다. 이런 가중치 숫자는 없애버릴 경우 약간이 아니라 완전히 엉망인 결과가 생성된다는 것입니다. 다르게 얘기하면 어떤 가중치는 일부를 삭제했을 때도 크게 영향을 미치지 않았다는 것이죠. 해당 가중치가 어떤 역할을 하고 있는지 면밀히 분석한다면 중요도가 낮은 가중치 부분은 가지치기하여 경량화된 모델을 만들 수 있을 것으로 기대합니다.
이렇게 2024년 하반기 발표된 논문을 중심으로 올해 달라지고 있는 세 가지 분야를 살펴봤습니다. 이밖에도 더 많은 AI 모델들과 서비스와 관련해 아래 링크에 정리했습니다. 지난 뉴스레터를 통해 전달드린 ai.gest 에디터 채니, 귤, 윤밤이와 함께 딥 다이브 에디터가 여러분들을 위해 준비한 만큼 많은 도움되길 바라겠습니다.
AI 관점에서 2024년을 회고해보자면, 이제 ‘AI 시대’라는 말이 사라지고 있다는 생각이 듭니다. ‘시대’는 보통 변화에 대한 기대감을 내포하고 있죠. 우리는 인터넷을 너무 당연하게 쓰지만 ‘인터넷 시대’라는 말을 잘 사용하지 않고, 모두가 핸드폰을 들고 있지만 ‘스마트폰 시대’라고 잘 표현하지는 않습니다. 더이상 사람들에게 AI가 낯설지 않습니다. 이제 AI 서비스, 디바이스, 로봇 등은 더욱 보편화될 것입니다.
2024년 트렌드는 이런 현실을 더욱 잘 보여줍니다. Apple에서는 AI를 더욱 잘 활용할 수 있는 UI를 연구하면서 이미 스마트폰을 이제 AI 디바이스로 개발할 준비를 하고 있죠. Agent는 이를 위한 초석을 다지는 과정이라고 볼 수 있습니다. RAG는 개인화 또는 전문화를 목표로 하고 있으며, 양자화는 컴퓨터보다도 더 가벼운 디바이스에서 실행할 수 있도록 만들어가는 과정이라고 볼 수 있습니다.
아마 내년에도, 그리고 앞으로도 이런 연구는 계속될 것입니다. 지금은 우리가 스마트폰을 쓰고 있지만 머지 않은 미래에는 모두 AI 디바이스를 들고 다니면서 소통하는 세계에 살게 되지 않을까 조심스럽게 추측해봅니다.
올해 딥 다이브 콘텐츠를 사랑해주셔서 진심으로 감사드립니다.
내년에도 흥미로운 AI 소식을 전해드릴 수 있도록 노력하겠습니다.
딥 다이브 콘텐츠 팀 올림