
사람의 행동을 보고, 따라할 수 있다고요?
안녕하세요, 에디터 잭잭 입니다. 얼마 전 가사도우미 로봇이 판매된다는 뉴스를 보게 되었는데요! 만약 제게도 로봇이 생긴다면, 어떻게 일을 가르칠지 고민을 한 적이 있습니다.
가위나 선글라스 같은 물체의 조작 방법을 로봇에게 가르친다고 생각해 볼까요? 가장 익숙한 방법은 물체를 집어 들어 로봇에게 보여주고, 직접 손으로 사용하는 방법을 시연하는 것이겠죠. 마치 어린아이들이 어른들을 보고 배우는 것처럼요!
Robot See Robot Do
행동을 따라 하려면, 일단 관찰해야 합니다. 어른의 손은 크고, 아이의 손은 작기 때문에 어른이 손으로 물체를 조작하는 방법과 완전히 동일하게 아이가 따라 하기는 어렵습니다. 중요한 것은 손의 움직임이 아니라, 물체에 초점을 두고 행동에 따른 물체의 변화를 관찰하는 것입니다. 만약 물체의 움직임을 인식할 수 있다면, 인식된 움직임을 재현하도록 물체를 조작하는 계획을 세울 수 있어요!
Robot See Robot Do 모델을 사용하면, 로봇은 사람이 물체를 조작하는 영상을 보고 별다른 학습 없이 물체를 조작할 수 있습니다. 즉, 제로 샷으로 수행이 가능하다는 뜻입니다. 로봇을 학습시킬 때 사람의 영상을 활용하는 기존 연구들은 추가적으로 로봇을 조작하기 위한 데이터 혹은 좋은 설명이 달린 데이터 셋을 필요로 했습니다. RSRD는 어떻게 제로 샷으로 이 과정을 수행할 수 있었을까요?
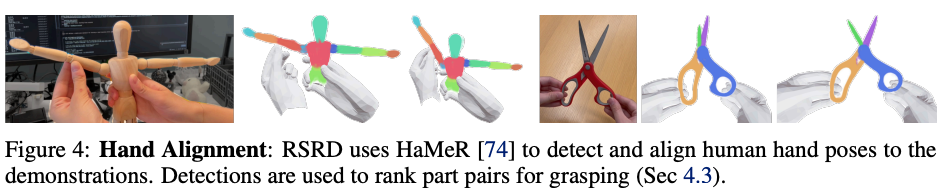
RSRD는 객체 중심적으로 접근한 방법이에요. 여러 각도에서의 물체 사진과 객체 중심적으로 촬영한 사람의 시범 영상만을 필요로 합니다. ‘Robot See, Robot Do’라는 모델 이름과 같이, 'See' 단계에서 로봇은 물체의 모델을 렌더링하고, 움직일 수 있는 그룹(ex. 안경다리와 몸통)으로 나누어 움직임 궤적을 3D로 복원해요. 'Do' 단계에서 로봇은 알 수 없는 포즈로 있는 물체를 제공받게 되는데요. 로봇은 앞선 단계에서 얻은 물체의 움직임 궤적을 실제 물체의 포즈로 맞추고, 사람의 시범 영상에서 관찰된 것과 동일하게 움직이기 위해 양 손의 궤적을 계획하는 것이죠.
시간을 기준으로 부품의 움직임을 나타내기
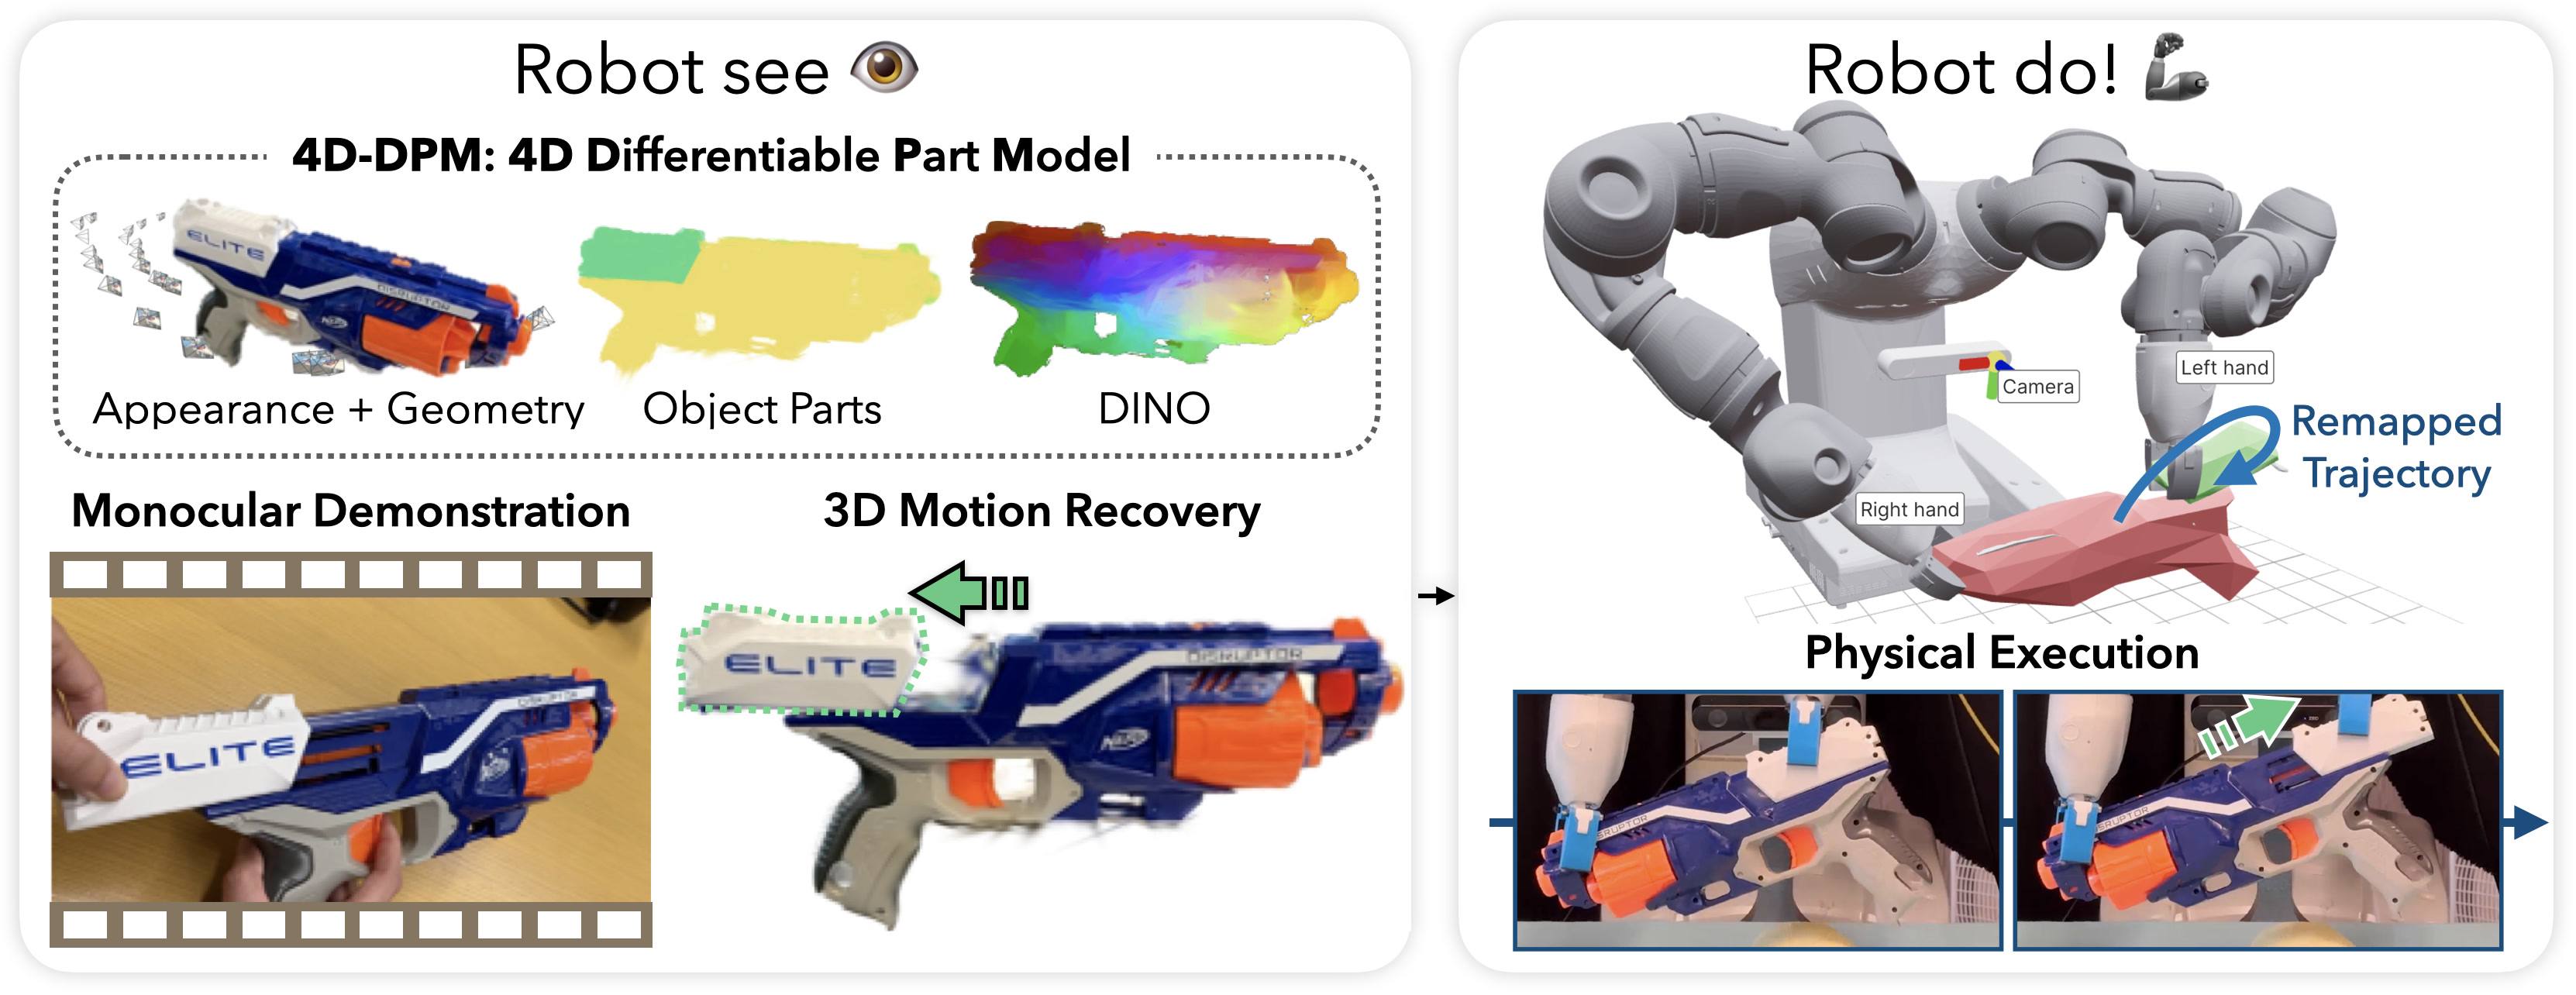
물체의 3D 움직임 궤적을 복원하는 것은 시간과 공간에 걸쳐 물체의 각 부품별로 자세(포즈)를 추적해야 하기 때문에 쉽지 않은 과정이에요. 이에, 연구진은 움직이는 부품의 위치와 자세를 시간에 따라 최적화하는 방법인 4D-DPM을 제안했습니다.
4D-DPM은 ‘시범 영상’과 ‘여러 각도에서 물체를 촬영한 사진’ 을 입력으로 받습니다. 여러 각도에서 촬영된 물체의 사진들은 Gaussian Splatting (3DGS)을 통해 3D 모델로 변환돼요. 동시에, 같은 사진들을 사용해 GARField를 학습하여, 3D 가우시안을 여러 개의 세부 그룹으로 군집화하고, 물체를 3D 부품으로 분해합니다.
이후 분해된 물체의 부품을 4차원(3D 공간 + 시간)에서 모델링 하여, 각 시간 단계에서 렌더링 된 RGB 이미지, 깊이 맵, 그리고 DINO 특징 맵을 생성합니다. 이 렌더링 된 정보들은 입력 비디오에서 추출된 정보와 비교하여 부품의 움직임을 최적화하는 데 사용됩니다.
이렇게 렌더링 된 3D 물체 부품의 움직임 궤적을 알아내기 위해 '합성에 의한 분석(analysis-by-synthesis)' 접근 방식을 사용하는데요! 즉, 시간에 따라 물체 부품의 모델을 합성하여 물체의 움직임을 이해하고, 4D 부품의 포즈를 시간에 따른 궤적으로 표현하는 것입니다.
실제로 해당 모델을 사용한 로봇으로 실험을 해 보았더니, 로봇은 초기 자세 등록에서 94%, 궤적 계획에서 87%, 초기 그립과 움직임 실행은 각각 83%와 85%의 성공률을 달성했다고 합니다. 과업별 학습, 미세 조정, 데이터 수집 또는 주석 작업 없이 달성되었다는 점을 고려했을 때, 좋은 결과를 보여준 것 같습니다.
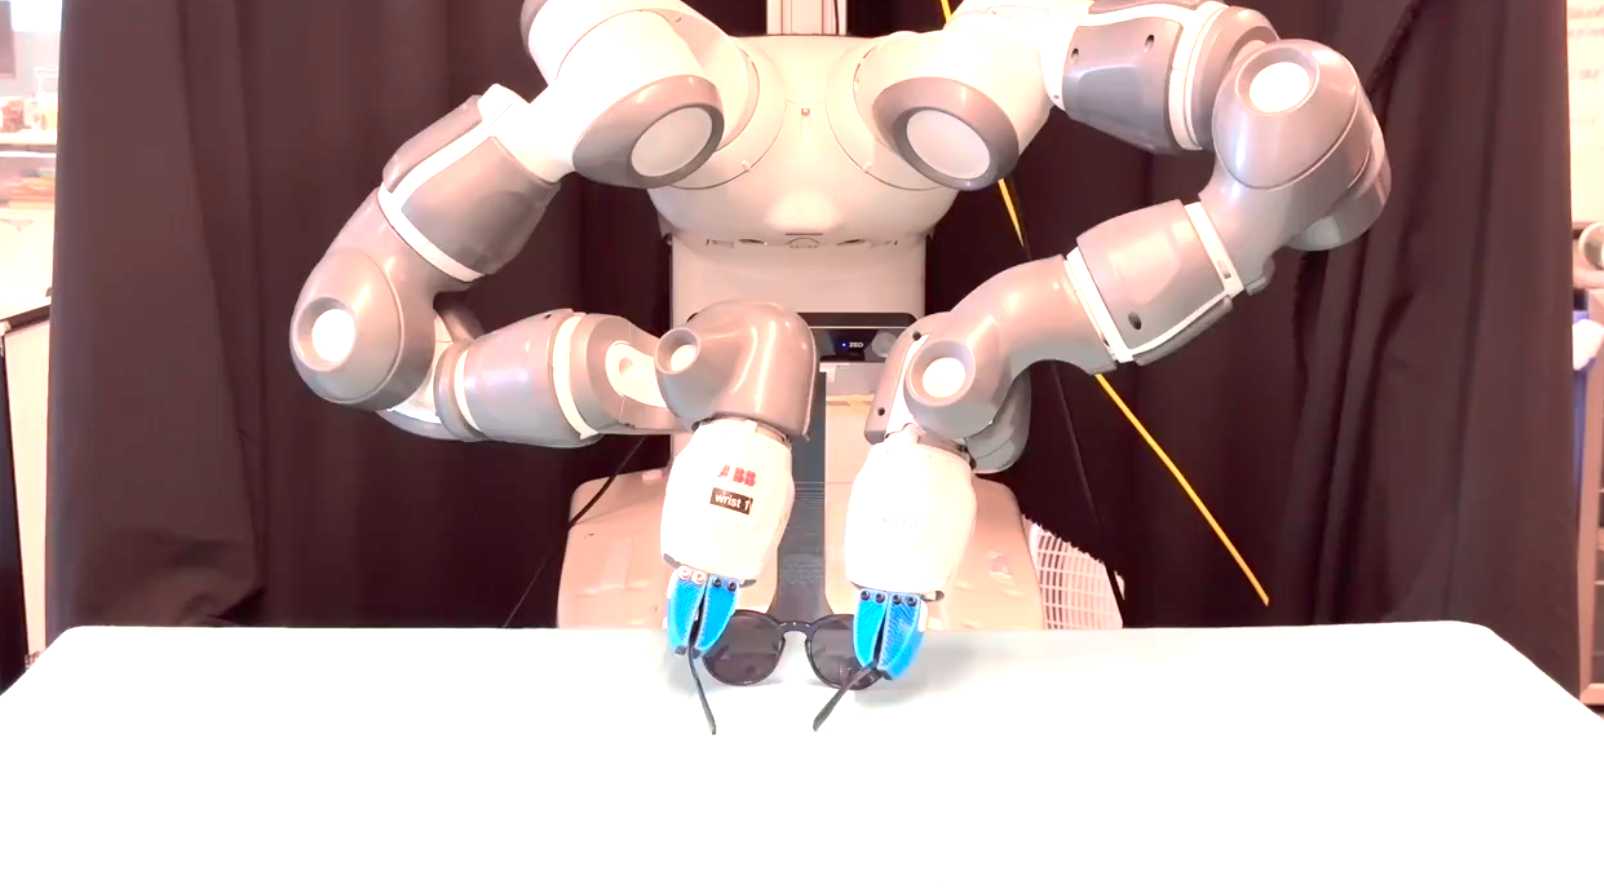
로봇이 어떻게 동작하는지 보고 싶다면, 아래 링크에서 영상을 확인해 보세요!
로봇과 관련하여 아직