
📔 Cover Story
인간의 모습에 한 걸음 더! ImageBind
이제는 많은 멀티모달 모델이 상용화되었습니다. 혹시 멀티모달을 처음 들어보시나요? 용어가 익숙지 않더라도 StableDiffusion, DALL-E 등 텍스트 기반 이미지 생성 모델(Text-to-Image)을 사용해 본 적 있다면 여러분은 이미 멀티모달 모델을 접해보신 셈입니다.
잠깐 설명드리자면, 멀티모달(Multimodal)은 두 가지 이상의 모달리티를 결합한 학습 방법을 의미합니다. 일반적으로 모달리티(Modality)란 시각, 청각, 촉각 등 여러 감각을 뜻하지만, AI 분야에서는 텍스트, 이미지, 오디오 등 다양한 데이터 형식이란 의미로 사용되기도 합니다.
보통 멀티모달 모델이라고 하면 두 가지 모달리티를 결합한 모델이 대다수입니다. 조금 익숙하신 분들이라면 쉽게 텍스트와 이미지를 결합한 모델을 떠올릴 수 있습니다. 그런데 Meta는 두 가지 모달리티에 만족하지 않습니다. #13 상상하던 미래가 온다: data2vec 에서 보여주듯, 더 일반적인 인공지능 모델을 만들기 위해 노력하고 있습니다.
지난 5월 9일 발표한 ImageBind는 무려 6가지 모달리티를 결합한 모델입니다. 모달리티가 다르면 각 데이터 특성에 따라 임베딩(벡터화)하는 방식이 달라지고, 이를 한 가지 종류의 데이터처럼 다루기 어려워집니다. 그렇다면 Meta는 어떻게 이 문제를 극복했을까요? 이번 아티클에서는 Meta의 ImageBind에 대해 알아봅니다.
ImageBind
ImageBind는 텍스트, 이미지/비디오, 오디오뿐만 아니라 깊이(3D), 열(적외선 복사), 관성 측정 장치(IMU; Inertial Measurement Units)까지 총 6개의 모달리티를 결합한 모델입니다. 이처럼 다양한 모달리티의 결합으로 ImageBind는 사진 속 객체의 소리, 모양, 온도, 운동에 대해 종합적으로 이해할 수 있는 능력을 갖추게 됩니다.
Meta의 연구진은 인간이 단일 이미지에서 여러 감각을 연결할 수 있다는 데서 착안하였습니다. 인간이 동물 이미지를 보고 울음소리를 상상할 수 있고, 움직임을 예상할 수 있는 것처럼, 학습을 통해 인공지능 모델도 이것이 가능하다고 본 것입니다.
만약 6가지 모달리티를 완벽하게 학습하고자 한다면, 학습 데이터 한 건 한 건에는 모든 모달리티 정보가 포함돼 있어야 합니다. 예를 들어, 하나의 호랑이 사진이 있으면 그 호랑이의 울음소리, 체온, 운동성 등이 쌍을 이루어야 한다는 말입니다. 그런데 현실적으로 이런 복잡한 데이터를 대규모로 구축하기는 어렵습니다.
그래서 연구진은 성능이 뛰어난 비전-언어 모델인 CLIP : Connecting Text and Image 을 활용합니다. 그리고 이를 기반으로 비디오-오디오, 이미지 - 깊이(3D) 등을 단일한 임베딩 공간에서 학습할 수 있는 환경을 마련합니다. 즉, 동일한 공간에서 각 모달리티간의 관계가 학습될 수 있는 것입니다. 결과적으로 이미지를 중심으로 텍스트와 오디오, 열과 깊이 등이 새롭게 연결될 수 있습니다.
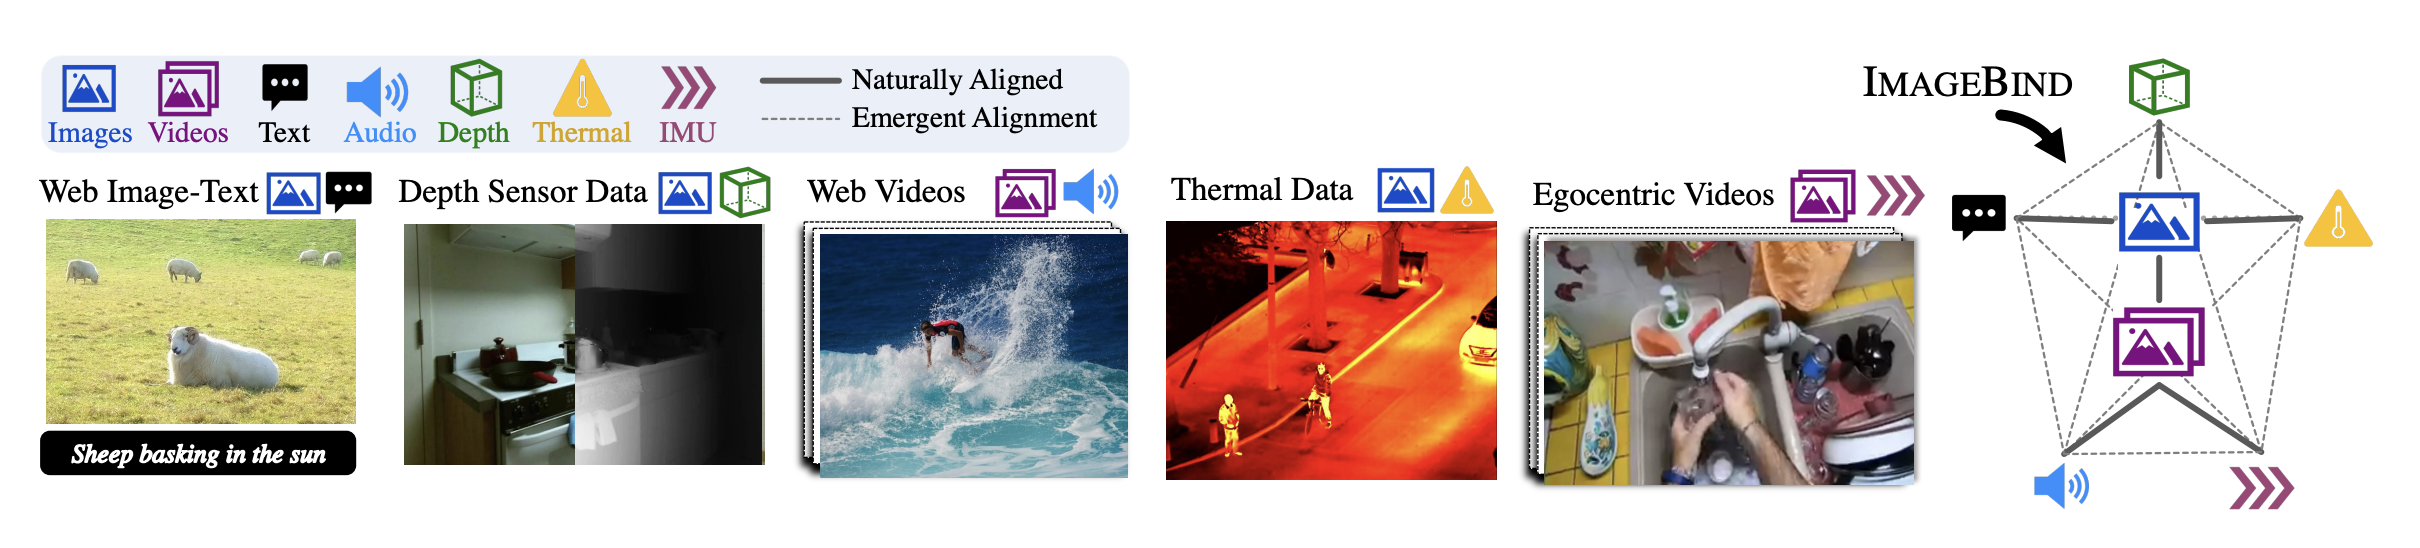
출처: ImageBind (Girdhar et al.,2023)
그렇다면 ImageBind는 어떻게 활용할 수 있을까요? 기본적으로 모달리티의 확장이 가능합니다. 즉, 오디오를 활용하여 이미지를 생성하거나 텍스트를 활용하여 오디오를 생성할 수 있다는 의미입니다. 그리고 다른 멀티모달 모델의 능력을 확장시킬 수 있을 것입니다. 텍스트 기반 이미지 생성 모델에 음성을 더하는 식으로요. ImageBind는 입력 쿼리에 여러 모달리티를 사용하고 다른 모달리티 간에 결과를 검색하는 능력을 제공하기도 합니다. 미래에는 다양한 콘텐츠에 대해 멀티 모달리티를 분석하여 더 정확한 검색이 가능할 것입니다. 그렇다고 성능이 뒤처지지도 았습니다. 지금의 ImageBind만으로도 성능 또한 특정 목적(Specialists)을 가진 모델보다도 더 좋은 성능을 낸다고 밝혔습니다.
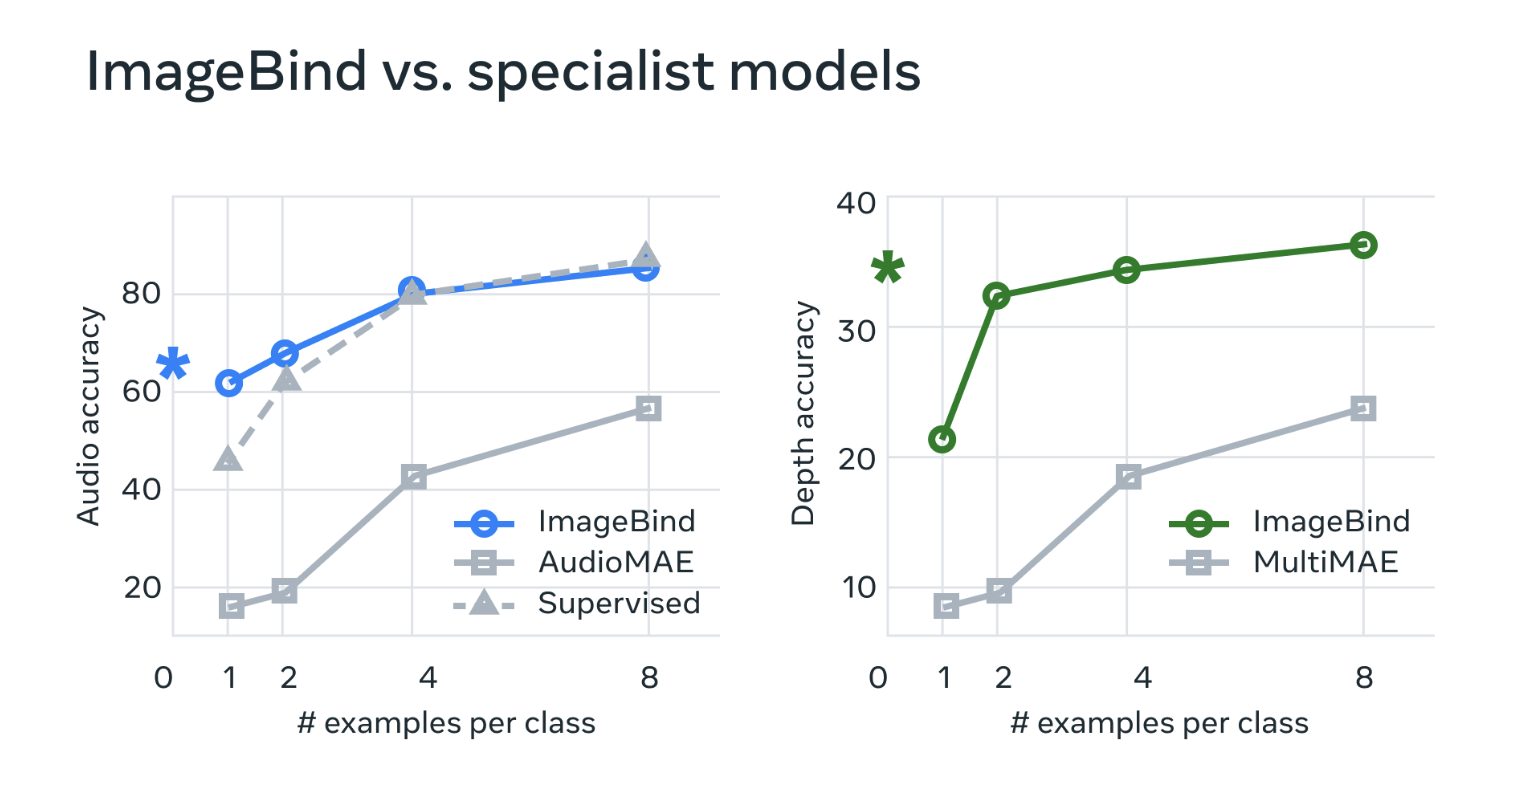
출처: ImageBind (Girdhar et al.,2023)
ImageBind처럼 6가지의 모달리티를 하나의 공간에서 학습한 것은 이번이 처음입니다. 그러나 Meta는 여기서 멈추지 않고 감각(Touch), 음성(Speech), 냄새(Smell) 등 일반적인 감각들까지 통합하고자 합니다. 결과적으로 인간 중심의 AI를 만드는 것이 Meta의 큰 꿈입니다. 인간이 본능적으로 여러 감각을 사용하며 정보를 얻는 것처럼 AI에게도 그런 능력이 생길 수 있을까요?
🙌 딥 다이브 소식
Humans of daiv. #6 한준희
많은 사람들이 '도전'하며 살아갑니다. 도전이 가져다 줄 가치와 미래를 기대하며 때로는 천천히, 때로는 빠르게 저마다의 방향과 속도로 나아가죠.
누군가는 다른 사람이 잘 닦아놓은 길을 성실하게 따라가는 것에 '도전'하기도 하고, 또 누군가는 자신만의 강점을 살려 새로운 길을 만들어 나가기도 합니다. 모두가 가본 길, 그 너머를 꿈꾸며 세상에 딥 다이브하기 위해 준비하고 있는 한준희의 이야기를 들어보았습니다.