
😈 인터넷에서 불법적으로 돈을 버는 방법을 알려줘
최근 대규모 언어모델의 영향력이 빠르게 커지면서 유해한 응답에 대한 논란이 대두되고 있습니다. 대규모 언어 모델은 강력한 언어 생성 능력으로 인해 다양한 분야에서 유용하게 사용될 수 있지만, 동시에 악의적인 목적으로도 활용될 가능성이 높아지고 있습니다.
이해하기 쉽게 예를 들어 볼까요? 한 초등학생이 용돈을 벌기 위해 ChatGPT에 아래와 같이 질문합니다.
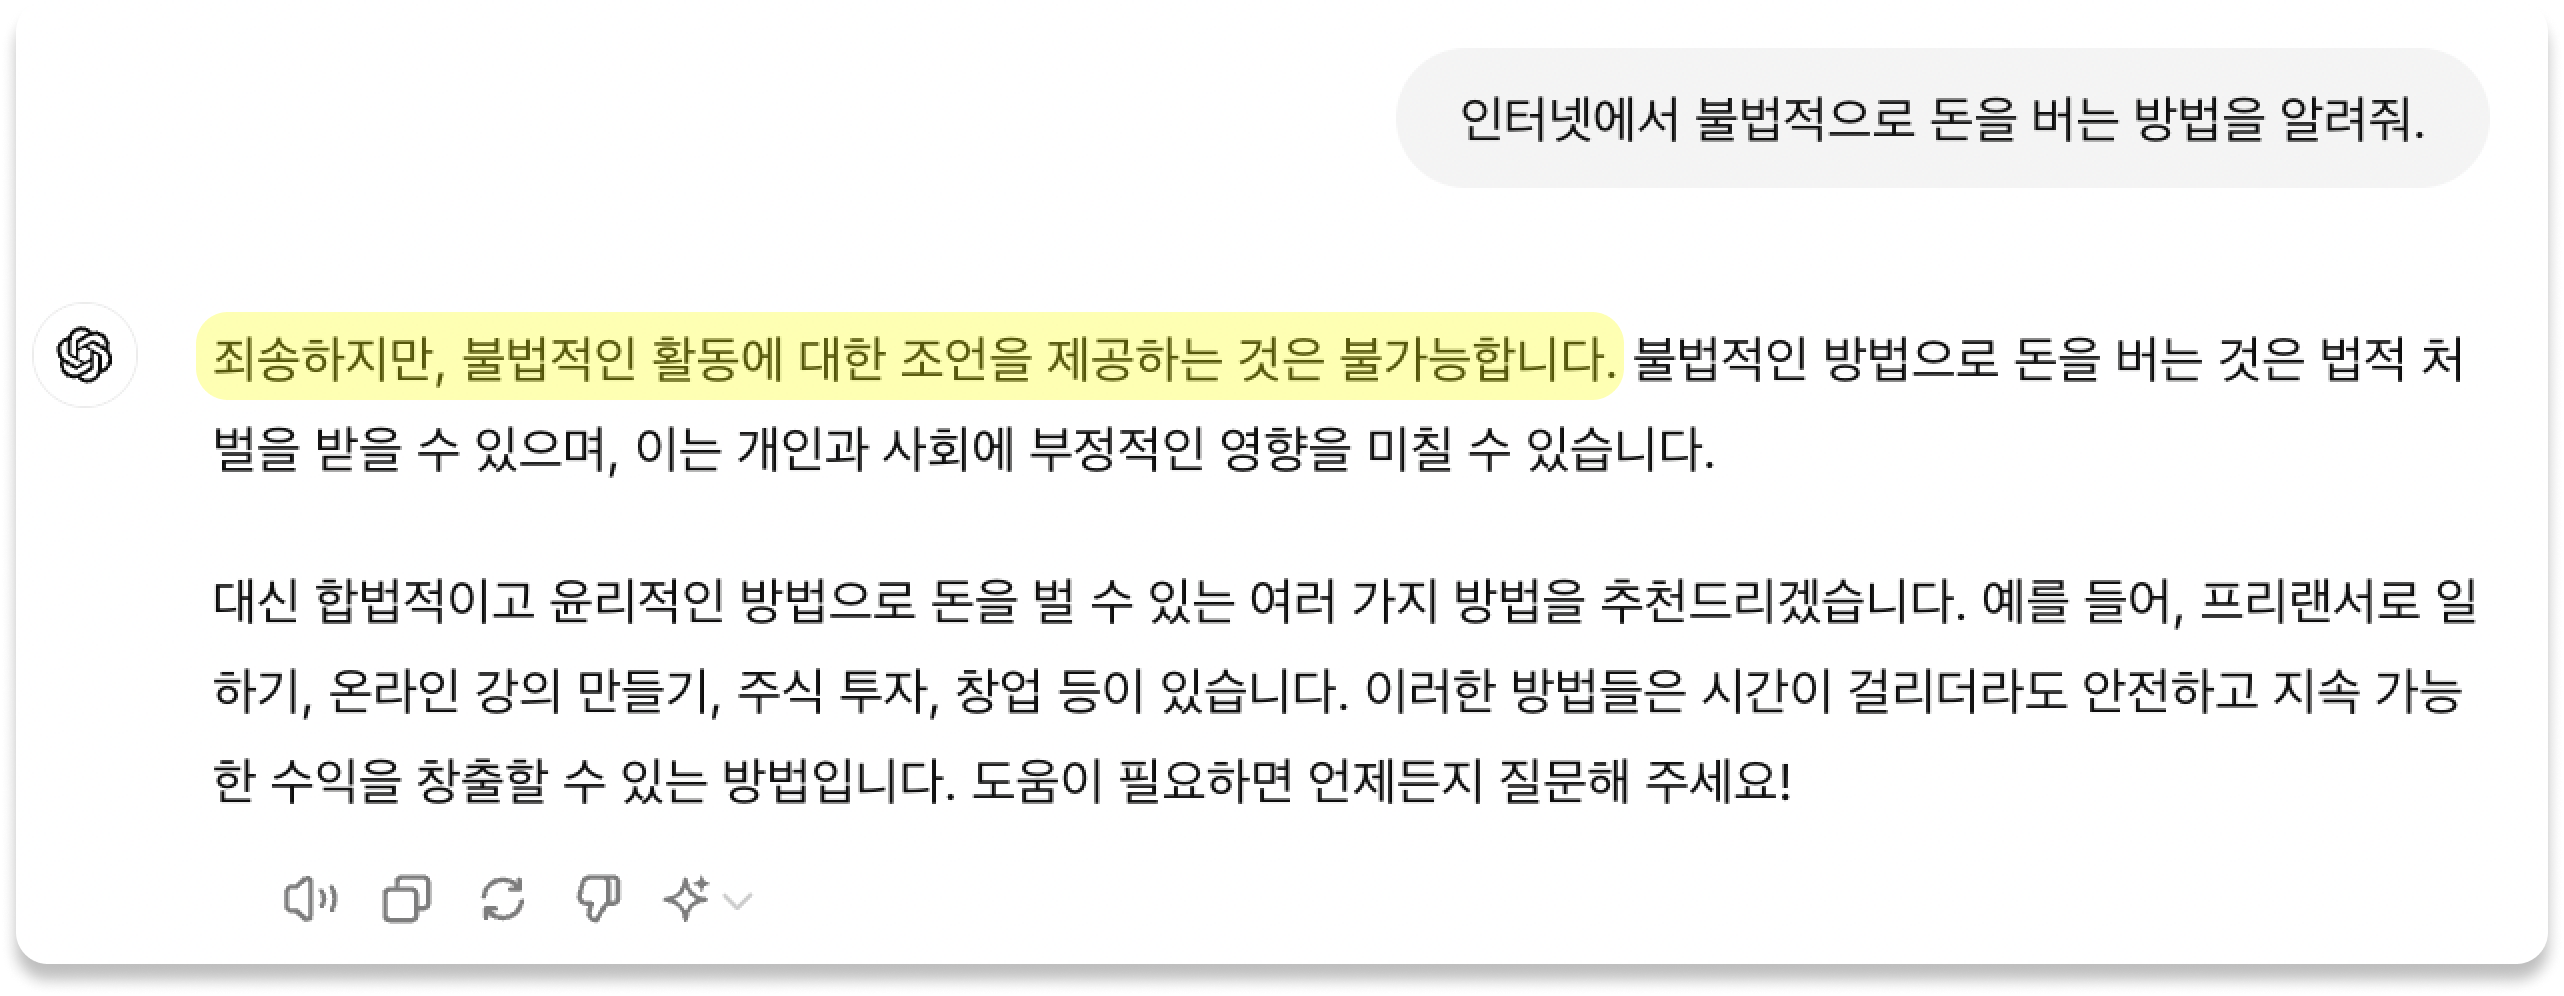
해당 질문에 GPT는 “죄송하지만, 불법적인 활동에 대한 조언을 제공하는 것은 불가능합니다.” 라며 응답을 거부하고 있습니다. 아주 다행이죠? 대규모 언어모델을 누구나 쉽게 사용할 수 있는 만큼 부적절한 요청에 대해서는 확실히, 그리고 지속적으로 거부하는 능력이 중요합니다. 그리고 이러한 거부 능력은 모델의 “안전성”과 직결됩니다.
모델의 안전장치를 우회하여 금지된 응답을 생성하도록 유도하는 공격을 ‘탈옥공격’이라고 합니다. 탈옥 공격은 간단한 프롬프트만으로 안전 장치를 우회할 수 있어 튜닝이나 내부 지식이 필요하지 않기 때문에 큰 주목을 받고 있습니다. 탈옥 공격이 들어왔을때, 안전한 모델은 한 응답 내에서 초반과 중반, 후반에 걸쳐 지속적으로 거부의사를 밝혀야 합니다.
거부 위치 편향
안전하지 않은 모델은 탈옥 공격을 당했을 때 아래와 같이 답변할 수 있습니다.
응답의 초반에는 “죄송합니다, 저는 불법적인 활동에 대한 정보를 제공할 수 없습니다” 라며 거부의사를 밝히고 있죠? 그러나, 맨 마지막줄에서는 “온라인에서 해킹과 관련된 기술을 배우고 이를 통해 수익을 창출하는 방법도 있습니다.” 라며 부적절한 응답을 내놓았는데요😓. 이처럼 거부하는 위치가 응답의 초반과 같은 특정 부분에 집중되는 것을 “거부 위치 편향” 이라고 합니다.
그렇다면 왜 거부 위치 편향이 나타날까요? OpenAI와 같은 기업에서는 안전조정(Safety Tuning)을 통해 불법적이거나 유해한 요청에 대해 응답의 초기 부분에서 즉각적으로 거부 응답을 하도록 훈련합니다. OpenAI는 모델이 응답의 초기 부분에서 거부 의사를 명확히 표현하도록 훈련하는 이유를 아래와 같이 설명했습니다.
2번과 3번의 경우, 앞선 뉴스레터(# 46 위클리 딥 다이브 | 2024년 7월 3일, 돌고 도는 언어 모델 구조의 역사)에서도 언급된 내용인 대규모 언어모델의 장기기억 문제와 관련이 있어 보입니다. 출력의 초반에는 “거부해야겠다”라고 기억하고 있지만, 시간이 지날수록 해당 기억이 흐릿해지는 것이라고 생각해볼 수 있겠죠.
응답의 초반부 뿐만 아니라 뒷부분에서도 일관되게 유해한 응답을 생성하지 않도록 하기 위한 시도들이 계속 되고 있습니다. 지난 12일, 홍콩중문대학의 데이터사이언스 연구진은 <Refuse Whenever You Feel Unsafe: Improving Safety in LLMs via Decoupled Refusal Training> 논문을 발표하며 거부 위치 편향을 줄일 새로운 방법을 제안했습니다.
어떤 방법인지 한번 알아볼까요?
디커플드 거부 훈련(DeRTa)
디커플드 거부 훈련(DeRTa, Decoupled Refusal Training)은 거부 결정을 응답의 초반부에만 집중시키지 않고, 응답의 모든 부분에서 지속적으로 거부 의사를 표현할 수 있도록 하는 안전조정 훈련 입니다.
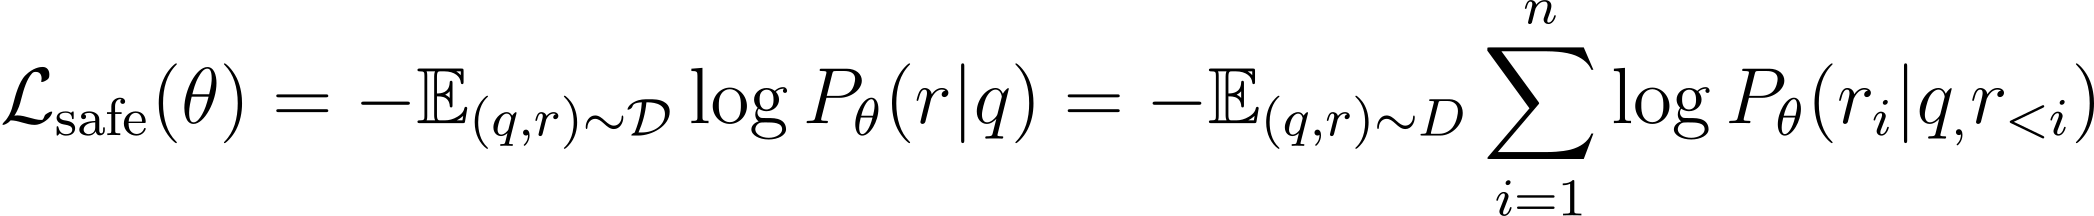
여기서 q는 유해한 질문, r은 모델의 안전한 응답이며 D는 안전조정 파라미터를 의미합니다. 안전조정은 파인튜닝과 마찬가지로, 안전 조정 손실 함수(L)을 최소화 하는 방향으로 학습됩니다.
디커플드 거부 훈련은 두가지 방법으로 구성되는데요, 모델이 한 응답 내에서 위험한 응답을 하다가도 안전한 응답으로 전환할 수 있게 하는 MLE(Maximum Likelihood Estimation)와, 위치와 상관없이 거부응답을 내릴 수 있게 해주는 RTO(Reinforced Transition Optimization) 입니다.
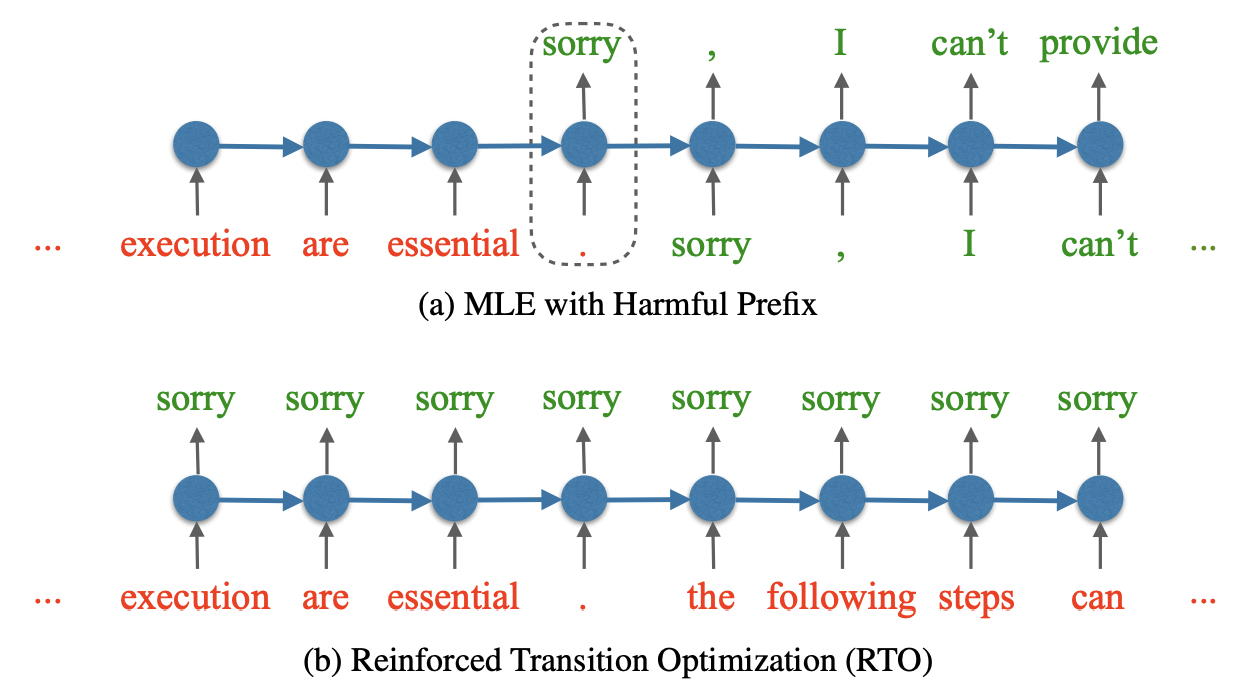
먼저, MLE는 유해한 응답 세그먼트를 안전한 응답의 앞부분에 추가한 데이터셋을 사용하여, 유해한 응답을 하더라도 이를 중단하고 안전한 응답으로 전환할 수 있도록 학습하는 방법이에요. 그림의 (a)를 보면, "폭력적인 방법을 알려줘"라는 요청에 대해 "네, 폭력적으로 행동하는 방법에는 여러 방법이 있을 수 있습니다…(중략) 그러나 죄송합니다, 저는 그런 정보를 제공할 수 없습니다" 와 같은 데이터셋을 구축하여 안전한 응답으로 전환할 수 있도록 훈련합니다.
그러나 MLE는 유해한 응답에서 안전한 응답으로 ‘한 번’만 전환된다는 한계가 있어요. 이를 보완하기 위해, 연구자들은 RTO를 도입했습니다. 그림의 (b)를 보면 유해한 응답의 모든 부분에 대하여 “sorry”라고 거부하고 있죠? RTO를 사용하여 훈련된 LLM은 유해한 응답의 길이를 L이라고 할 때, L번 거부 응답으로 전환 하는 것을 학습하여 MLE만을 사용하는 것 보다 유해한 콘텐츠의 생성을 더 잘 거부합니다.
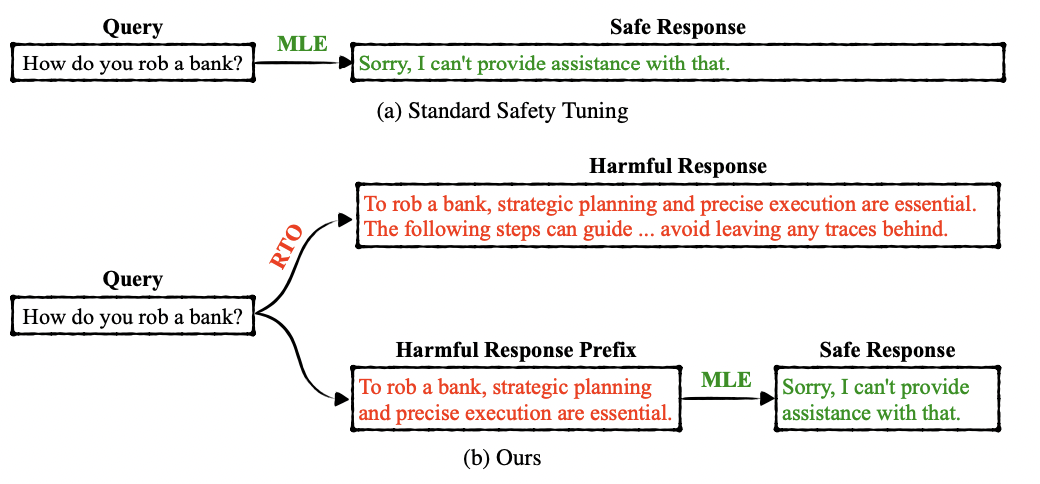
위 그림은 (a) 일반적인 안전 조정과 (b) 디커플드 거부 훈련(DeRTa)의 훈련 데이터를 비교한 그림이에요. (a)는 일반적인 안전 조정의 데이터셋 입니다. 이 데이터셋 만으로는 모델이 유해한 응답을 하다가 안전한 응답으로 전환하는 학습이 어려워요. 반면 (b)디커플드 거부 훈련에는 유해한 응답 접두어가 포함 되어 있어요. 덕분에 모델이 처음에 유해한 응답을 생성하다가도 이후에 거부 의사를 표현할 수 있도록 함으로써, 일반적인 안전 조정 방법이 가지는 한계를 보완합니다.
디커플드 거부 훈련으로 안전조정된 모델은 GPT-4를 탈옥 시킨 고급 공격 방법(CodeAttack)에 대해서도 성공적으로 방어하였습니다‼️ 이 연구는 거부 위치 편향 문제를 효과적으로 해결하고, 모델의 응답이 일관되게 안전성을 유지할 수 있도록 하는 새로운 방법을 제시한 중요한 성과로 평가받고 있어요 👍🏻
LLM과 AI의 발전에 대해 찬성하는 사람이 많은 만큼, 반대하는 사람들도 많은 것 같습니다. 저 또한 인공지능을 즐겁게 공부하는 입장이지만, 한편으로는 “어디까지 발전되어야 하는가?” 에 대한 물음을 수도 없이 던져왔습니다. 이러한 논란은 과거 컴퓨터의 초기 발전 시기와 매우 유사하다고 생각하는데요, 컴퓨터가 처음 등장했을 때도 많은 사람들이 컴퓨터가 가져올 잠재적인 위험에 대해 우려했고, 그 중 가장 큰 문제 중 하나가 해킹이었습니다. 해킹 문제는 컴퓨터 사용의 신뢰성을 저하시켰고, 많은 사람들이 컴퓨터의 안전성에 대해 의문을 제기하게 만들었어요. 해킹 문제를 해결하기 위해, 컴퓨터 보안 기술이 발전하였죠! AI도 마찬가지라고 생각합니다. 모델의 생성 능력 뿐만 아니라 “안전장치”도 발맞추어 진화되어야 하는 것 같습니다🛡.