
2024년 상반기 AI 리서치 트렌드 총정리
안녕하세요, 에디터 배니입니다.
어느새 2024년도 절반이 지났습니다. AI는 연구 분야가 다양해지고, 새로운 서비스가 공개되면서 사용자들에게 더욱 친숙해졌습니다. 이제 AI를 도입하지 않은 IT 기업은 찾아보기 어려울 정도입니다. 지난 올 한 해를 떠올려보면 Sora, Gemini 1.5, Llama 3, Claude 3.5 등 굵직한 모델들이 떠오릅니다.
이렇게 새로운 서비스가 등장할 수 있었던 배경에는 첨단의 연구들이 빠르게 발전하고 있기 때문입니다. 매주 수 백 개의 AI 논문이 발표되고, 연구 분야도 점차 다양해지고 있는 만큼 AI 트렌드도 빠르게 변화하고 있는데요. 이렇게 쏟아지는 AI 리서치, 이번주 뉴스레터는 2024년 상반기 AI 연구 분야와 관련해 총 정리해봤습니다.
AI 트렌드 1. Long-Context
LLM의 성능이 점차 개선되면서 연구자들이 주목한 부분은 Long-Context입니다. 언어 모델에 있어 Long-Context란 말 그대로 ‘긴 문맥’을 이해하는 능력을 의미합니다. 초기 언어 모델은 프롬프트에 입력되는 길이가 제한적이고, 길이를 늘이면 성능이 떨어지는 현상이 나타났습니다. 이는 제한된 연산량과 모델 자체의 한계 때문이었는데요. 최근에는 웬만한 200쪽짜리 책을 한 번에 이해할 수 있는 수준에 이르렀습니다. 언어 모델이 Long-Context를 이해하기 위해서는 기존의 제한된 길이의 Position Embedding 방식을 개선하고 긴 문맥 길이에 따라 연관 있는 부분을 잘 찾도록 학습 구조를 변경해야 합니다.
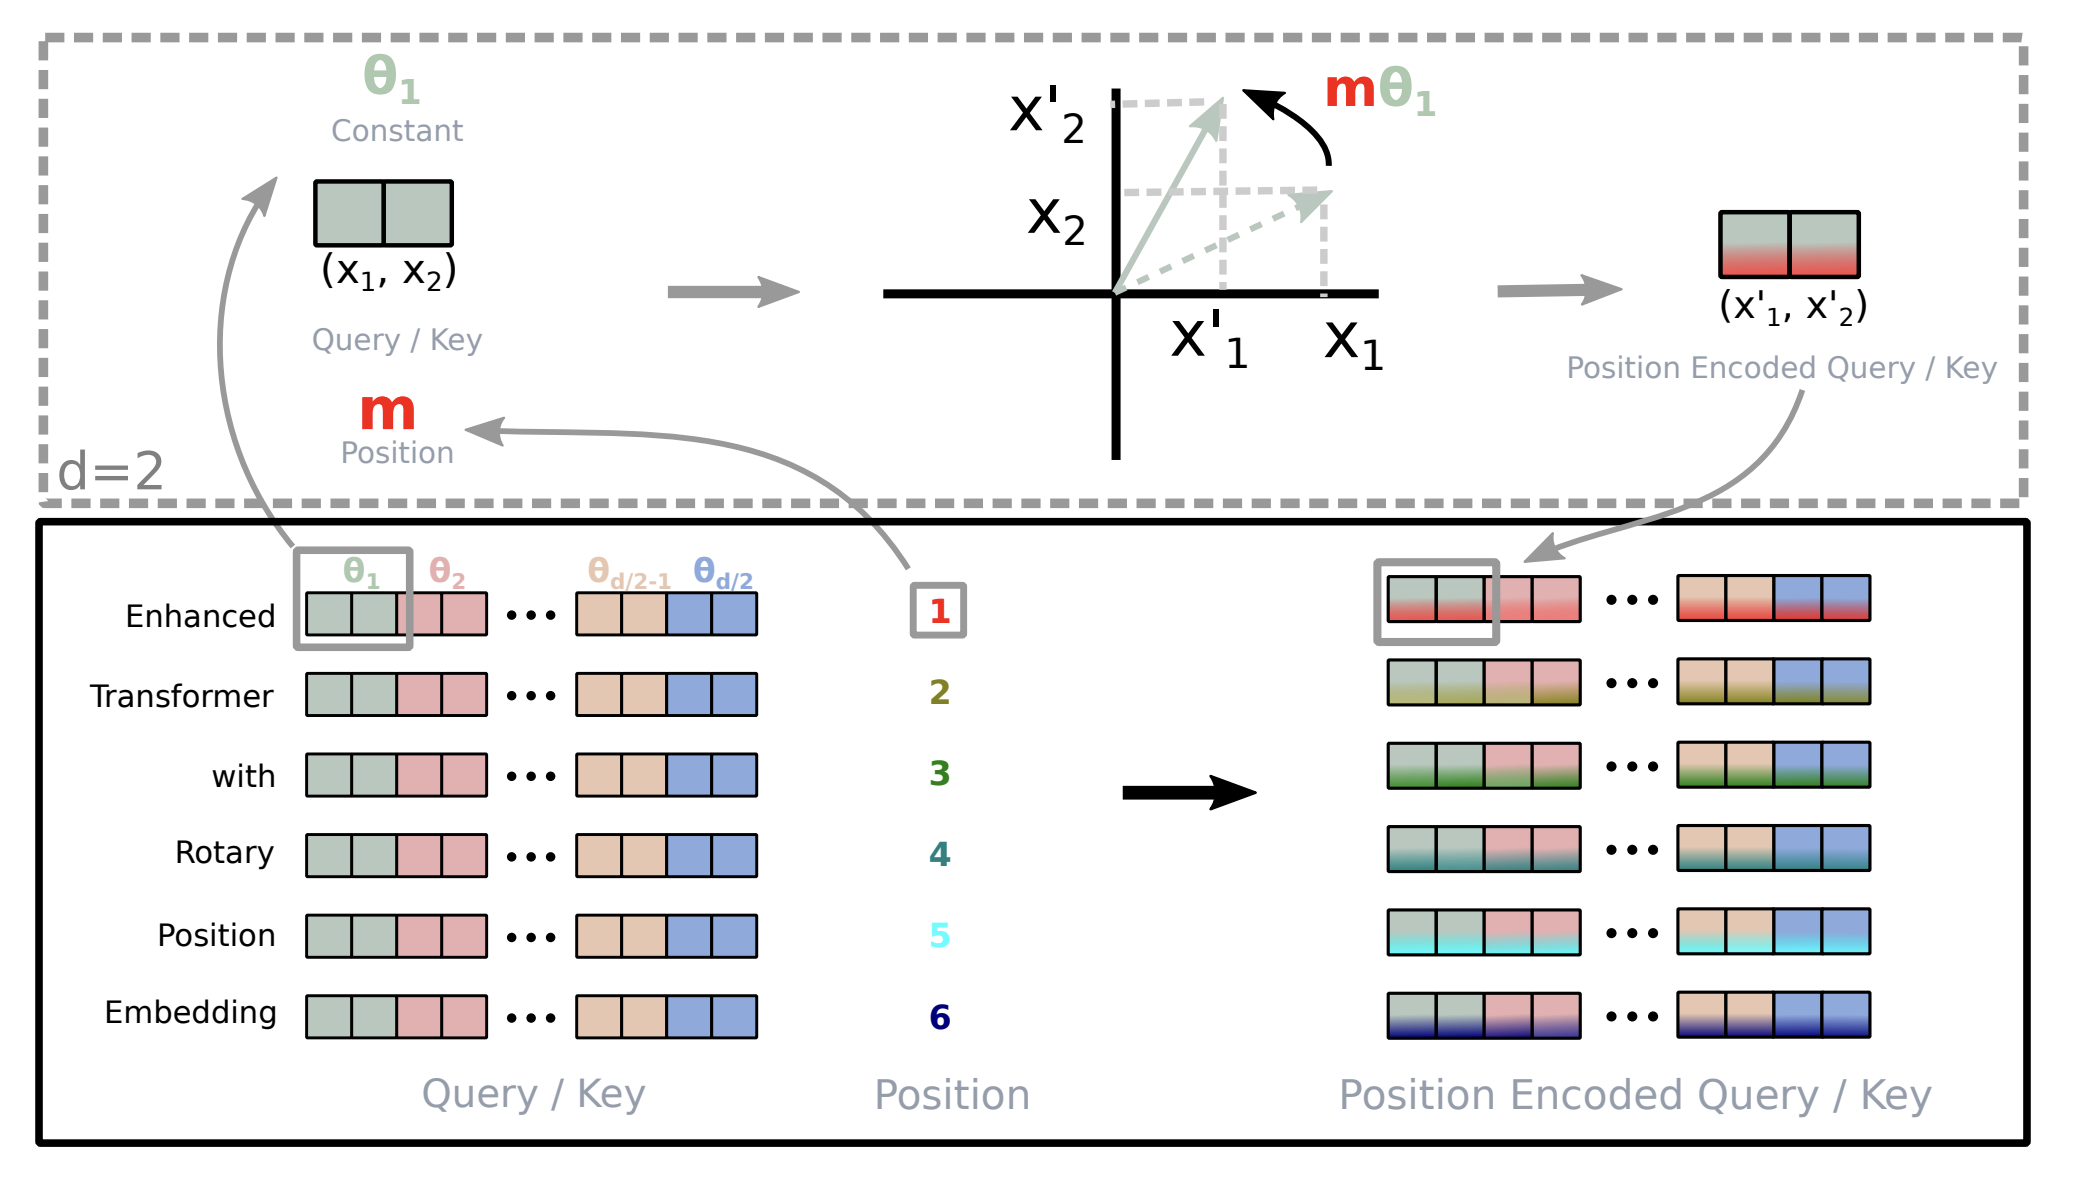
출처: RoFormer: Enhanced Transformer with Rotary Position Embedding (Su et al., 2021)
콘텍스트 길이가 길어지면서 새로운 연구 주제가 파생됐는데요. 대표적으로 Needle in a Haystack 문제가 있습니다. 우리나라 속담에 ‘모래밭에서 바늘 찾기’와 유사한 의미를 갖고 있는데요. 긴 문맥(Haystack) 속에서 특정한 답(Needle)을 찾아내는 문제입니다. 직관적으로 떠올려 보더라도 문맥의 길이가 길어질수록 지엽적인 답을 찾아내는 것은 어려워 보입니다. 이를 위해서 짧은 답을 잘 참조할 수 있도록 학습 데이터를 구축하는 것이 관건입니다.
또한 Needle in a Haystack 문제는 Lost-in-the-Middle 문제와도 연관이 깊습니다. 이는 언어 모델의 프롬프트 길이가 길어질 때, 프롬프트의 초반과 끝부분의 정보는 잘 찾지만 반대로 긴 문맥의 중간에 주어진 정보는 잘 탐색하지 못하는 것을 의미합니다. 두 문제를 모두 고려해본다면, 언어 모델의 다음 과제는 긴 문맥 속에서 작은 정보를 잘 탐색해내는 것이겠네요.
새로운 문제점이 지적되기도 하지만, 또다른 가능성이 제안되기도 합니다. 적은 양의 예제를 제공함으로써 모델이 해야 할 일을 콘텍스트 내에서 학습하도록 하는 방법론을 In-Context Learning이라고 합니다. 이는 파인튜닝 방법론의 대안으로 꼽히며, 많은 연구들이 발표됐는데요. 콘텍스트 길이가 길어진 덕분에 이제는 수 천 개의 예제를 입력할 수 있어, 과거에 비해 성능이 크게 개선됐습니다. 이를 Many-Shot In-Context Learning이라고 부르며 실제로 예제에 따라 얼마나 성능 차이가 나는지, 어떤 데이터셋에서 많은 예제가 강점을 갖는지 다양한 연구가 진행되고 있습니다.
AI 트렌드 2. Transformer를 대체할 모델: Mamba
현대 언어 모델에서 Transformer는 빼놓을 수 없습니다. 그 구조의 안정성과 성능은 이미 많은 연구에서 증명됐는데요. 최근 Transformer의 비효율성이 문제로 지적되며 그 자리를 위협 받고 있습니다. Transformer의 가장 대표적인 문제는 콘텍스트의 길이가 길어지면서 제곱수로 늘어나는 연산량입니다. 과거에는 제한된 콘텍스트 길이 내에서 학습했으나, 최근에는 그 한도가 거의 사라지면서 새로운 대안이 필요하게 된 것입니다.
그리고 지난해 12월, 카네기 멜론 대학의 Albert Gu와 Tri Dao는 Mamba라는 새로운 언어 모델 아키텍처가 제안했습니다. Mamba의 큰 특징 중 하나는 RNN 구조와 유사하다는 것입니다. RNN은 시퀀스가 길어질수록 성능이 떨어진다는 단점이 있었는데요. 이를 이전 토큰 내에서 중요한 부분을 잘 참조할 수 있는 Selective SSM 구조를 도입하면서 그 문제를 극복했습니다.
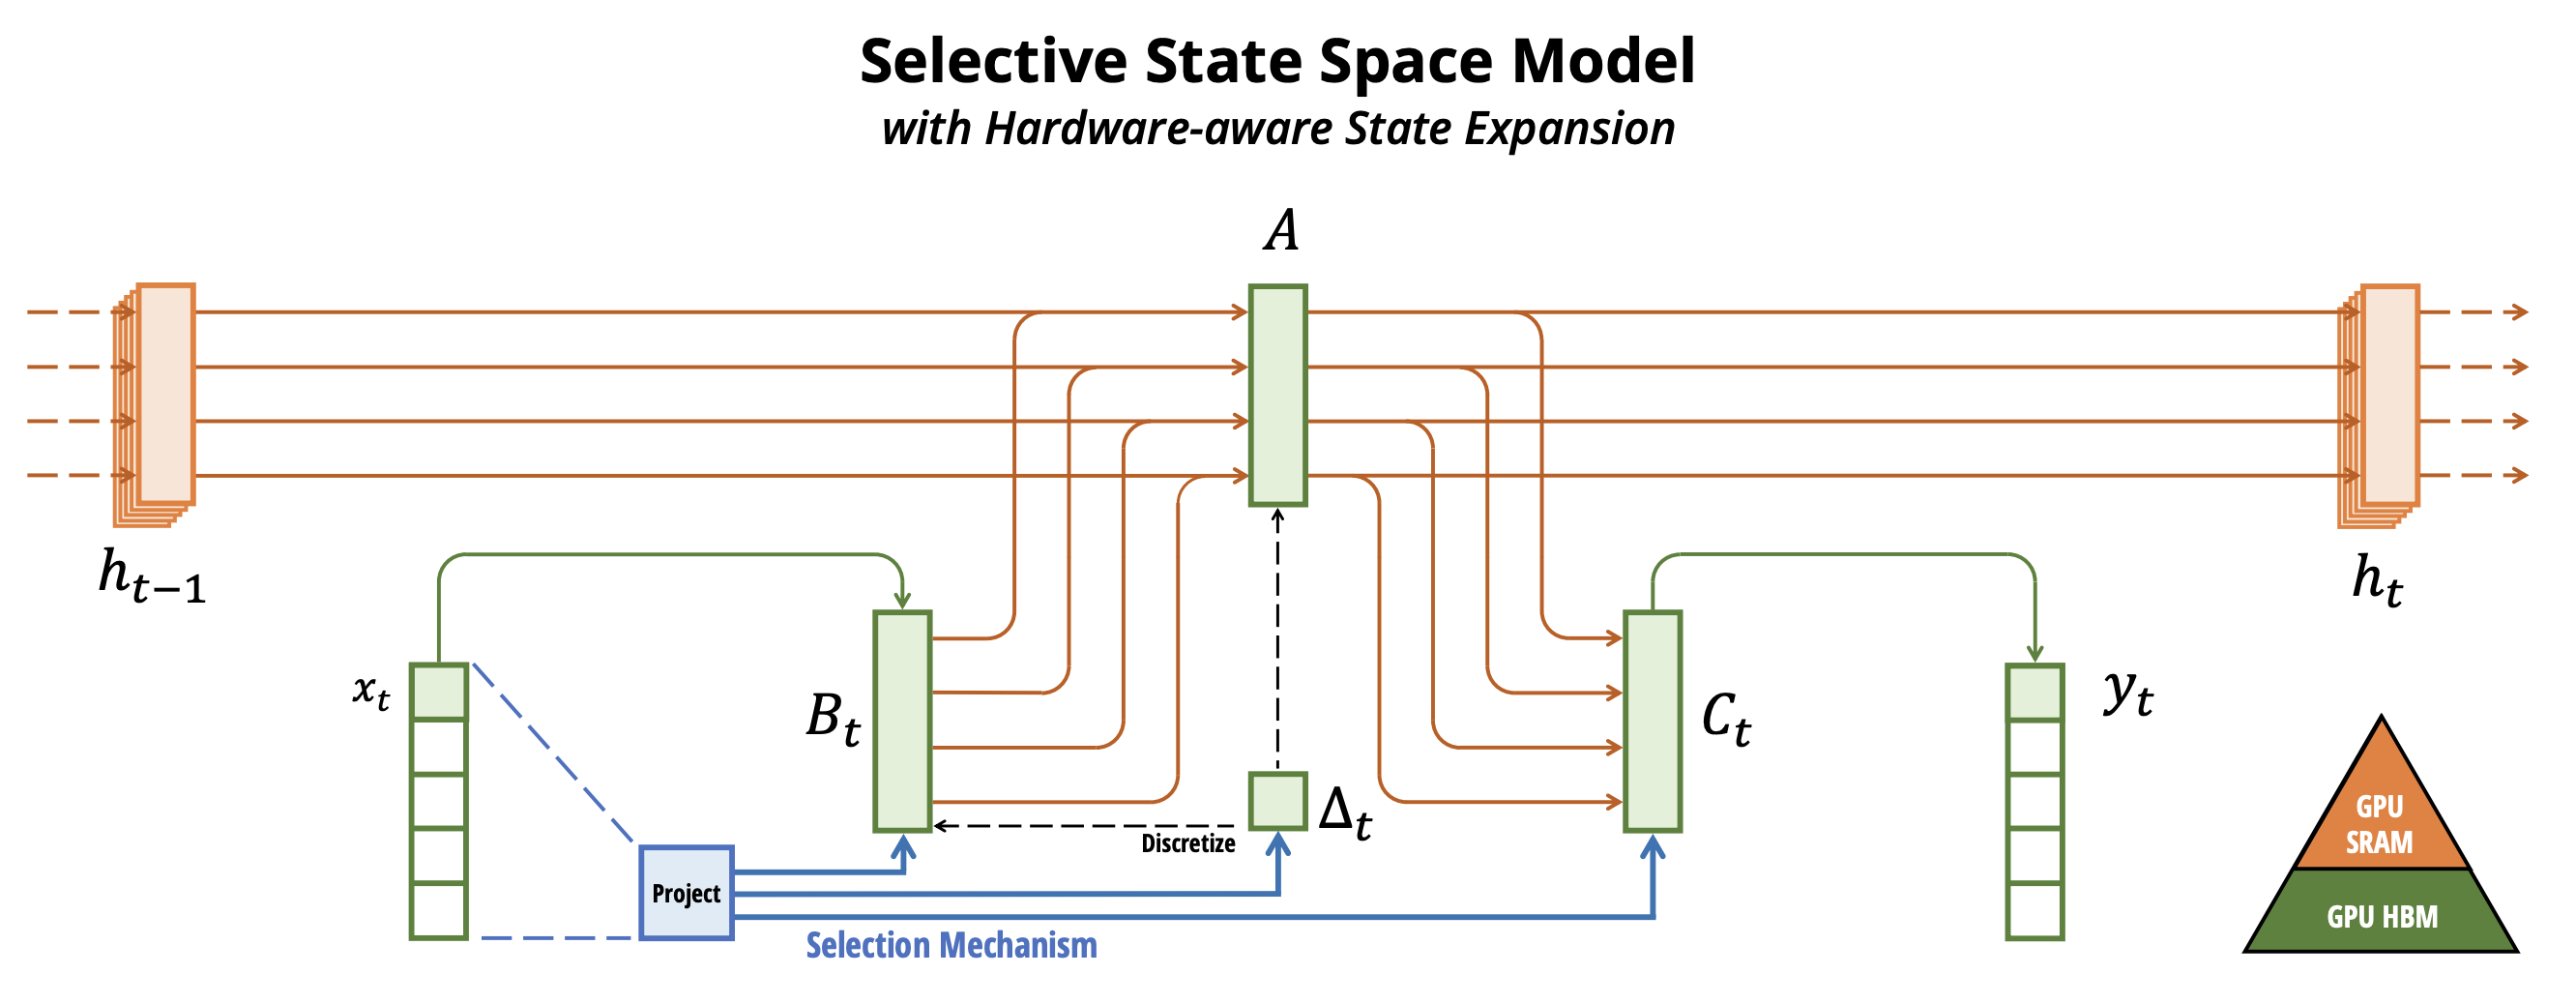
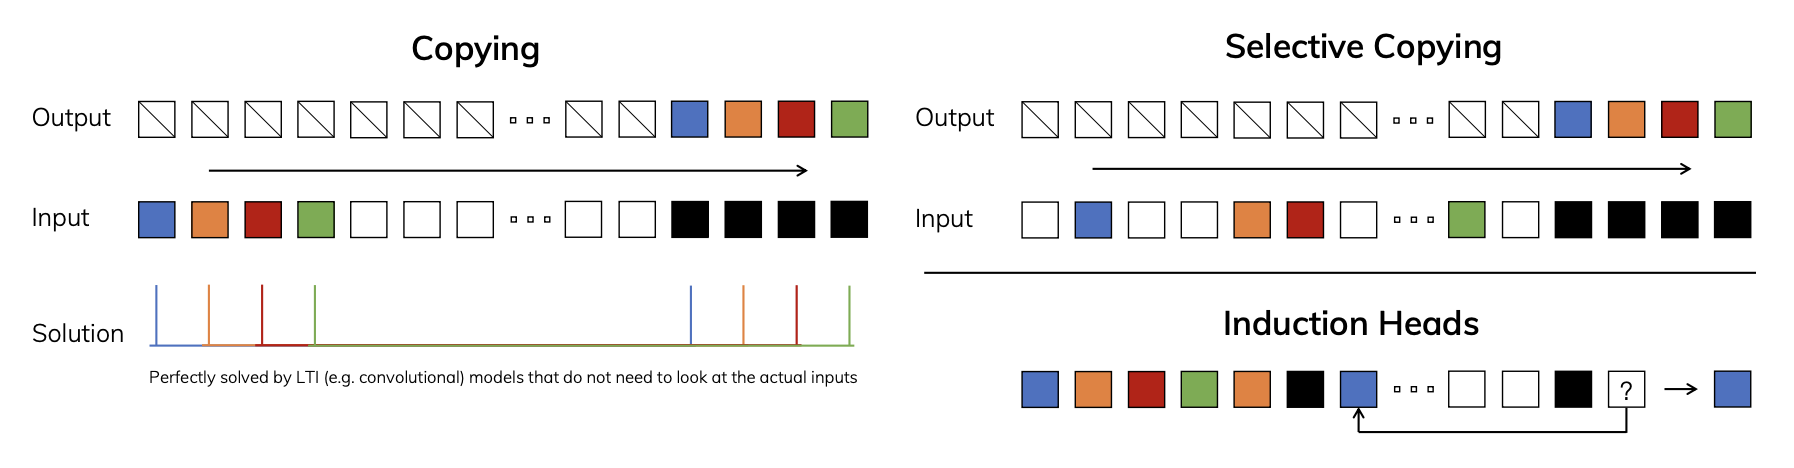
Mamba는 Transformer보다 더 빠른 속도에 준수한 정확도를 보인다며 연구자들 사이에서 크게 화제가 됐는데요. 올해는 그 가능성을 인정 받아 다방면으로 연구되고 있습니다. 기본적으로 언어 모델에서 어떻게 Mamba를 더욱 효율적으로 활용할 수 있을지 연구하는 동시에 Transformer와 Mamba를 결합하여 각각의 장점을 활용하고자 하기도 했습니다.
AI 트렌드 3. 모델 효율화 및 경량화
올해 초 삼성전자의 갤럭시 S24는 세계 최초 AI 폰으로 소개되며 국제적으로 이목을 끌었습니다. 이를 필두로 Microsoft에서는 Copilot이 기본적으로 탑재된 AI 랩탑을 선보였고, Apple에서는 Apple Intelligence를 소개했습니다. AI 모델은 많은 컴퓨팅을 필요로 하는 만큼 이를 처리할 수 있는 하드웨어도 중요한데요. NVIDIA를 비롯한 많은 기업들이 AI에 적합한 반도체를 개발하고 있는 한편으로, 모델 자체를 경량화하고 효율적으로 활용하고자 하는 연구도 이어지고 있습니다.
특히 모바일 환경과 같이 제한된 상황에서도 연산이 가능하도록 언어 모델을 경량화하는 방법론이 많이 제안됐는데요. 핵심은 모델을 양자화(Quantization)하는 데 있습니다. 양자화란 쉽게 표현하면 모델의 파라미터를 더 적은 비트(Bit)로 표현하는 것을 의미합니다. 비트가 많을수록 더 많은 소숫점 자리를 나타낼 수 있어, 정확한 연산이 가능합니다. 반대로 비트가 적다는 것은 그만큼 세밀한 표현은 어렵다는 것이죠. 대신 연산량 또한 급격하게 줄일 수 있습니다.
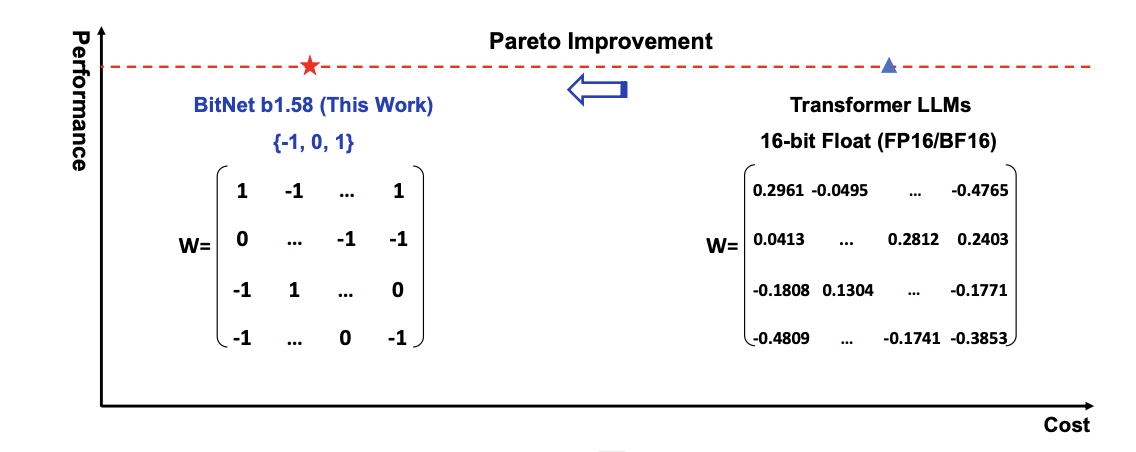
하지만 최근 연구에서는 8비트, 4비트를 넘어서 1비트 수준만으로도 언어 모델을 경량화하는 방법이 제안됐습니다. 1비트라면 0과 1밖에 표현할 수 없어 굉장히 제약적인데요. 대신 1.58비트로 표현가능한 값(-1, 0, 1)을 하나 늘리면서 성능을 크게 개선했다는 것입니다.
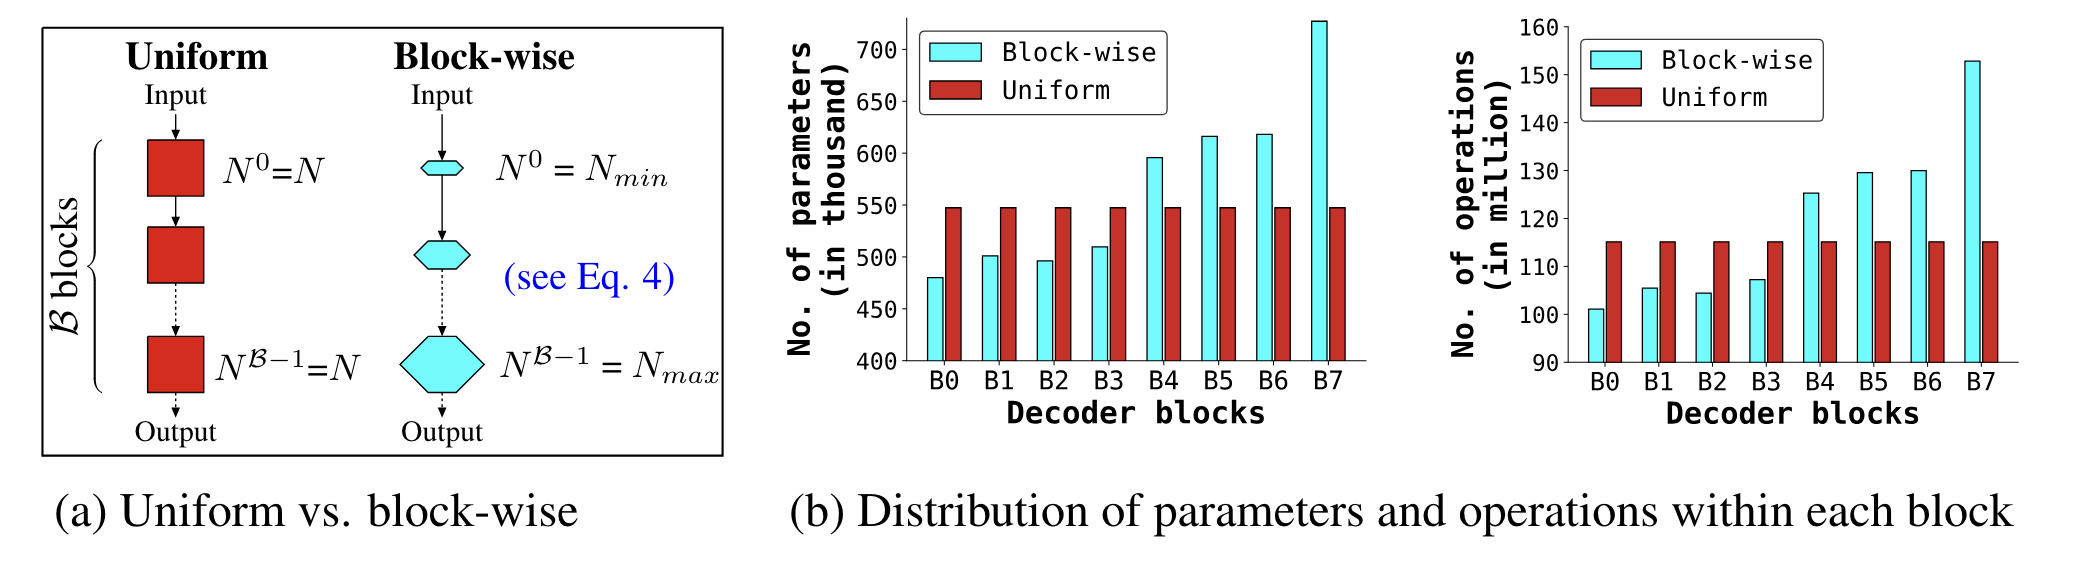
연산량을 줄이기 위해 양자화가 아닌 모델 구조를 변경하기도 합니다. Apple은 모바일 환경에서도 작동하는 AI 모델을 연구하며 Block-wise Scaling을 제안했는데요. 일반적으로는 Transformer의 크기를 고정시키지만 이를 작은 크기에서 시작해 점차 블록의 크기를 키우더라도 성능은 크게 저하되지 않으면서 연산량은 줄일 수 있다는 연구입니다.
한편, Microsoft는 모델 사이즈별로 최적의 데이터 양과 품질을 선택하는 방법으로 접근했습니다. 작은 모델에서도 고품질 데이터로 학습할 경우 좋은 성능을 보인다는 기존 연구를 계속 이어오고 있는데요. 올해는 Data Optimal Regime을 제안하며 더욱 작은 모델에 적합한 데이터를 찾는 데 집중하고 있습니다.
이렇게 3가지의 AI 연구 트렌드를 소개했습니다. 이밖에도 더 많은 AI 모델들과 서비스와 관련해 아래 링크에 정리했습니다. 저희 에디터 채니, 뱅뱅과 함께 딥 다이브 에디터가 여러분들을 위해 준비한 만큼 많은 도움되길 바라겠습니다.