
📔 Cover Story
프롬프트 엔지니어링 잘하는 법: Chain of Thought
최근에 서점에 가보신 적이 있나요? 요즘 서점에는 ChatGPT와 관련된 책들이 가장 잘 보이는 위치에 놓여 있습니다. 책들을 살펴보면 주로 ChatGPT를 어떻게 질문해야 하는지 설명하고 있습니다. 이제는 누가 AI를 더 잘 만드냐보다도, 누가 더 잘 활용하느냐가 중요해지고 있습니다.
그 기술 중 하나가 ‘프롬프트 엔지니어링’입니다. 프롬프트(Prompt)란, 쉽게 말해서 기계에게 내리는 명령어입니다. 즉, 프롬프트 엔지니어링은 챗봇에게 어떻게 질문해야 우리가 원하는 결과를 얻을 수 있을지 연구하고 설계하는 과정이라고 볼 수 있습니다.
뉴스를 보신 분들이라면 프롬프트 엔지니어라는 새로운 직업이 뜨고 있다는 말을 들어보셨을 수도 있는데요. 신조어가 아닌가 싶지만, 사실 연구자들은 이미 대규모 언어 모델(LLM)을 연구하는 과정에서 언어 추론 능력을 극대화할 수 있는 방법을 탐색해왔습니다. 그리고 가장 널리 알려진 방법 중에 하나가 바로 ‘Chain of Thought(연쇄 사고)’입니다. 이번주 뉴스레터에서는 이 Chain of Thought 논문과 함께 특징을 알아보도록 하겠습니다.
Chain of Thought이란 무엇일까?
Chain of Thought은 Google Brain 팀에서 2022년 1월 공개한 연구입니다. (여기에서 Google AI Blog 원문을 살펴보실 수 있습니다.) 당시에는 GPT-3 방식에서 활용한 프롬프팅이 가장 일반적이었는데요. 질문에 해당하는 예시, 즉 입력-출력 쌍(질문과 답변)을 같이 제공하여 추론하도록 요청하는 것입니다. 하지만 Chain of Thought 방식은 그 이름에서 알 수 있듯이 연쇄적인 사고과정을 제시합니다. 논문에서 제시한 예시를 통해 비교해보도록 하겠습니다.
기존 Few-shot 프롬프팅
Chain-of-Thought 프롬프팅
정말 사소한 차이인 것 같은데, 사고 과정을 제시해주니 훨씬 더 상세하고 정확하게 알려줍니다. 때문에 주로 논리적인 추론이 필요한 산술 추론, 상식 추론, 기호 추론 등에서 큰 효과를 보입니다. 이런 문제의 특징은 어떻게 그러한 결과가 도출되었는지 설명해주는 전개 과정이 중요하다는 것입니다.
연구진에 따르면, 사고 과정을 설명하는 것은 사전 훈련(Pre-trained) 중 획득한 지식을 활성화하고 추론에 필요한 관련 지식에 접근할 수 있는 가능성을 높입니다. 즉, 추론에 필요한 정보가 더 주어지기 때문에 사전 훈련 중 관련된 부분을 참고할 수 있는 폭이 넓어진다는 것입니다.
Chain of Thought의 특징을 알아보자
연구진이 제시한 Chain of Thought의 장점을 살펴봅시다.
- Chain of Thought을 통해 문제를 세분화된 중간 단계로 분해할 수 있습니다. 우리가 원하는 만큼 추론 과정을 더 상세하게 기술할수록, 더 정교한 추론 과정을 출력할 것입니다.
- 모델의 결과가 어떻게 추론되는지 해석이 가능합니다. 만약 올바르지 않은 추론 결과를 냈다면, 어느 단계에서 잘못된 추론을 했는지 살펴볼 수 있습니다.
- 언어를 통해 할 수 있는 모든 추론(수학, 상식 추론 등) 작업에 확대 적용이 가능합니다.
- 이미 만들어진 언어 모델에 새로운 학습 과정 없이도, 프롬프트에 Chain of Thought을 추가하는 것만으로 성능을 향상시킬 수 있습니다.
그렇다면 얼마나 성능이 개선될까요? 산술 추론(Arithmetic Reasoning) 데이터셋(GSM8K)에 대해서 가장 큰 PaLM 모델에 Chain of Thought 프롬프팅 방법을 적용하여 무려 17.9%에서 58.6%까지 성능을 끌어올렸습니다. GPT-3에서도 15.6%에서 49.6%로 약 3배 가까이 개선되었습니다. 산술 추론 데이터는 다른 종류의 문제에 비해 조금 더 복잡한 구조를 가지고 있어 더욱 효과적으로 나타난 것입니다. 한편, 단순한 사고 단계만으로도 추론이 가능한 경우에는 성능 개선 효과가 크지 않았습니다.
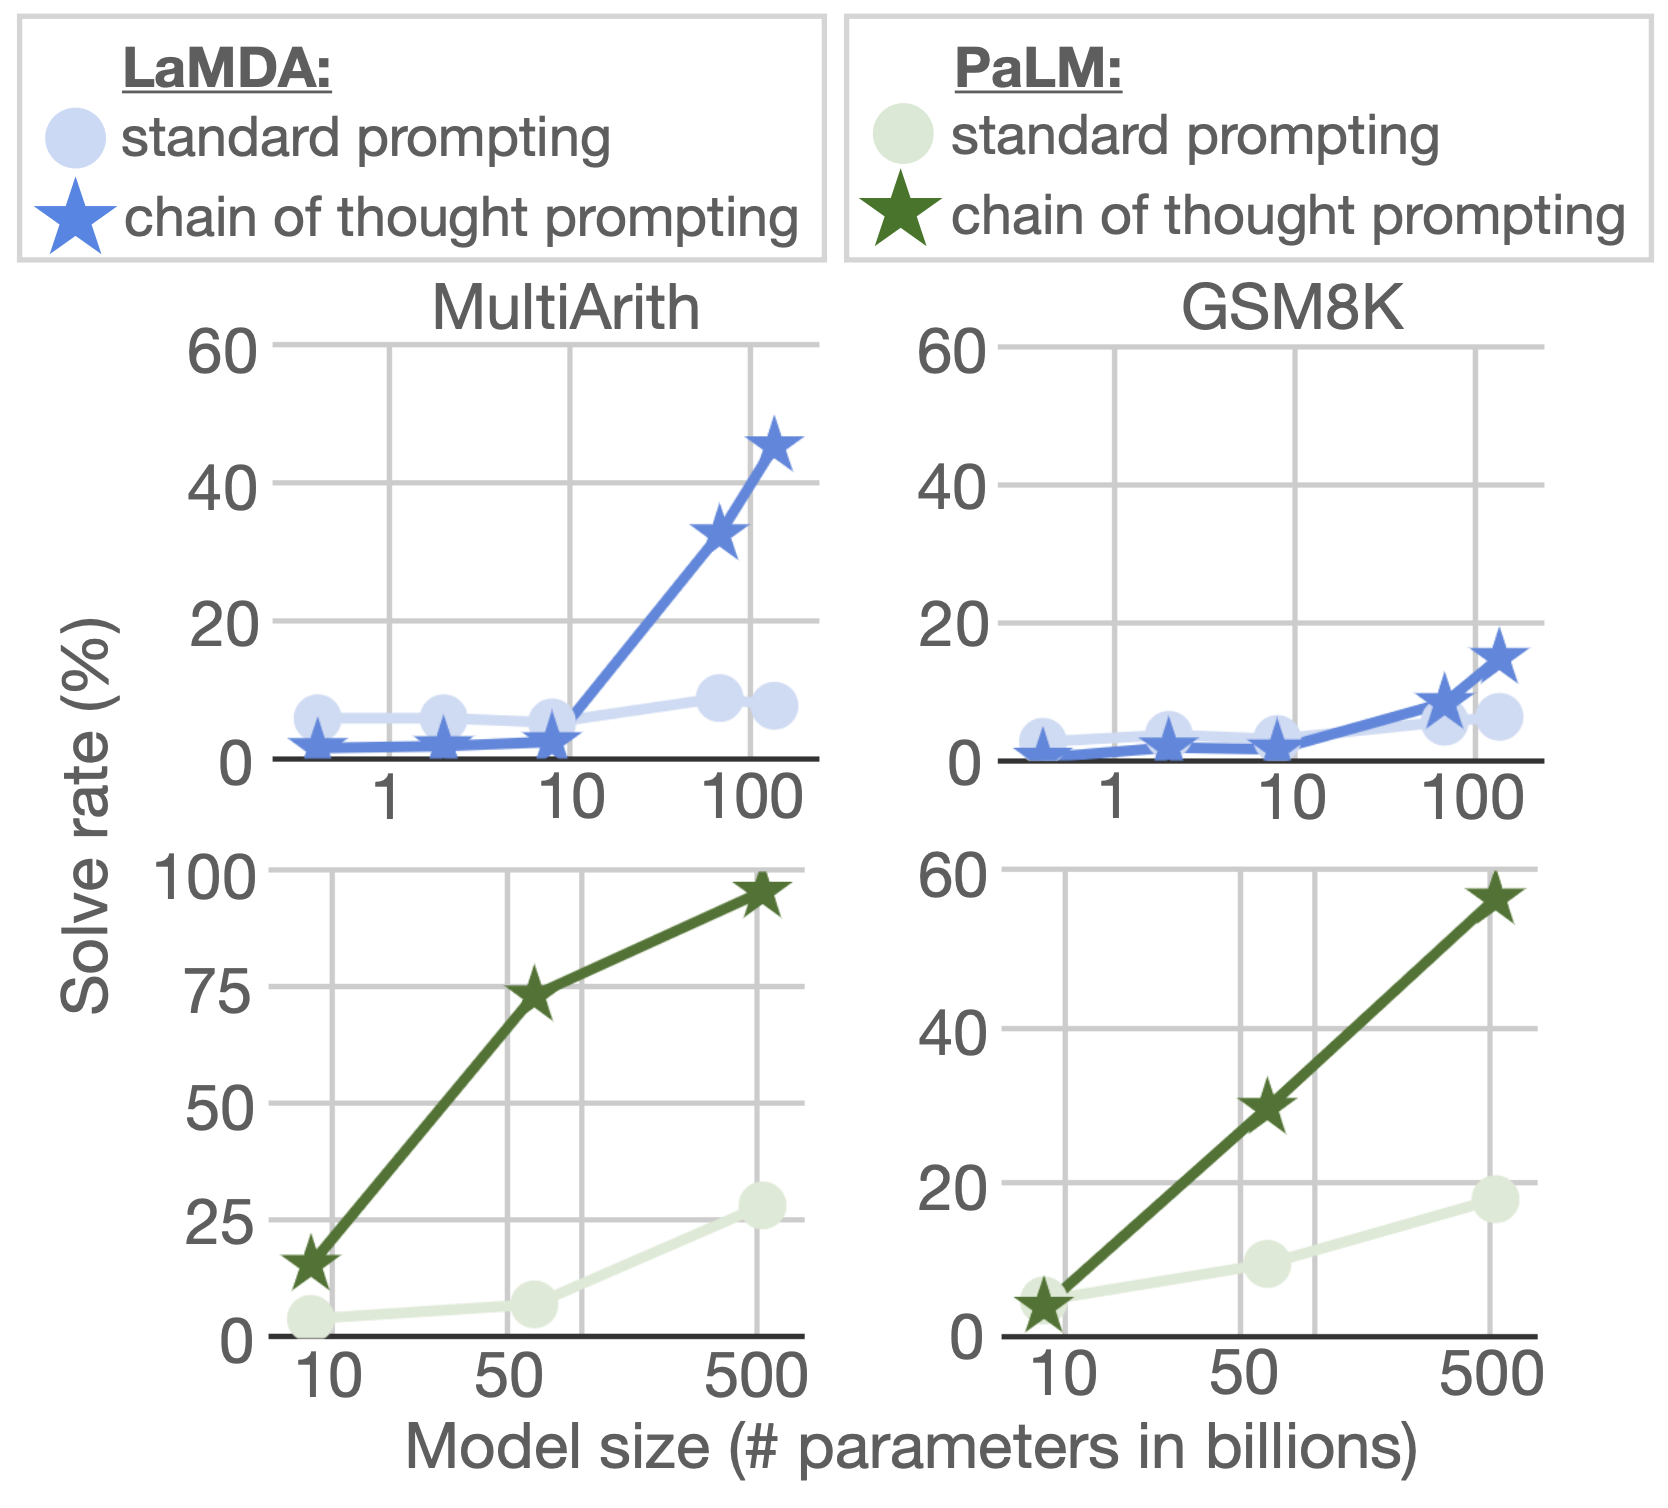
흥미로운 것은 Chain of Thought 프롬프팅 방식을 적용한 것이 GPT-3의 미세 조정 학습(Fine-tuning)보다 좋은 성능을 보였다는 것입니다. 시간과 비용을 들여 추가적인 학습을 진행하는 것보다, 질문을 더욱 정교하게 하는 것이 효과적일 수 있다는 것을 의미합니다.
하지만 정말로 언어 모델이 ‘추론’을 하는지에 대해서는 여전히 알 수 없습니다. 단순히 형식을 베끼고 앞서 말한 것처럼 정보에 더 많이 접근해서 결과가 더 잘나오는 것일 수도 있고요.
안타깝게도 아직 규모가 작은 언어 모델에서는 결과가 잘 나오지 않는다는 한계도 존재합니다. 연구진은 62B와 540B의 PaLM 모델을 기반으로 성능을 평가했는데요. 62B 모델이 틀리던 문제를 540B 모델은 맞히는 것을 발견했습니다. 그리고 이에 대해서 540B의 언어 모델이 언어를 더 잘 이해하기 때문에 프롬프트 엔지니어링의 효과가 잘 나타난 것으로 본다고 말했습니다.
나도 프롬프트를 만들 수 있을까?
지금까지 Chain of Thought의 특징에 대해 알아보았는데요. 그러면 정말 누구든 Chain of Thought 방식으로 프롬프트를 만들어도 효과가 있을까요? 연구자들이나 전문가들만할 수 있는 것은 아닐까요?
다행히도 Chain of Thought 프롬프트 방식은 작성자에 민감하지 않습니다. 연구진들은 작성자들에게 별다른 가이드를 제시하지 않은 뒤 프롬프트를 작성해보라고 해보았는데요. 그중에는 머신러닝에 대해 잘 모르는 사용자들도 있었습니다. 그러나 작성자 특성에 상관 없이 모두에게서 성능 개선의 효과가 나타났다고 밝혔습니다.
이는 여러분들도 직접 프롬프트를 만들 수 있다는 의미입니다. 이런 특성 덕분에 프롬프트를 거래하는 시장이 형성되기도 했습니다.
개인적으로 Chain of Thought 방식이 시사하는 바가 크다고 생각합니다. 사실, 사람과 대화를 할 때도 상대방이 당연히 알 것이라고 가정하면 잘못된 대화가 오가기도 합니다. 똑같은 의미라도 ‘나는 이런 경험이 있고, 그래서 이렇게 생각한다.’처럼 친절한 문장 하나를 더 추가하면 상대방도 그 맥락을 쉽게 이해할 수 있고 더 좋은 대화가 오갈 수 있습니다. 본인의 생각도 더욱 정교화할 수 있고요. 정말 가는 말이 고우면, 오는 말도 곱다는 격언에 딱 맞아 떨어지지 않나 싶습니다.
🙌 deep daiv. 새로운 글
Humans of daiv. #4 김정국
분야를 막론하고 ‘잘 안다’라는 느낌이 들기란 쉽지 않습니다. 이 정도면 됐다 싶다가도, 내가 아는 세계가 전부가 아니라는 생각에 하염없이 겸손해지기도 합니다. ‘배움에는 끝이 없다’는 명제를 재확인할 수 있죠.
인공지능을 공부하는 사람이라면 한 번쯤 전문성에 대해 고민해 본 적이 있을 것입니다. 그리고 꽤나 많은 사람이 더 넓은 바다로 가기 위해 대학원이라는 관문을 거친다. deep daiv.에서 인공지능 공부를 시작해 데이터사이언스 대학원까지 진학한 김정국의 이야기를 소개합니다.