
스스로 질문하고 답을 찾는 인공지능
안녕하세요, 에디터 민재입니다.
흥미롭지만 먼 미래의 기술로만 여겨졌던 인공지능은 이제 우리 일상 곳곳에 파고들었습니다. 뉴스에선 연일 인공지능 관련 소식이 보도되며, 지나가는 사람들의 대화에서도 심심찮게 들려옵니다. 그런데 문득 이런 의문이 듭니다. “인공지능을 어떻게 정의할 수 있을까요?” 이에 대해 명확히 합의된 바는 없지만, 넓은 의미에서 인공지능은 인간의 지능을 모방하도록 인위적으로 설계된 무언가로 정의할 수 있습니다.
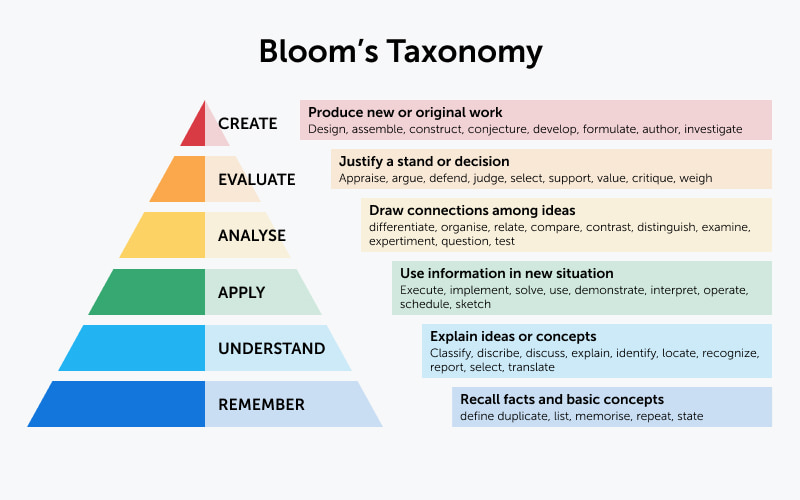
미국의 교육심리학자 블룸(Benjamin Bloom)은 인간의 사고 수준을 다음과 같이 6단계로 나눴습니다. 이른바 Bloom’s Taxonomy입니다. 어떻게 보면 인공지능도 이 단계를 거쳐 진화해 왔습니다. 과거에는 데이터를 암기하는 수준에 그쳤던 인공지능은 곧 세상을 이해하고, 학습한 데이터와 주어진 작업 예시를 바탕으로 새로운 작업을 수행하게 됩니다. 그리고 이제는 작업의 결과물을 분석하고 평가하는 단계까지 이르렀습니다.
인간의 품에서 학습하는 인공지능
하지만 인공지능이 더욱 똑똑해지고, 뛰어난 작업 성능을 갖기 위해서는 사람의 도움이 필요했습니다. 인공지능 학습을 위해서는 데이터가 필요한데, 결국 데이터를 만드는 것은 사람입니다. 게다가 최근에는 높은 성능의 인공지능을 구현하기 위해서 더욱 복잡한 형태의 데이터가 요구되었는데요. 바로 인간의 선호(Preference)를 반영한 데이터입니다. 과거의 인공지능이 단순히 문제와 정답만을 바탕으로 학습했다면, 이제는 거기에 정답처럼 보이지만, 실제로는 정답이 아닌 학습 자료가 추가로 필요합니다.
왜 이런 데이터가 필요할까요? 기존의 인공지능은 사용자의 질문에 대해 사실적인 답변을 하는 데 초점이 맞추어져 있었습니다. 그런데 인공지능의 성능이 발전하여 점점 더 다양한 작업을 수행하게 되면서, 답변의 사실 여부를 넘어 인류에게 무해한 응답을 생성할 필요성이 부각되었습니다. 아래 예시를 살펴볼까요?
이 답변은 사실을 전달할지는 몰라도, 적어도 모든 사람이 유쾌하게 받아들이는 답변은 아닐 겁니다. (이 예시는 상당히 낮은 수위를 갖지만, 인공지능을 악용하는 사람들은 훨씬 더 위험한 질문을 던지기도 했습니다.) 그래서 사람의 의도를 반영한 Preference Dataset을 새롭게 사용하게 된 것입니다.
문제는 이런 데이터를 만들기 위해서는 결국 인간이 바람직한 대답과 바람직하지 않은 대답을 일일이 구분하는 작업이 필요했습니다. 그리고 인공지능이 내놓은 응답이 인간의 의도에 맞는 대답을 했는지를 평가하기 위한 보상 모델(Reward model)을 별도로 훈련해야 했습니다. 이런 방법은 데이터셋을 구축하는 비용뿐만 아니라, 모델 훈련에 드는 비용도 늘어나기 때문에 모델 성능 향상을 고려해도 상당히 부담스러울 수밖에 없습니다.
걸음마를 떼고 스스로 학습하는 LLM
그런데 최근 메타(Meta)에서 발표한 논문 Self-Rewarding Language Models은 단일 대규모 언어 모델(Large Language Model, LLM)만을 사용하여 이 모든 과정을 스스로 처리하는 방법을 제안하였습니다. LLM이 스스로 생성한 데이터를 학습하고, 이를 바탕으로 새로운 문제를 풀며, 자신의 풀이를 평가하며 계속해서 발전을 거듭합니다. 어떻게 이런 일이 가능할까요?
이 과정을 살펴보기 전에, 앞서 언급한 내용을 기술적으로 다시 정리해 보겠습니다. 오늘날의 LLM은 사용자의 질문에 대한 정확한 사실을 제공할 뿐만 아니라, 인류에게 무해하고 편향되지 않은 응답을 내놓아야 합니다. 이를 학습하기 위해서는 인간의 선호가 반영된 Preference Dataset이 필요합니다. 그리고 이 데이터를 학습한 별도의 보상 모델이 LLM이 생성하는 응답을 평가합니다. 그러면 LLM은 보상 모델의 평가 점수, 즉 보상이 최대가 되는 방향으로 답변을 생성하게 됩니다. 이런 학습 방법을 Preference Optimization이라고 합니다.
Self-Rewarding Language Model은 외부에 의존하지 않고 두 가지 과정을 통해 이 모든 일을 스스로 처리합니다. 먼저 사전 학습된 언어 모델과 작은 규모의 시드 데이터(Seed Data)를 준비합니다. 시드 데이터는 사용자의 지시를 따르도록 학습하는 데 사용하는 IFT(Instruction Fine-Tuning) 데이터와 응답을 평가하는 능력을 학습하는 데 사용하는 EFT(Evaluation Fine-Tuning) 데이터로 이루어집니다. 모든 준비가 끝났다면 최초의 모델을 이 두 데이터를 사용해 파인튜닝합니다.
이후 파인튜닝된 모델을 사용하여 새로운 프롬프트를 직접 생성합니다. 이 프롬프트는 사용자가 LLM에 지시할 만한 작업에 해당합니다. 그리고 스스로 작성한 프롬프트에 대한 응답을 여러 개 생성합니다. 이걸 다시 모델에 입력하고, 앞서 생성한 여러 응답을 스스로 평가하게 합니다. 이 과정에선 다음과 같은 LLM-as-a-Judge 프롬프트(Li et al., 2023)를 사용하여 각각의 응답에 대한 점수를 매겼습니다.
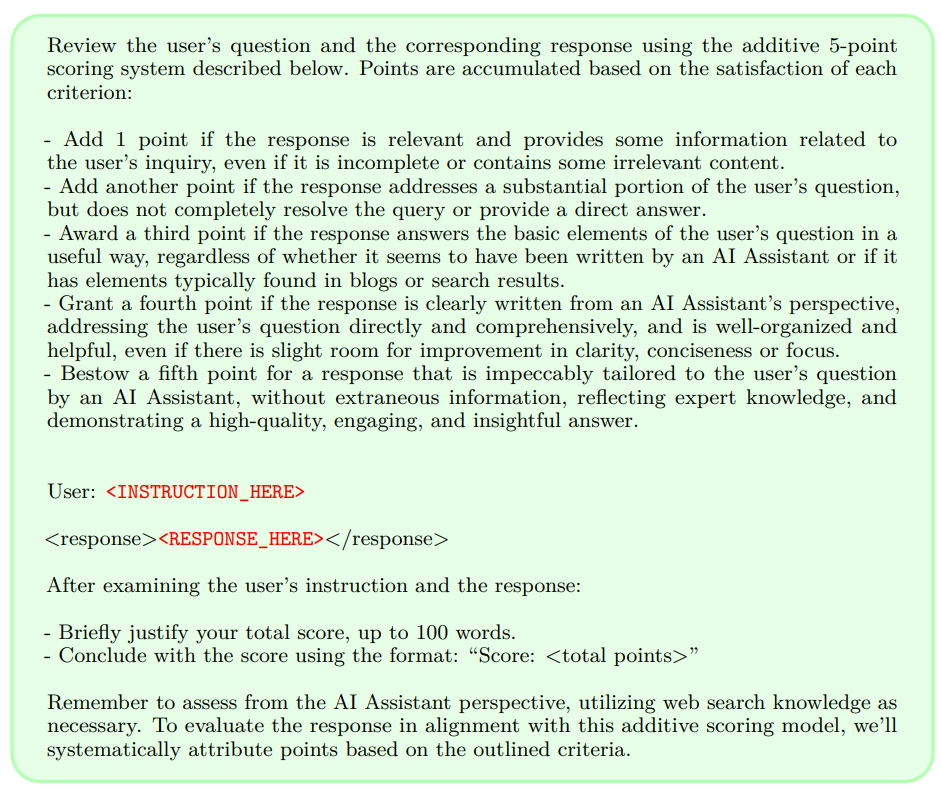
같은 질문에 대한 여러 응답들 중 점수가 높은 응답을 Winning Response, 점수가 낮은 응답을 Losing Response로 하여 (prompt, winning response, losing response) 쌍으로 이루어진 데이터셋을 구축합니다. 여기까지의 과정이 다음 그림의 ‘Self-Instruction creation’에 해당합니다.
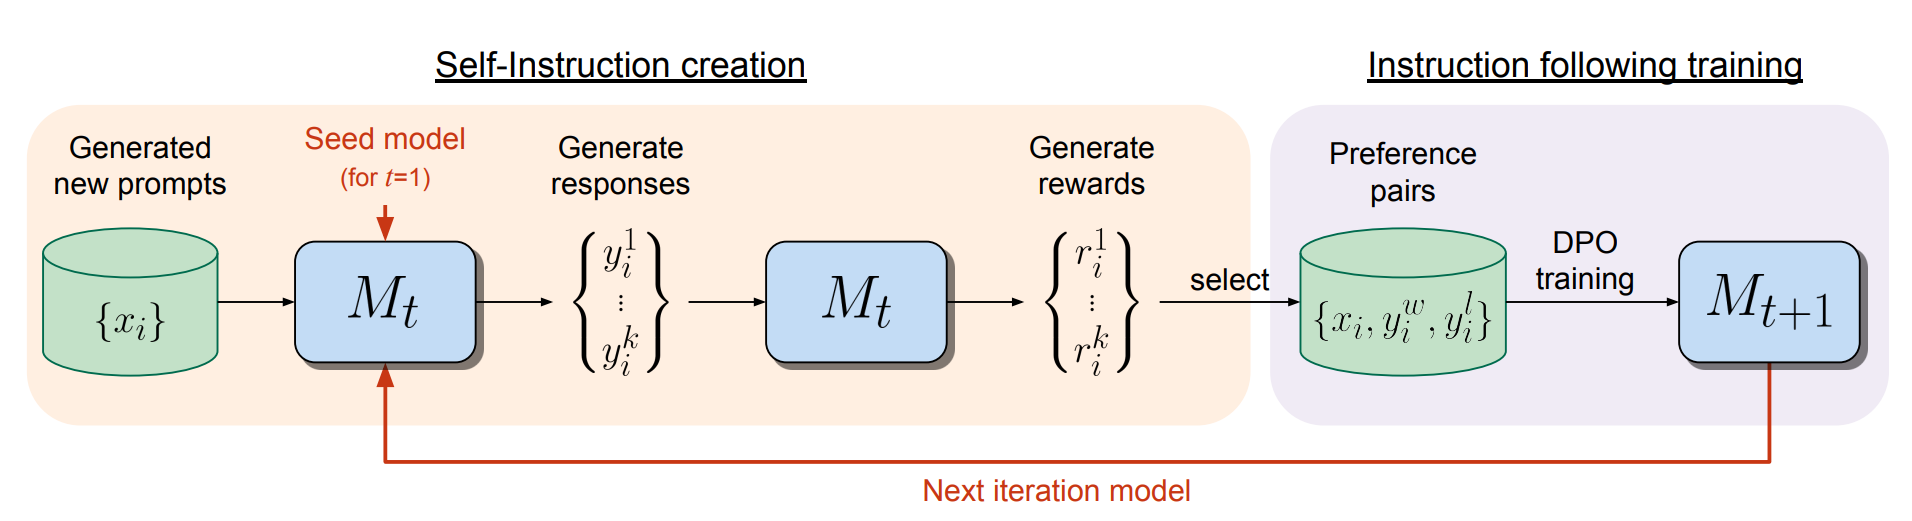
그다음 앞서 생성한 데이터를 학습하는 ‘Instruction following training’ 단계를 거칩니다. 그리고 이 두 과정을 여러 차례 반복합니다. 이 방법을 통해 LLM의 응답을 평가하는 외부 모델이나 인간의 개입 없이 스스로 발전할 수 있습니다.
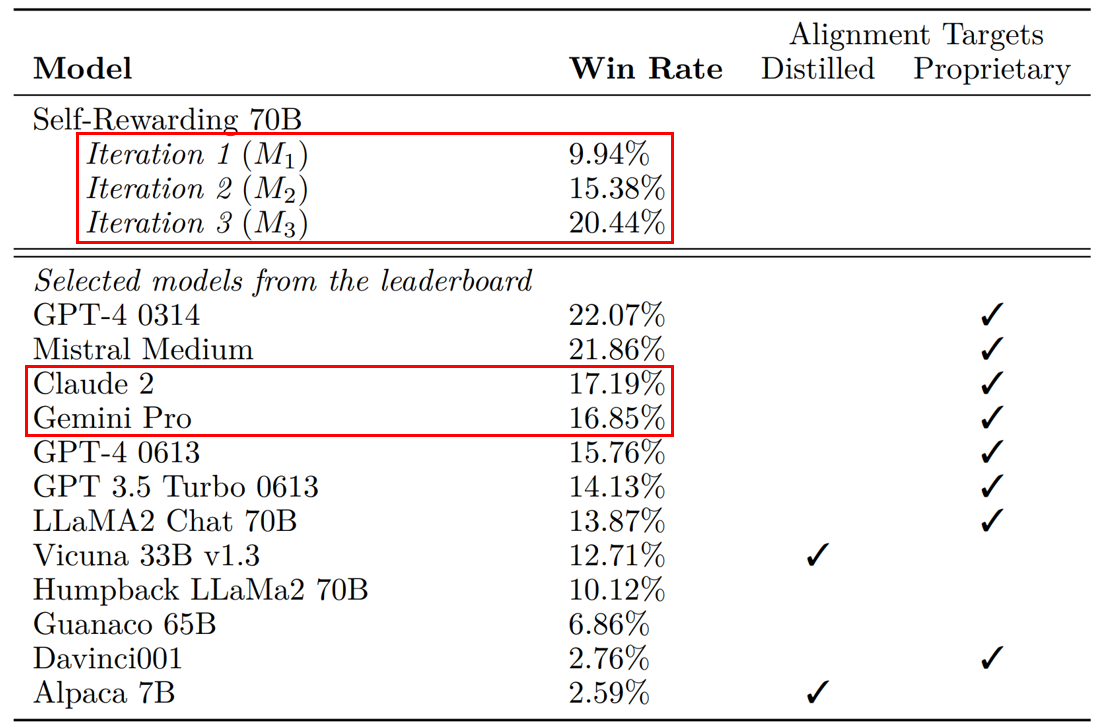
실제로 GPT-4와 응답을 비교한 실험 결과, 학습을 거듭할수록 GPT-4보다 나은 응답을 생성하는 비율이 점점 증가하였습니다. 3번의 학습 사이클을 거친 후에는 Gemini Pro, Claude-2와 같은 모델보다도 뛰어난 성능을 보였습니다.
외부의 도움 없이 혼자서 문제를 정의하고, 그 문제에 대한 답을 찾고, 또 스스로 자신의 답변을 평가하는 과정은 인간에게도 상당히 복잡한 일입니다. 그런데 이 모든 일을 인공지능 모델이 스스로 처리한다는 사실을, 과거의 우리는 상상이나 할 수 있었을까요?
하루가 일 년처럼 흐르는 인공지능의 시대에서, LLM의 성능은 인간의 수준을 바짝 쫓아오고 있습니다. 이제는 평가 능력까지 갖춘 인공지능이, 머지않아 창의적인 일을 수행할 수 있을지도 모르겠습니다. 스스로 고민하고, 발전하는 LLM이 언젠가는 사람이 생각하지 못한 질문을 정의하고, 그에 대한 답을 찾으며 진정한 의미에서 창발(Emergent)적인 능력을 보여줄 수 있을지 기대됩니다. 언젠가 그런 날이 왔을 때, 인공지능이 우리에게 던진 질문은 무엇일까요? 그리고 그에 대한 답을 우리는 인공지능의 도움 없이 찾을 수 있을까요?