
로봇이 펜을 돌릴 수 있다고?✍️
월-E와 자비스
영화 ‘Wall-E’의 주인공 Wall-E는 인간이 살지 않는 지구에 남아 폐기물을 처리하는 주인공이며, 영화 ‘아이언맨’에 등장하는 자비스(J.A.R.V.I.S)는 토니 스타크(아이언맨)의 명령을 충실히 수행하는 비서입니다. ‘Wall-E’와 ‘자비스’를 떠올리면 맡은 명령을 척척 수행하는 ‘로봇’이라는 키워드가 떠오를 수 있습니다. 하지만 자비스는 로봇이라기보다는 음성 인식 및 대화 기능을 통해 토니 스타크와 소통하고 작업을 수행하는 인공지능 비서에 가깝습니다. 월-E는 로봇 기계체로서, 월-E가 보유하고 있는 고급 의사 결정 능력은 지능과 학습 능력, 다양한 능력이 반영될 수 있도록 고급 인공지능 기술을 적용한 로봇입니다.
'Wall-E'는 기계체로, 지구의 환경을 정리하고 보존된 물건을 수집하는 역할을 수행합니다. 물리적 형태로 현실에서 이동하면서 작업을 수행하며, 주로 센서를 통해 받아들인 정보를 토대로 환경과 물체에 대한 물리적 상호작용에 중점을 두기 때문에 물리적 작업이 주요 기능 중 하나라고 볼 수 있습니다. 한편 자비스는 소프트웨어 기반의 음성 인식 인공지능 비서로, 물리적인 로봇 팔이나 다리 등의 몸체는 가지고 있지 않으며 음성 명령과 투영 화면을 통해 토니 스타크와 소통하며 서비스를 제공합니다. 즉 자비스는 그 물리적 형태와 물리적 행동 능력으로 인해 ‘로봇’이라고 정의하기 적절하지 않고 엄밀하게는 로봇을 학습시키는 과정 속에 ‘인공지능 기술’이 포함되는 것 입니다. 이처럼 로봇과 인공지능의 경계는 모호하게 느껴지지만 물리적인 몸체의 유무라는 차이는 제법 명확합니다.
그리고 다시 로봇과 인공지능의 차이를 결정짓는 ‘물리적인 몸체’의 자연스러움을 구현하는 방안이 강화학습이라는 점이 흥미롭습니다. 이 과정에서 자연어 피드백이 로봇의 보상 함수에최근 몇년동안 언어 모델이 발전하면서 로봇 작업에서 LLM은 Semantic Planner*로서 강화학습을 위한 프레임워크로 이용되고 있습니다. 이번주 뉴스레터에서는 <Eureka: Human-Level Reward Design via Coding Large Language Models> (논문 링크🔗)를 살펴보며 Semantic Planner로서의 인공지능의 역할에 대해서 소개하겠습니다. 오늘 살펴볼 몸체의 자연스러운 움직임을 구현하는 과정뿐만 아니라 로봇의 자율주행 시스템을 도입하는 과정에서도 센서 데이터 처리 및 해석 능력/ 기계 학습 및 강화학습/ 자율주행시스템 의사결정 부문에서 인공지능은 핵심적인 역할을 담당하고 있습니다🦾
EUREKA!
여러분은 펜 돌리기를 할 줄 아시나요?✒️ 펜을 잘 돌리는 친구에게 방법을 연마해달라는 요청을 하고, 유튜브 영상을 보고 연습하며 펜 돌리기 카페까지 전전하던 학창시절을 뒤로하고 저는 끝끝내 펜을 돌리지 못했습니다. 가볍고 기다란 펜은 항상 손가락에서 미끄러지기 일수였고 이론을 머리로는 알아도 제 손가락에는 너무 섬세한 작업처럼 느껴졌습니다. 그런데 최근 이 복잡한 펜돌리기를 로봇이 할 수 있도록 하는 프레임워크, 유레카가 공개되었습니다.
Eurka의 펜 회전 기술 (출처 : https://eureka-research.github.io/)
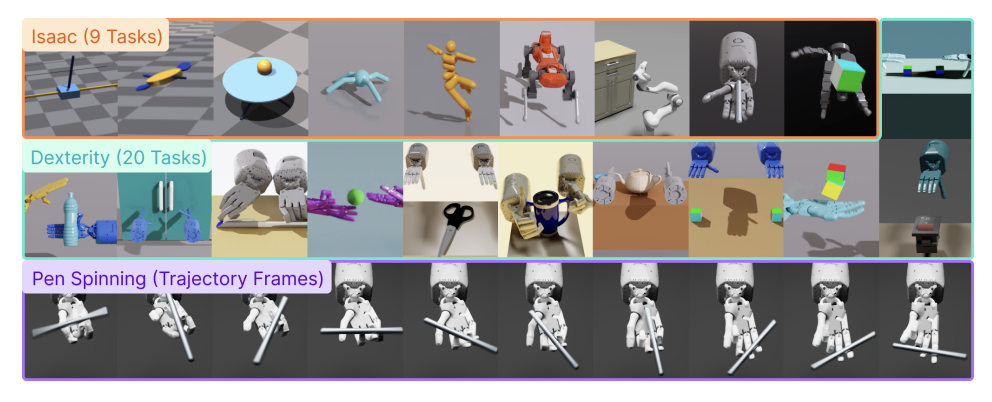
엔비디아, 펜실베니아대학교(UPenn), 캘리포니아공과대학교(Caltech), 텍사스대학교 오스틴(UT Austin) 등 다국적 연구원들이 오픈AI의 챗GPT-4 모델을 통한 강화학습 방식으로 로봇이 훨씬 더 빠르게 학습할 수 있게 개발한 알고리즘 유레카(Eureka)를 공개했습니다. 펜을 돌릴 수 있다는 문구로 홍보된 유레카는 기존의 로봇을 구동하는 알고리즘에서 무엇이 다를까요? 유레카 프레임워크에는 1. 환경 소스 코드(Environment Source Code)*를 context로 사용, 2. Evolutionary search 구현, 3. Reward reflection 이라는 총 세 가지 핵심 기술요소가 있습니다.
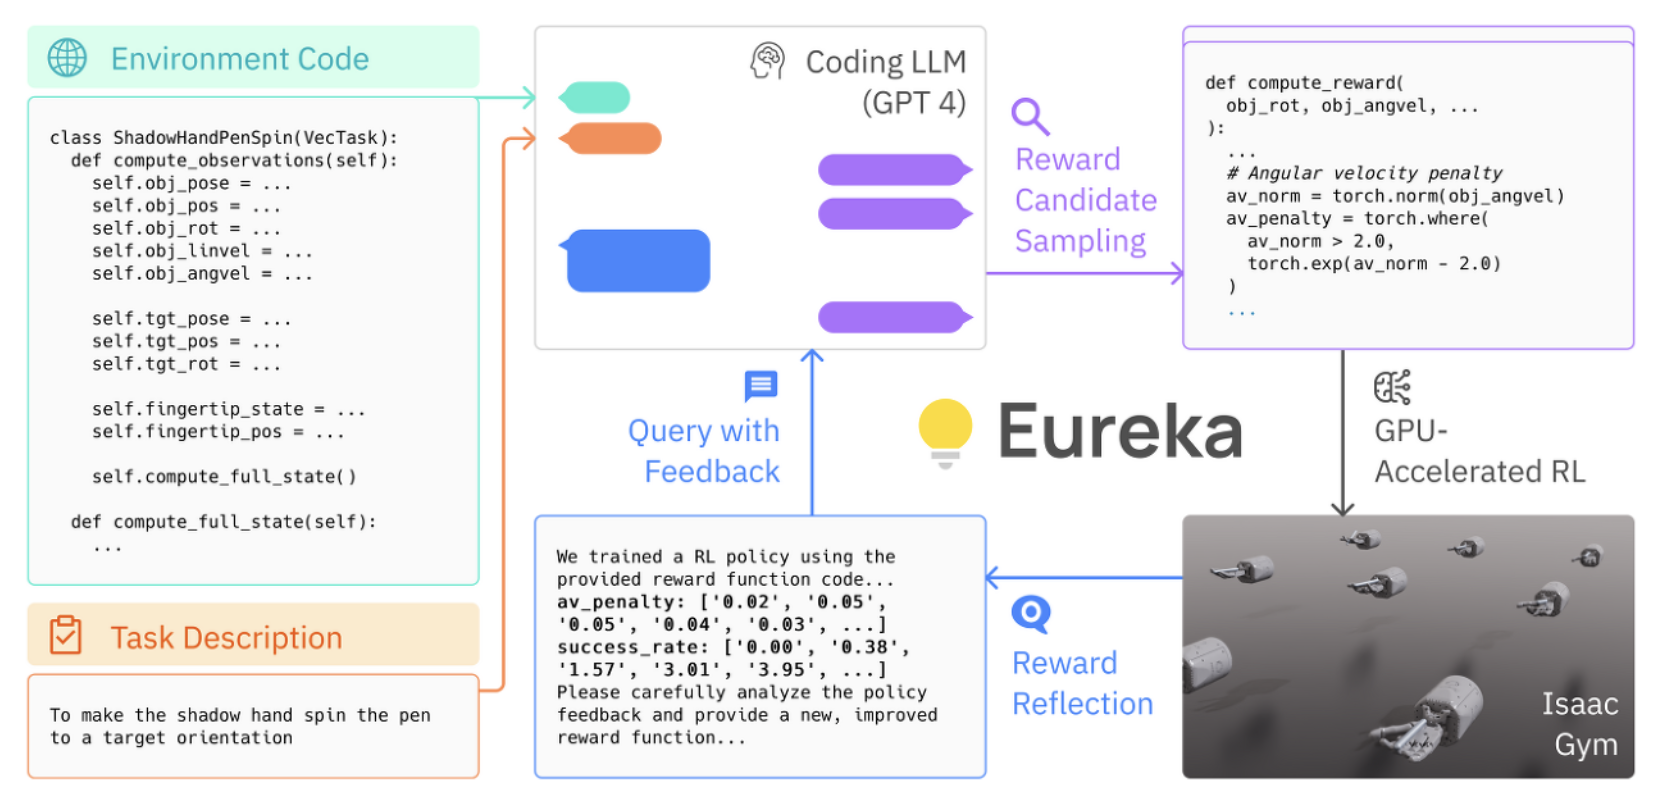
GPT-4를 이용해 환경 소스 코드를 context로 사용하면서 보상 함수를 제로샷(zero-shot)으로 생성하는 것이 가능해졌습니다. GPT-4에서 큰 변화 중 하나로 손꼽히는 부분은 ‘제로샷 학습 기능’입니다. GPT-4는 방대한 양의 텍스트 데이터로 언어의 패턴과 구조를 학습하는 사전 훈련 과정을 통해 특정 작업에 대한 명시적인 훈련을 받지 않아도 해당 작업의 맥락을 이해하고 적합한 텍스트를 생성할 수 있는데요, 유레카는 GPT-4의 제로샷 학습 기능을 활용하여 특정 작업 프롬프트나 보상 템플릿 또는 퓨샷 예제 없이도 주어진 환경과 작업 설명에 적합한 보상 함수를 생성합니다. 다양한 변수들을 고려하는 동시에 의사결정을 내려야하는 고도의 추론능력이 요구되는 로봇에 탁월한 접목이 아닐 수 없습니다. 산업현장에서 돌발상황이 발생했을 때나 재난현장에 투입되는 로봇에서의 유레카의 제로샷 생성능력의 효과는 어마어마할 것으로 예상됩니다🥳
하지만 이토록 즉각적인 대응이 필수요건이라면 GPT의 프롬프트를 입력했을 때 결과가 출력되기까지의 공백은 어떻게 했냐구요?😱 연구진은 GPU 가속 분산 강화학습을 사용했습니다. 훈련을 지원하는 고성능 물리 시뮬레이션 엔진인 Isaac Gym 시뮬레이션 환경에서 여러 GPU 및 기기에 분산시켜 병렬로 에이전트를 훈련하고 GPU를 가속화하여 환경 시뮬레이션의 빠른 속도를 허용함으로써 전체 훈련시간을 줄였습니다.
그 다음, Evolutionary search를 설명할 차례입니다. 로보틱스에서 행동 및 이에 대한 보상(reward)는 컨트롤러에 있어서 필수적인 요소입니다. 보상 함수 하이퍼파라미터의 아주 작은 변화가 로봇의 움직임을 결정하여 컨트롤러의 최종 성능에 큰 영향을 미치기 때문입니다.
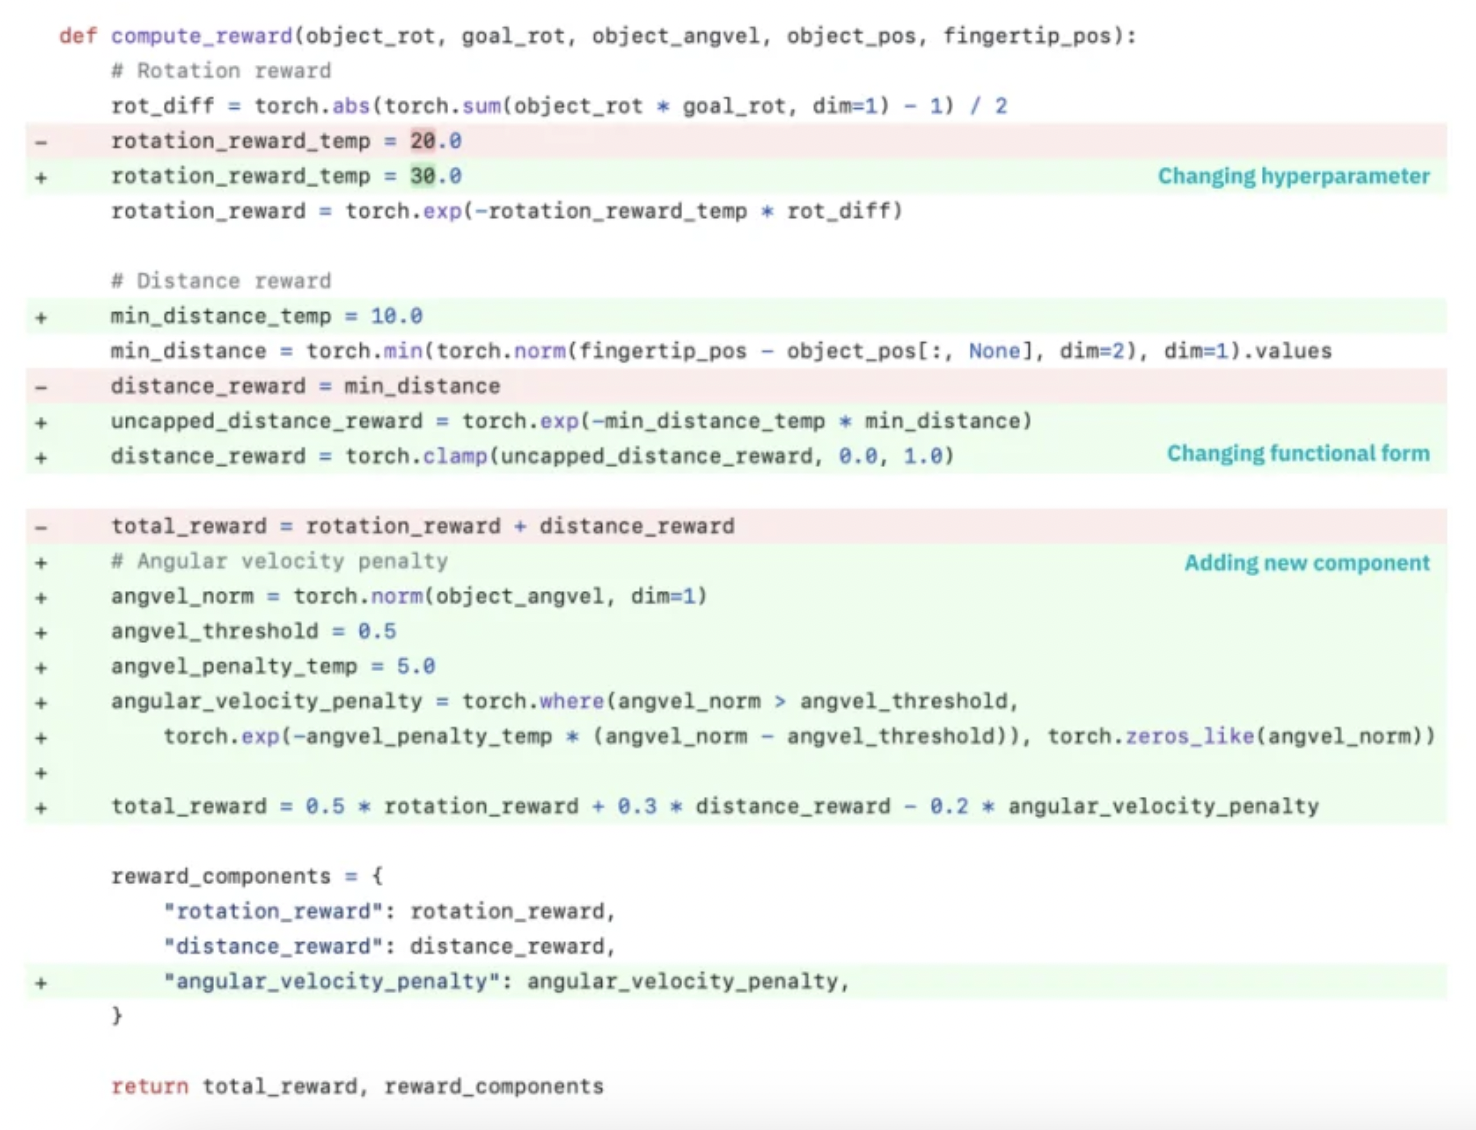
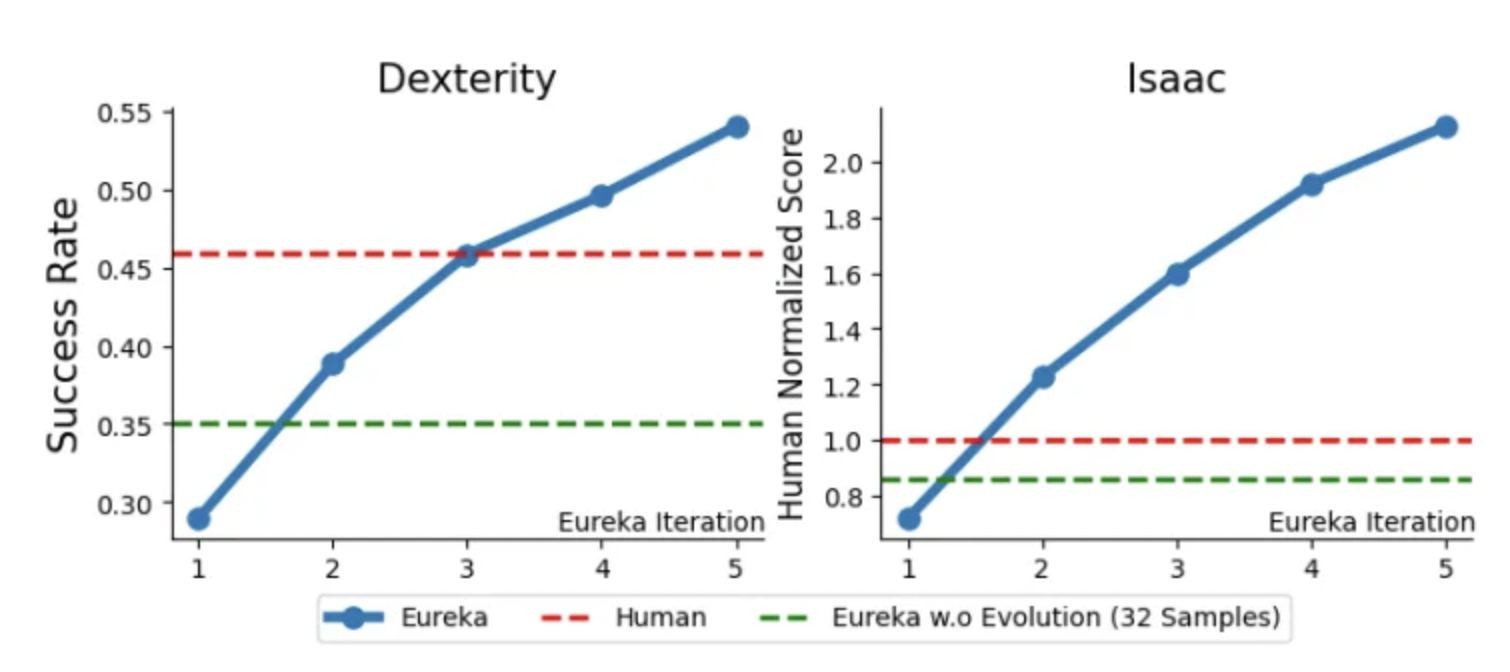
유레카는 Evolutionary search를 통해 반복마다 후보를 제안하고, 그 중 가장 유망한 보상 후보를 강화학습으로 개선합니다. 이는 '하이브리드 그라데이션 아키텍처'(hybrid-gradient architecture) 를 통해 이루어지는데요, 이는 2개의 머신러닝 방법을 통합해 2개의 보상을 제공하는 구조입니다. 유레카에서는 먼저 로봇 모터로 로봇의 본체를 제어하는 저수준 신경망을 이용했습니다. 저수준 신경망은 알고리즘의 내부 루프(inner loop)*에서 강화학습을 진행하는데요, 로봇 본체에서 미세한 관절 등의 정밀한 움직임을 담당하고 있다고 보시면 좋을 것 같습니다.
또 하나의 보상은 LLM을 통해 생성됩니다. 유레카의 연구진은 고도의 추론이 가능한 LLM 모델을 이용해 외부 루프(outer loop)*에서 강화학습을 진행했습니다. 여기서 LLM은 저수준 신경망에 ‘어떻게 움직일 것인지’ 명령을 내리는 역할을 합니다. 유레카는 여기서 GPT-4을 이용해 앞서 언급한 제로샷이 가능토록 하여 추론능력과 돌발상황에 대비하는 능력을 극대화했죠. 이 과정에서는 L2R(Language to Rewards) 이중 단계 대형 언어 모드가 쓰이는데요, 첫째 LLM 프레임워크는 자연어로 된 환경 및 작업에 대한 템플릿을 생성하고, 두 번째 LLM 프레임워크는 수동으로 작성된 보상 API 기본 요소 세트를 호출하여 첫번째 "모션 설명"을 보상 함수를 작성하는 코드로 변환하는 방식입니다.
이렇게 저수준 신경망과 LLM 보상 방법을 수많은 가상환경에서 병렬로 시뮬레이션하면서 유레카는 뛰어난 성능을 보였습니다. <Eureka: Human-Level Reward Design via Coding Large Language Models>에서 "유레카가 10개의 서로 다른 로봇에 걸쳐 29개 작업의 비교군 중 83%에서 인간공학적 보상보다 뛰어난 성능을 발휘, 평균 52% 성능이 향상됐다"는 연구성과를 발표했습니다.
마지막으로 Reward reflection 단계입니다. 유레카는 인간 피드백 강화학습(RLHF)를 도입해 로봇의 보상 함수에 사람이 직접 제공하는 자연어 피드백을 반영했습니다. GPT-3.5에 인간 피드백 강화학습(RLHF)을 도입하고 환각현상이 현저하게 개선되었던 일을 기억하시나요? 로보틱스에서도 자동화된 보상 설계와 함께 인간의 피드백을 도입하는 방식은 이용자 또는 관리자의 피드백을 보상 함수 파라미터에 직접적으로 반영할 수 있다는 점에서 긍정적인 평가를 받고 있습니다.
마무리하며
2023년도 3월, 애질리티 로보틱스(Agility Robotics)가 휴머노이드형 이족 보행 로봇 ‘디지트(Digit)’를 전미 중간 주문 처리 센터에 도입하기 위해 테스트를 하고 있다는 소식이 전해지며 이목이 집중되었습니다. 4족보행로봇의 경우 이동하는동안 항상 3개의 다리로 안정성을 확보하는 것이 가능하지만 이족보행로봇은 보행 도중에 다리 한 개로 몸 전체를 지탱해야하기 때문에 구현 난이도와 효율성 측면에서 회의적인 시각이 많았었습니다. 그렇기 때문에 산업현장에서 이족보행로봇을 실제로 도입한 애질리티 로보틱스의 움직임은 기술적 도전이었습니다.
그리고 최근 9월, 테슬라에서 휴머노이드 로봇 ‘옵티머스(Optimus)’를 공개하며 한 발로 균형을 잡고 자동으로 물체를 분류하고, 요가 자세를 취하는 능력을 선보이며 인사 이외에 할 줄 아는 게 없던 2021년도 발표 당시에 비해 단기간동안 놀라운 발전모습을 보이며 로봇 업계를 뒤흔들었습니다. 옵티머스의 단가는 2만 달러 이하로 책정될 것으로 추정되며, 힘든 노동을 대신 하는 로봇이라고 소개된만큼 테슬라 공장에 투입되어 공작기계를 다루며 물건 옮기기 등의 단순한 업무부터 시작하여 장차 고도화된 업무를 수행할 예정이라고 합니다😮 펜을 돌리고 요가를 하고 힘든 일을 대신 수행하는 이족보행로봇이라니, 정말 휴머노이드와 인간이 공존하는 세상이 머지 않았다는 생각이 듭니다. 2024년도부터는 인공지능라는 단어가 사라질 것이라고 전망하는 전문가들이 있을 정도로 인공지능은 우리의 삶에 깊이 침투하고 있는데요, 로봇은 물리적인 형체가 있는 만큼 그로 인한 변화는 극명할 것 같지 않나요? 로보틱스와 인공지능의 시너지가 가져올 앞으로의 미래가 기대됩니다😁
이번 글을 마지막으로 다이브에서의 제 활동이 끝났습니다. 인공지능에 대해 공부하면서 인공지능이라는 단어가 지닌 의미가 점차 희미해지고 있다는 생각이 듭니다. 중요성이 퇴색하고 있다는 의미가 아니라 ‘월-E’에게 인공지능보다 로봇이라는 호칭이 적절하듯이 모든 영역에서 인공지능이 우리 주변에 자연스럽게 내재되어있다는 느낌이 들었습니다. 당연하지만 생소했던 인공지능에 대해 공부할 수 있어 의미있는 시간이었고, 구독하시는 분들께서도
[AI NEWS]
[Subheading 1]
[Subheading 2]
[Subheading 3]
[딥 다이브 소식]
[WIL]
[WIL]
[다만사]
넣는 게 나을지, 빼는 게 나을지
+저수준 신경망에서는 마르코프 결정 프로세스(MDP)의 프레임워크가 쓰임
→ 여기까지 언급하는게 좋을지
기존 강화학습 기반 다리 로봇
다리가 있는 로봇은 안정적인 발판을 선택하고 환경에 따른 균형, 속도 등의 운동상태를 즉각적으로 변경할 수 있어야 하기 때문에 보상을 기반으로 최대 이익을 얻기 위한 강화학습 방법이 이용되어 왔습니다.
https://arxiv.org/pdf/2203.02638.pdf
https://www.oaepublish.com/articles/ir.2022.20
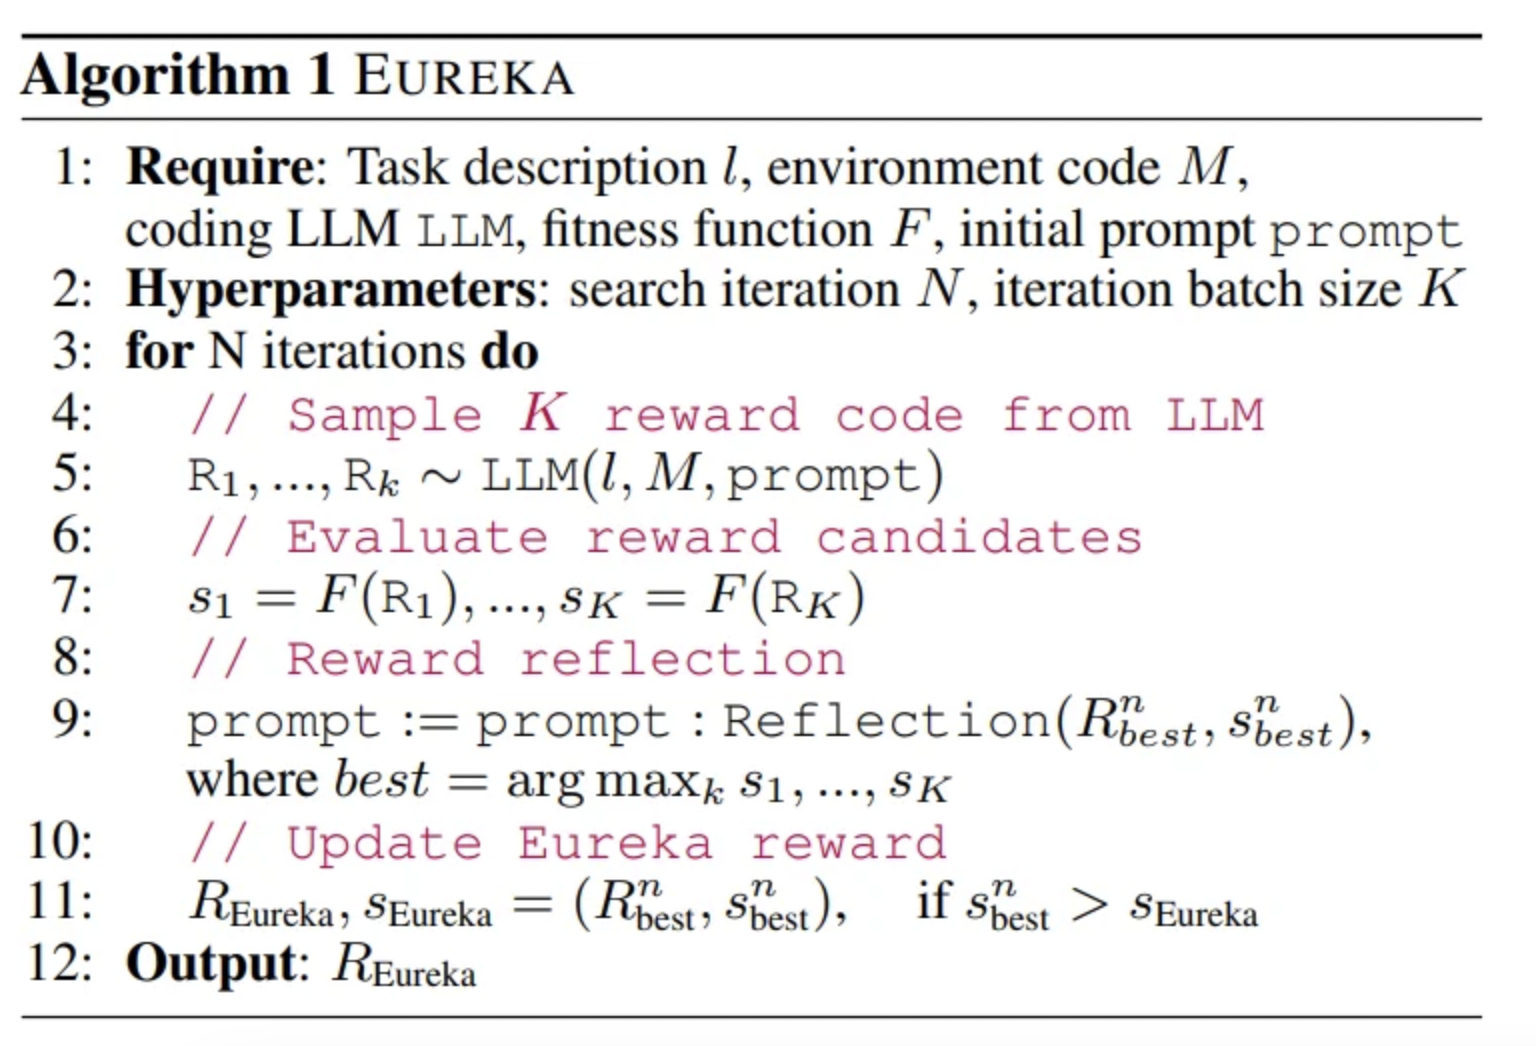
- 한다는 것진화적 탐색(정제 후보를 반복적으로 제안하고 보상), 컨텍스트로서의 환경(제로샷 설정에서 실행 가능한 보상 생성), 보상 반영(세밀한 보상 개선을 가능하게 하기 위해). 알고리즘의 의사 코드는 다음 이미지에 설명되어 있습니다.
https://arxiv.org/abs/2310.12931 메인
영화에 종종 등장하는 인간에 필적한 지능을 지닌 로봇들이 인간을 습격하는 장면은 인공지능으로 ‘학습된’ 로봇들이죠.
다양한 산업분야에서 효율을 극대화하기 위해 로봇 및 자율주행 시스템을 도입하는 과정에서 센서 데이터 처리 및 해석 능력/ 기계 학습 및 강화학습/ 자율주행시스템 의사결정 부문에서 강화학습은 핵심적인 역할을 담당해왔습니다. 현대에는 자율주행, 응급 의료, 수술 로봇, 지능화 서비스 등 다양한 분야에서 로봇이 정교하고 복잡한 작업을 더욱 효율적으로 수행하도록 발전하고 있습니다. 이러한 로봇을 생성하는 단계에서 적용되는 인공지능 기술과 이 과정에서 고려해야할 사항은 무엇일까요?
로봇이라는 단어를 들었을 때 떠오르는 이미지는 금속이나 강철로 만들어진 메카닉한 팔 등 일부 인간 형태를 가진 로봇입니다. 이처럼 로봇을 통해 연상되는 이미지는 직관적인 반면 다양한 분야를 포괄하고 있는 만큼 인공지능이라는 단어를 들었을 때 생각나는 이미지는 사람마다 제각각입니다. 누군가는 GPT와 같은 NLP를 떠올릴 수도 있고, 누군가는 운영체제를 떠올릴 수도 있고, 누군가는 로봇과 마찬가지로 임무를 수행하는 철제기기를 떠올릴 수도 있겠습니다.
사실 인공지능은 너무 광범위 로보틱스와 인공지능의 구분은 범주 측면에서 무의미 하지만 혼동 많음
일반적으로 ‘로봇’이라는 단어를 들었을 때 떠올리는 이미지는 크게 두개로 나뉠거라 생각합니다. 디즈니의 ‘Wall-E’의 Wall-E와 영화 ‘그녀’의 사만다라는 유명한 두 영화를 예시로 들겠습니다. 두 영화 속 Wall-E와 사만다는 각각 로봇에 더 가까울까요, 인공지능에 더 가까울까요?