
Thought to Text
수기로 직접 기록을 하던 세대에 이어 타이핑, 녹음, 음성녹음의 텍스트 변환 등 획기적인 기록도구들이 발명되었지만 어떠한 수단도 결국은 생각의 속도를 따라가지는 못하는 것 같습니다. 재빠르게 기록으로 남기더라도 입 밖으로 내는 순간 머릿속의 생각이 한번 가공되고 정제된 것만 같은 아쉬움이 남기도 합니다. 가끔은 머리 속 생각들을 처음 느낌 그대로 보존하고 싶은데 말이에요📌
발상의 변환 💬
대규모 언어 모델을 이용해서 뇌 활동을 문장으로 옮기는 연구가 이루어지고 있다는 사실을 알고 있었나요? 오사카 대학의 신경과학자 니시모토 신지는 “뇌 활동은 일종의 암호화된 신호이며 언어 모델은 이를 해독하는 방법을 제공한다”고 말했습니다. 언어에 뇌가 어떻게 활성화되는지를 관측하여 인공지능에 학습시킨다면 반대로 뇌가 활성화되는 양상을 보고 어떠한 언어를 이야기하고자 하는 것인지 예측할 수 있다는 것이죠.
fMRI를 도입한 번역원리
언어 모델은 다양한 소스의 텍스트 데이터의 문맥, 의미, 문법 등 다양한 언어적 특성을 활용하여 다음 단어를 예측합니다. 이 과정에서 모델은 단어나 문장이나 문서가 어떻게 연관되어 있는지를 나타내는 컨텍스트 임베딩(Context Embedding)을 수행합니다. <Semantic reconstruction of continuous language from non-invasive brain recordings>의 연구진들은 fMRI*를 분석하여 피험자의 생각을 텍스트로 번역할 수 있는 방법에 대한 연구를 진행했습니다.
실험방법을 요약하면 다음과 같습니다. 세 명의 피험자가 16시간동안 이야기하는동안 뇌 반응을 기록하면서 자극 문구나 의미론적 특징을 포착할 때의 fMRI 특징을 추출한 데이터 세트로 모델을 훈련했습니다. 그리고 선형 회귀를 사용해 언어적 특징이 뇌 반응에 어떻게 영향을 미치는지 모델링을 한 후 임의의 단어 시퀀스나 문장이 주어졌을 때 피험자의 뇌가 어떻게 반응할 것인지 예측하고, 그 가능성에 점수를 매겼습니다.
이제 생각의 번역 과정을 표와 함께 상세히 살펴보겠습니다🔎
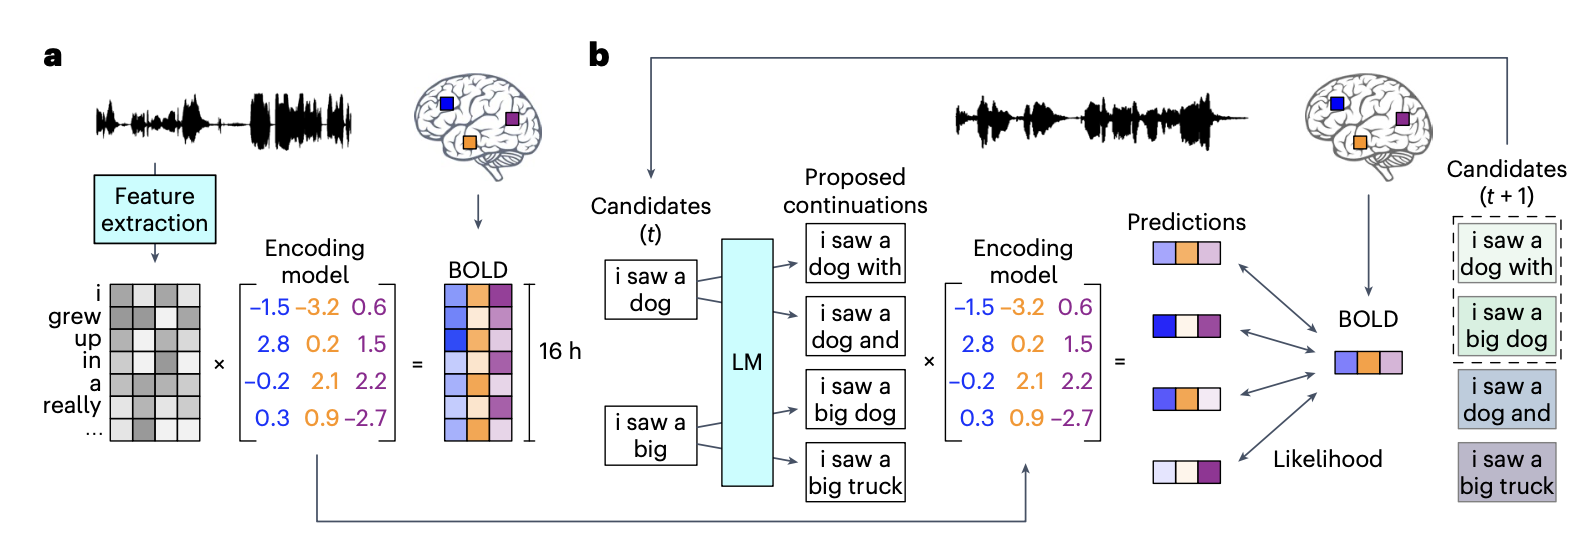
a. 자극 문구나 의미론적인 특징으로부터 뇌 반응을 예측하기 위해 각 피험자에 대한 인코딩 모델을 추정했습니다. BOLD fMRI 응답은 각 피험자가 16시간 동안 이야기를 듣는 동안 기록되었습니다.
b. 새로운 뇌기록으로부터 언어를 재구성하기 위해 디코더는 후보 단어 시퀀스를 유지합니다. 새로운 단어가 감지되면 언어모델(LM)은 이어지는 단어를 제안하고 인코딩 모델은 각각의 제안에 대한 뇌 반응 가능성에 대한 점수를 매깁니다. 가장 가능성이 높은 자극 단어들이 유지됩니다.
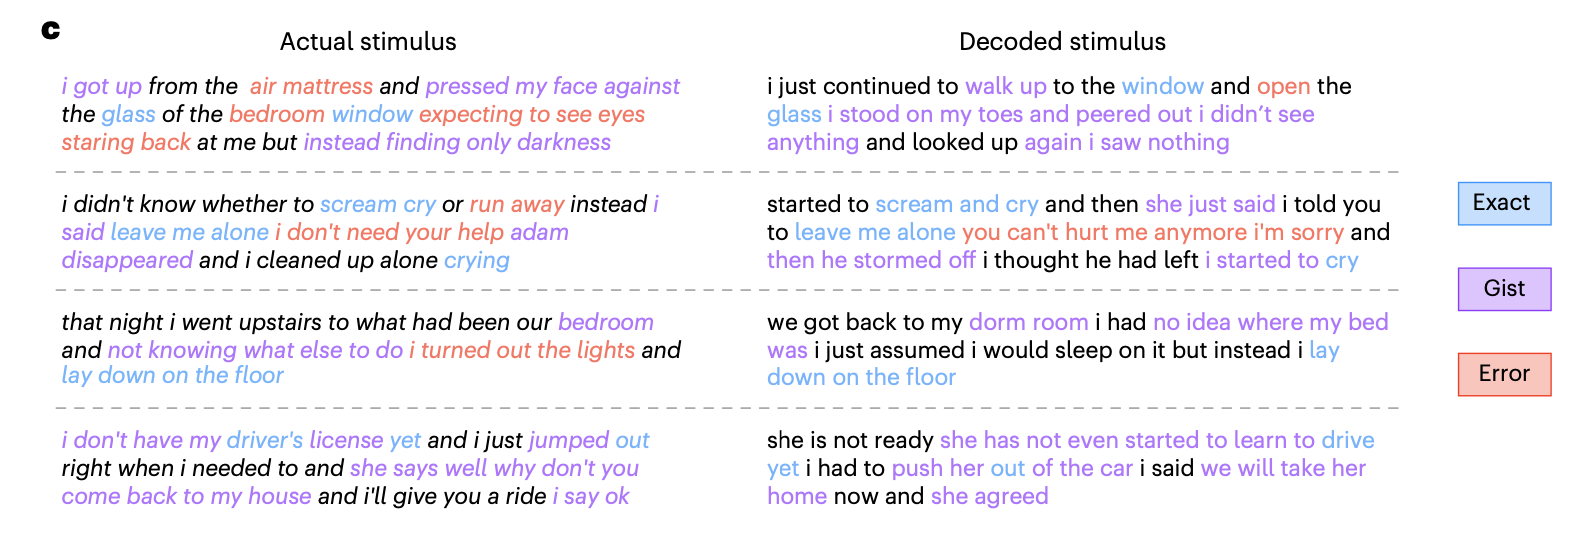
c. 디코더는 피험자가 모델 훈련에 사용되지 않은 테스트 이야기를 듣는 동안 기록된 단일 실험 뇌 반응에 대해 평가되었습니다. 사진의 좌측은 실제 테스트 이야기들이고, 우측은 디코더의 예측을 세그먼트 단위로 나누어 함께 나타낸 사진입니다. 문장의 결론부분은 똑같지만 앞에 문장요소들의 차이에 의해서 완전히 다른 문장이 되기도 하는데요🤔 저는 생각보다 실제 이야기와 디코더의 예측이 많이 달라서 놀랐습니다. 표와 함께 분석결과를 살펴봅시다.
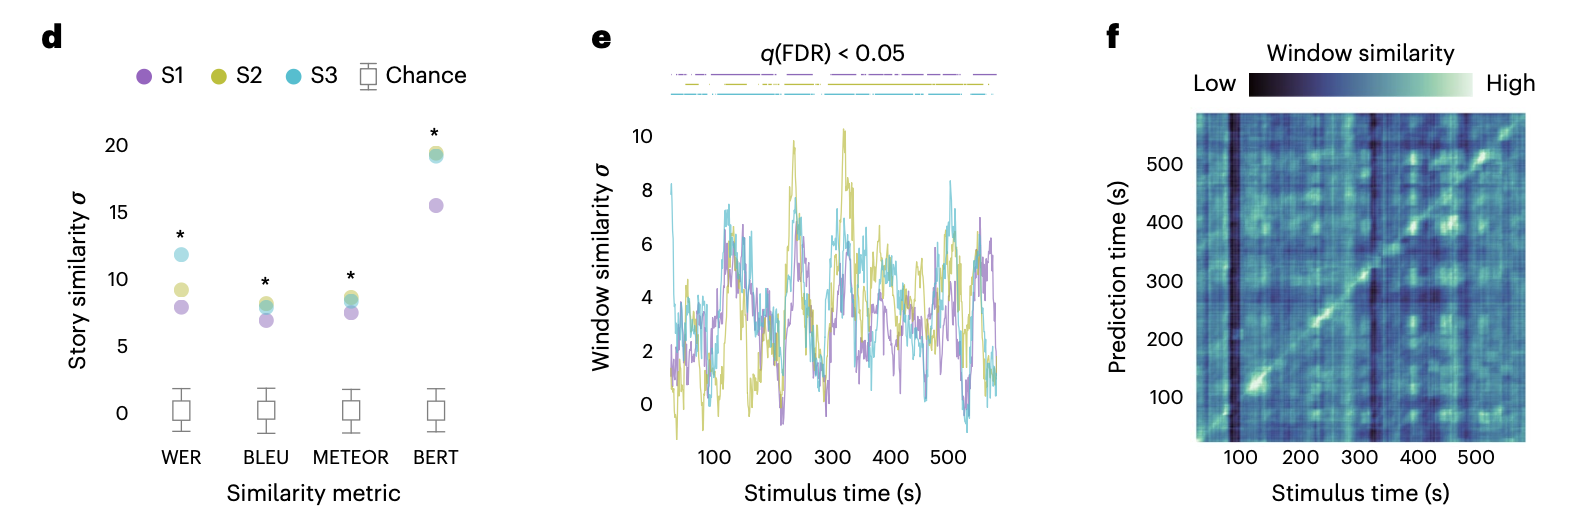
d. c의 결과를 통해 알 수 있듯 디코더의 예측 결과와 실제 문구 사이의 유사도를 WER/ BLEU/ METEOR/ / BERT 여러 가지 언어 유사도 지표를 사용하여 평가했을 때 디코더의 예측 결과가 기대치보다 유의미하게 실제 자극과 유사하다는 평가가 나왔습니다. 또한 Null distribution의 평균으로부터 표준편차의 몇 배만큼 떨어져 있는지를 보여주고 있어 연구진들은 어떠한 유사도 지표로 측정하더라도 실제 뇌 활동과 유사하다는 결과를 도출했습니다. 문장과 문장의 의미가 너무 달라서 그렇지, 단어들의 조합과 문장의 결론부분만 놓고 보면 fMRI 기록을 통해 생각을 역추론한 것 치고는 놀라운 정확도를 자랑한 셈이긴 하죠.
e. 항목에서는, BERT 유사도 지표를 사용하여 디코더의 예측 결과와 실제 자극 단어 사이의 유사도를 평가하였습니다. 이 때, 대부분의 시간대에서 디코딩 점수가 기대치보다 유의하게 높았다는 결과를 나타내었습니다.
f. 색상이 더 진한 부분일수록 디코더의 예측이 실제 자극과 더 유사하다는 것을 나타내어 디코더가 뇌 활동을 토대로 언어를 정확하게 예측할 수 있는 가능성을 보여주었습니다.
https://www.statnews.com/2016/08/03/fmri-science-statistics-mistakes/
실험의 보완점과 시사점
같은의미, 다른 표현방식🗣️
WER, BLEU, 및 METEOR 와 같은 표준 유사도 지표를 통해 디코더의 예측 결과와 실제 문구 사이의 각 대응하는 시퀀스가 공유하는 단어 수를 측정하여 비교할 수 있었지만 ‘She is going home’, ‘She is on her way home’과 같이 단어 수는 다르지만 같은 의미를 내포하는 문구가 있을 수 있다는 한계점이 존재했습니다. 이는 문맥과 문장 내의 단어 사이의 관계를 파악하는 BERTScore를 평가지표로 도입함으로써 보완되었습니다.
주체 협력 문제🤝
생각을 번역하는 해당 실험에는 윤리적 요소들이 중대한 고려사항이었습니다. 개인 정보 침해문제와 정신적 프라이버시 침해 가능성에 피험자의 동의가 필요하기 때문에 디코더 훈련에는 긴밀한 주체 협력이 필요합니다. 그리고 이렇게 실험주체와의 강한 협력을 통해 얻을 수 있는 데이터는 대상에 의해 크게 좌지우지되는 경향이 있습니다. 이를 검증하기 위해 설계된 실험이 있었습니다. 피험자들은 ‘동물 이름을 짓고 상상하기’, ‘상상한 것과 다르게 말하기’, ‘7로 세기’ 세 가지 인지 작업을 수행했습니다. 해당 데이터세트로 모델을 훈련시켰을 때 디코딩 성능은 크게 낮아졌습니다. 이는 누군가 의도적으로 적대적인 시나리오를 기획하면 디코딩 프로세스가 무너질 수 있다는 디코더의 한계입니다.
주의효과🚨
뇌는 짧은 시간에도 외부환경의 변화에 따라 수없이 많은 생각이 오고가는데요, 의미론적인 표현은 어느 생각에 주의를 기울이는지에 따라 그 해석이 달라질 수 있기 때문에 디코더는 자극을 선택적으로 재구성하여야 합니다. 디코더가 자극을 선택적으로 재구성하는지 알아보기 위한 실험에서 피험자들은 두 명의 연사자가 동시에 프리젠테이션을 하는 강연에 참석해 둘 중 한 연사자에게 집중하도록 하는 미션을 부여받았습니다. 프리젠테이션이 끝난 후 피험자들에게 상상을 하도록 했을 때 디코더의 예측 결과는 집중하도록 미션을 부여받은 측의 연사자의 스토리와 훨씬 더 유사한 결과를 나타내었습니다. 이러한 실험결과는 디코더가 피험자가 적극적으로 주의를 기울이고 있는 생각만 재구성할 수 있음을 시사하여 단점인 동시에 선택권이 있다는 면에서는 장점이 되는 것 같습니다.
순전한 상상도 재현이 가능할까?🧠
앞서 설명한 실험은 세 명의 피험자가 16시간동안 이야기하는동안 기록한 뇌 반응 데이터를 토대로 ‘임의의 단어 시퀀스나 문장이 주어졌을 때’에 대한 실험이었습니다. 즉 ‘임의의 단어 시퀀스나 문장’이라는 외부 자극이 주어진 것이죠. 그렇다면 임의의 문장이나 시퀀스가 주어지지 않는 경우에 순전히 머릿속에서 촉발된 상상만으로도 텍스트를 통한 재현이 가능할까요? **<Semantic reconstruction of continuous language from non-invasive brain recordings>논문에서는 특정한 언어 작업이나 자극에 제한되지 않고 다양한 종류의 언어 처리에 일반화 될 수 있는 능력을 시사합니다. 이는 Thought to Text** 기술이 언어 장애가 있는 개인을 위한 의사소통 장치부터 기록을 위한 도구까지 다양한 분야에서 이 기술을 활용할 수 있는 잠재력을 보여줍니다.
마무리하며
현재의 시점에서 과거가 되어버린 생각을 기록하는 것이 아닌 현재의 시점에서 현재의 생각을 자동으로 번역할 수 있다는 것. 처음 Thought to Text라는 기술을 보았을 때 머릿속 생각들을 그대로 보존할 수 있겠다는 기대감에 부풀었었습니다. 하지만 c의 실험 결과를 보자 기대감은 이내 실망감으로 바뀌었습니다. 일부 구절이 일치하거나 비슷한 의미를 내포할 뿐, 언어의 특성상 일부 구절의 오역만으로도 문장의 의미는 완전히 달라져서 이러한 부분들이 보완되기까지 앞으로도 많은 시간이 소요될 것으로 보였기 때문입니다.
파고들수록 Thought to Text 기술은 기록수단으로서의 의미와 함께 언어 장애가 있는 개인의 지평을 확대하는 기술로 발전할 수 있겠다는 기대감이 듭니다. fMRI 스캐너는 부피가 크고 가격은 비싸지만 기존의 신호를 읽기 위해 신경을 직접 건드리는 침습적인 방식들과, 의미론적인 차이를 반영하기보다 뇌 활동의 시간적인 차이를 보여주는 EEG*와 차이가 있다는 면에서 기존의 방식들과는 큰 차이가 있습니다. 현재는 생각을 높은 정확도로 재현하지는 못하지만 일부 구절의 의미는 보존된다는 점에서 의사소통의 물꼬를 틀 수 있는 기술이 되었으면, 그리고 머릿 속 생각을 그대로 보존할 수 있는 기술로 발전했으면 합니다🍀