
큰 모델의 추론 능력을 작은 모델에게 옮길 수 있을까?
안녕하세요, 에디터 잭잭입니다.
최근 AI 연구에서는 모델을 더 크게 만드는 것만큼이나, 이미 만들어진 모델을 어떻게 더 잘 학습시킬지가 중요해지고 있습니다. 방대한 데이터로 기본적인 언어와 지식을 익히는 사전 학습(Pre-training) 이후, 모델이 사람의 지시를 잘 따르고 수학이나 코딩처럼 복잡한 문제를 해결하도록 만드는 사후 학습(Post-training)의 역할도 함께 커지고 있죠.
특히 최근에는 모델이 바로 답을 내놓는 데 그치지 않고, 여러 단계의 추론(Reasoning)을 거쳐 문제를 해결하는 능력이 중요해졌습니다. 이를 학습하는 대표적인 방법 중 하나가 강화학습(Reinforcement Learning, RL)입니다. 모델이 직접 문제를 풀고 그 결과에 따라 보상을 받으면서 더 좋은 전략을 찾아가도록 하는 방식입니다.
하지만 모델이 좋은 전략을 직접 찾아가게 하는 것만이 방법은 아닙니다. 이미 문제를 잘 푸는 강한 모델이 있다면, 그 모델이 가진 능력을 더 작은 모델에게 전달할 수도 있습니다. 큰 모델의 지식을 작은 모델에 옮기는 지식 증류(Knowledge Distillation, KD)가 대표적인 방법입니다.
기존 지식 증류에서는 주로 큰 모델이 미리 생성한 좋은 응답이나 풀이를 작은 모델이 따라 배우도록 합니다. 최근에는 여기서 조금 다른 접근이 주목받고 있습니다.
큰 모델이 만들어둔 좋은 답만 학습하는 대신, 작은 모델이 실제로 생성한 응답을 다시 학습에 활용하는 On-Policy Distillation(OPD)입니다. 작은 모델이 현재 자신의 능력으로 만들어낸 응답을 큰 모델도 함께 보고, 그 상태에서 얻은 학습 신호를 다시 작은 모델에 전달하는 방식입니다.
이번 뉴스레터에서는 기존 지식 증류가 작은 모델을 어떻게 가르쳐왔는지부터 시작해, OPD가 무엇을 다르게 하는지, 그리고 작은 모델이 직접 만든 답을 이용하는 방식에서 새롭게 나타나는 문제까지 살펴보겠습니다. 그 출발점은 가장 익숙한 방식, 잘하는 AI가 만든 답을 작은 AI에게 그대로 보여주는 것입니다.
잘하는 AI의 답을 그대로 따라 배우면 되지 않을까?
지식 증류에서는 일반적으로 더 강한 모델을 교사 모델(Teacher), 그 능력을 전달받는 모델을 학생 모델(Student)이라고 부릅니다. 지식 증류를 구현하는 대표적인 방식 중 하나는 교사 모델이 만든 좋은 답이나 풀이를 미리 준비하고, 이를 바탕으로 학생 모델을 학습하는 것입니다.
예를 들어, 다음과 같은 간단한 수학 문제가 있다고 해봅시다. 미리 준비된 학습 데이터에는 문제와 정답이 하나의 쌍으로 들어 있습니다.
("What is 5 + (2 × 3)?", “11”)
여기서 중요한 것은 학생 모델이 단순히 정답 11만 외우는 것이 아니라는 점입니다. 교사 모델은 다음 토큰(토큰)으로 무엇이 적절한지에 대한 확률 분포를 만들 수 있습니다. 예를 들어 정답을 생성해야 하는 위치에서 교사 모델은 11을 90% 확률로 예측하고, 7과 8은 각각 7%, 3% 확률로 예측할 수 있습니다. 따라서 학생 모델의 확률 분포가 교사 모델의 분포와 비슷해지도록 학습시킬 수 있습니다.
즉 교사 모델은 단순히 “정답은 11이야”라고 알려주는 것보다 더 많은 정보를 전달할 수 있습니다. 어떤 토큰을 얼마나 선호하는지까지 학습 신호로 사용할 수 있기 때문입니다. 이처럼 모든 응답 토큰에서 세밀하게 제공되는 신호를 Dense Feedback(Kevin Lu et al., 2025)이라고 합니다.
그런데 여기에는 한 가지 문제가 있습니다. 학습 과정에서는 미리 준비된 좋은 응답을 바탕으로 학습하지만, 실제 추론에서는 자신이 직접 생성한 응답을 이어가야 한다는 점입니다.
따라서 학습할 때 보지 못한 방향으로 한번 잘못 들어가면, 이후의 추론 역시 그 오류의 영향을 받을 수 있습니다. 이처럼 학습할 때 접하는 응답과 실제 추론에서 모델 자신이 만들어내는 응답 사이에 차이가 생기는 현상을 Exposure Bias라고 부릅니다.
이러한 문제를 해결하기 위해 On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes (Agarwal et al., 2023) 연구진은 고정된 응답에만 의존하지 않고, 학생 모델이 실제로 생성한 응답을 바탕으로 교사 모델의 피드백을 받으며 학습하는 방식을 제안했습니다. 이는 오늘날 OPD의 핵심 아이디어이기도 합니다.
학생이 실제로 푼 문제로 배운다
그렇다면 OPD는 기존 지식 증류와 무엇이 다를까요? 가장 큰 차이는 학습에 사용할 답을 미리 준비해두는지, 아니면 학생 모델이 현재 직접 만들어내는지에 있습니다.
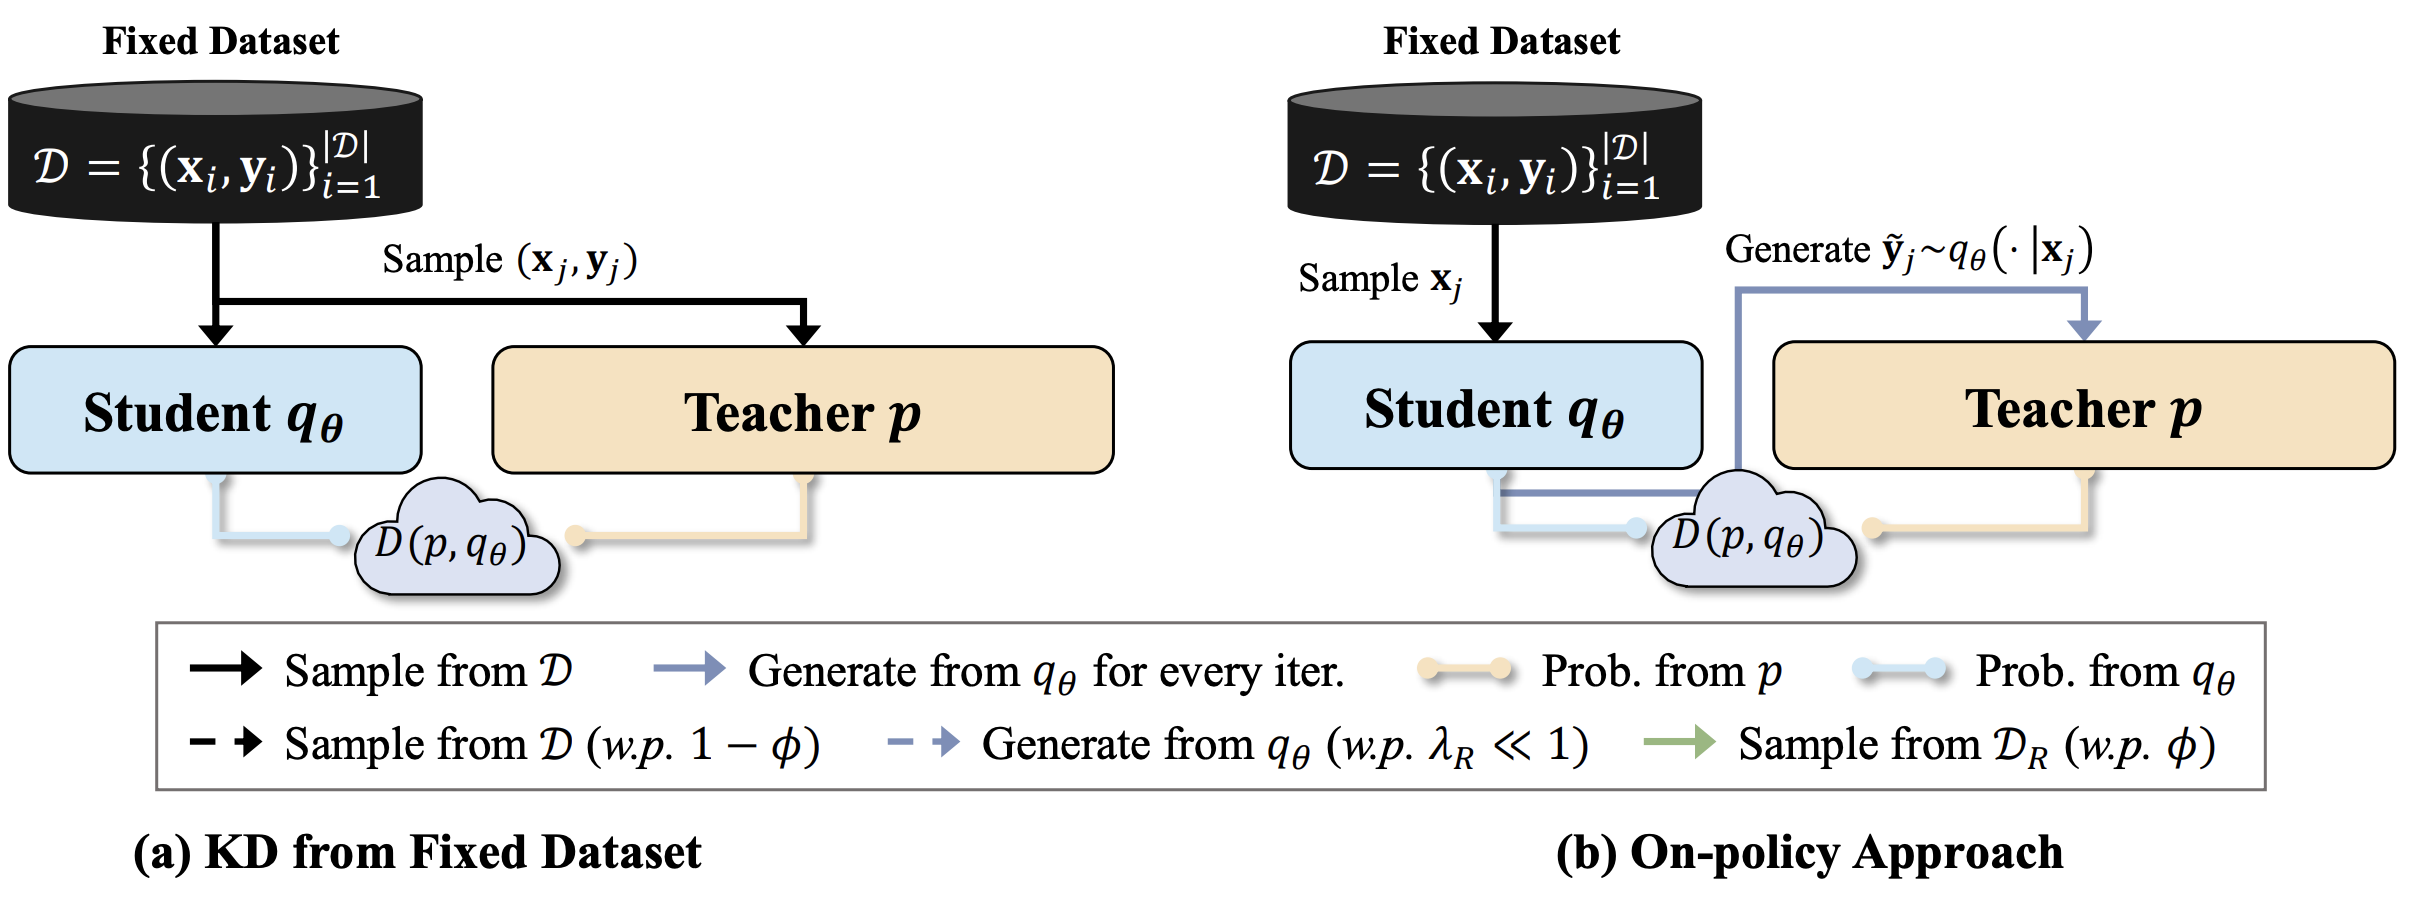
출처: DistiLLM: Towards Streamlined Distillation for Large Language Models (Ko et al., 2024)
왼쪽의 기존 지식 증류 방법은 미리 준비된 문제와 답을 교사 모델과 학생 모델이 함께 봅니다. 반면 오른쪽의 OPD에서는 데이터셋에서 문제만 가져온 뒤, 학생 모델이 그 문제에 대한 답을 직접 생성합니다. 이렇게 학생 모델이 한 번 생성한 응답을 Rollout이라고 부릅니다.
예를 들어 학생 모델이 5 + (2 × 3)이라는 문제에 다음과 같이 답했다고 해봅시다. “5 + 2 is 7, and 7 × 3 is 21." 계산 순서를 잘못 적용한 틀린 풀이입니다. OPD에서는 이 응답을 버리지 않고, 학생 모델이 실제로 생성한 그대로 교사 모델에게 보여줍니다.
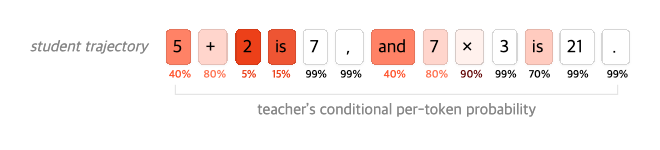
출처: On-Policy Distillation (Kevin Lu et al., 2025)
그림 아래의 숫자는 학생 모델이 생성한 각 토큰에 대해 교사 모델이 부여한 조건부 확률입니다. 즉, 앞에서 생성된 내용을 바탕으로 교사 모델이 해당 토큰을 다음 토큰으로 선택할 확률을 나타냅니다.
예를 들어 2에는 5%, is에는 15%처럼 낮은 확률이 부여되어 있는데, 이는 해당 토큰들이 앞선 내용을 고려했을 때 교사 모델이라면 상대적으로 덜 선택했을 토큰이라는 뜻입니다.
학습할 때는 이러한 교사 모델의 확률 분포와 학생 모델의 확률 분포 사이의 차이가 줄어들도록 학생 모델을 업데이트합니다. 즉 정답 풀이만 따라 배우는 것이 아니라, 학생 모델이 실제로 문제를 풀면서 만들어낸 응답 위에서 교사 모델의 Dense Feedback을 토큰 단위로 받는 것이 OPD의 핵심입니다.
Reasoning 모델에서 OPD가 주목받는 이유
이런 특성은 긴 추론 과정을 생성하는 최근 Reasoning 모델에서 더욱 중요해졌습니다. 어려운 수학이나 코딩 문제를 해결하면서 수백에서 수천 토큰에 달하는 긴 추론 과정을 생성하기도 하기 때문입니다.
추론이 길어질수록 초반 오류의 영향도 커집니다. 짧은 답변에서 한 번 잘못된 방향으로 가는 것과, 수천 토큰에 이르는 추론의 초반부터 잘못된 가정을 세우는 것은 이후 과정에 미치는 영향의 범위가 다릅니다. 앞에서 발생한 오류가 이후 생성 과정에 계속 남고, 그 상태에서 다시 다음 토큰을 생성하면서 오류가 누적될 수 있습니다. 이처럼 앞선 오류의 영향이 이후 생성 과정에 누적되는 현상을 오류 누적(Compounding Error)이라고 합니다.
동시에 이미 강한 추론 모델이 갖고 있는 능력을 더 작은 모델에 효율적으로 전달하려는 필요도 커졌습니다. Qwen3 Technical Report에서는 동일한 Off-Policy Distillation을 거친 Qwen3-8B Checkpoint에서 시작해, 이후 강화학습과 On-Policy Distillation을 각각 적용한 결과를 비교했습니다.
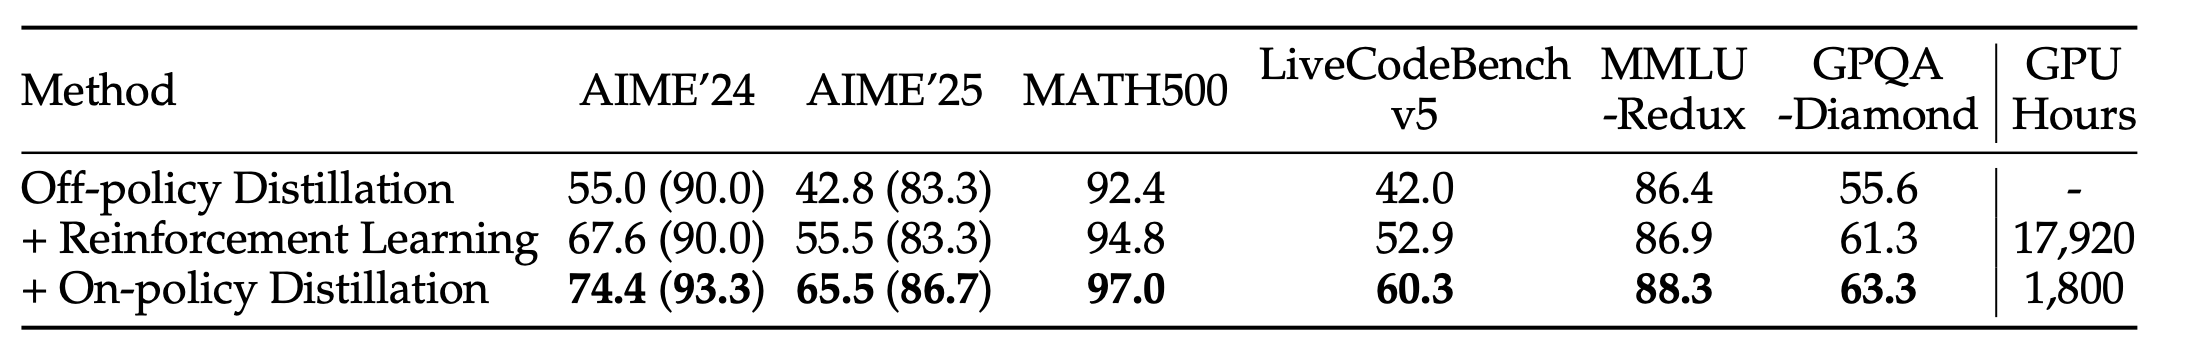
출처: Qwen3 Technical Report (Yang et al., 2025)
표에서 눈에 띄는 점은 OPD가 특정 benchmark 하나에서만 좋아진 것이 아니라, 수학·코딩·지식 추론을 포함한 여러 평가에서 강화학습보다 전반적으로 높은 성능을 보였다는 점입니다. 동시에 보고된 학습 비용(GPU Hours)도 강화학습의 약 1/10 수준이었습니다.
물론 하나의 실험 결과만으로 OPD가 항상 강화학습보다 효율적이라고 일반화할 수는 없습니다. 다만 Qwen3의 결과는 강한 교사 모델이 이미 존재하는 상황에서 OPD가 효율적인 사후 학습 방법이 될 수 있음을 보여줍니다.
여기까지만 보면 OPD는 꽤 이상적인 방법처럼 보입니다. 학생 모델이 실제로 만들어낸 응답을 학습에 활용하면서도, 교사 모델의 세밀한 학습 신호를 받을 수 있기 때문입니다.
OPD의 가장 큰 장점이 약점이 되는 순간
지금까지 OPD의 장점은 학생 모델이 실제로 만들어낸 응답에서 학습한다는 점이었습니다. 그런데 학생 모델이 초반부터 잘못된 방향으로 추론하기 시작한다면 어떨까요?
자기회귀 모델(Autoregressive Model)에서는 이미 생성된 내용(Prefix)이 이후 토큰을 생성할 때 계속 조건으로 사용합니다. 학생 모델이 초반에 잘못된 가정이나 공식을 선택한 경우, 이후의 추론도 그 잘못된 Prefix를 바탕으로 계속 이어질 수 있습니다.
Pass the Baton: Trajectory-Relayed On-Policy Distillation(Xu et al., 2026)에서는 이를 Prefix Failure라고 설명합니다. 학생 모델이 초반에 잘못된 추론 방향을 선택하면 이후 생성 전체가 그 방향 위에서 쌓이면서, 길게 잘못된 생성이 길게 이어질 수 있다는 것입니다.
Standard OPD에서는 이렇게 생성된 Trajectory도 그대로 학습에 사용되기 때문에, 논문은 이 구간에서 교사 모델의 학습 신호가 점차 신뢰하기 어려워지고 불필요한 계산도 발생할 수 있다고 지적합니다.
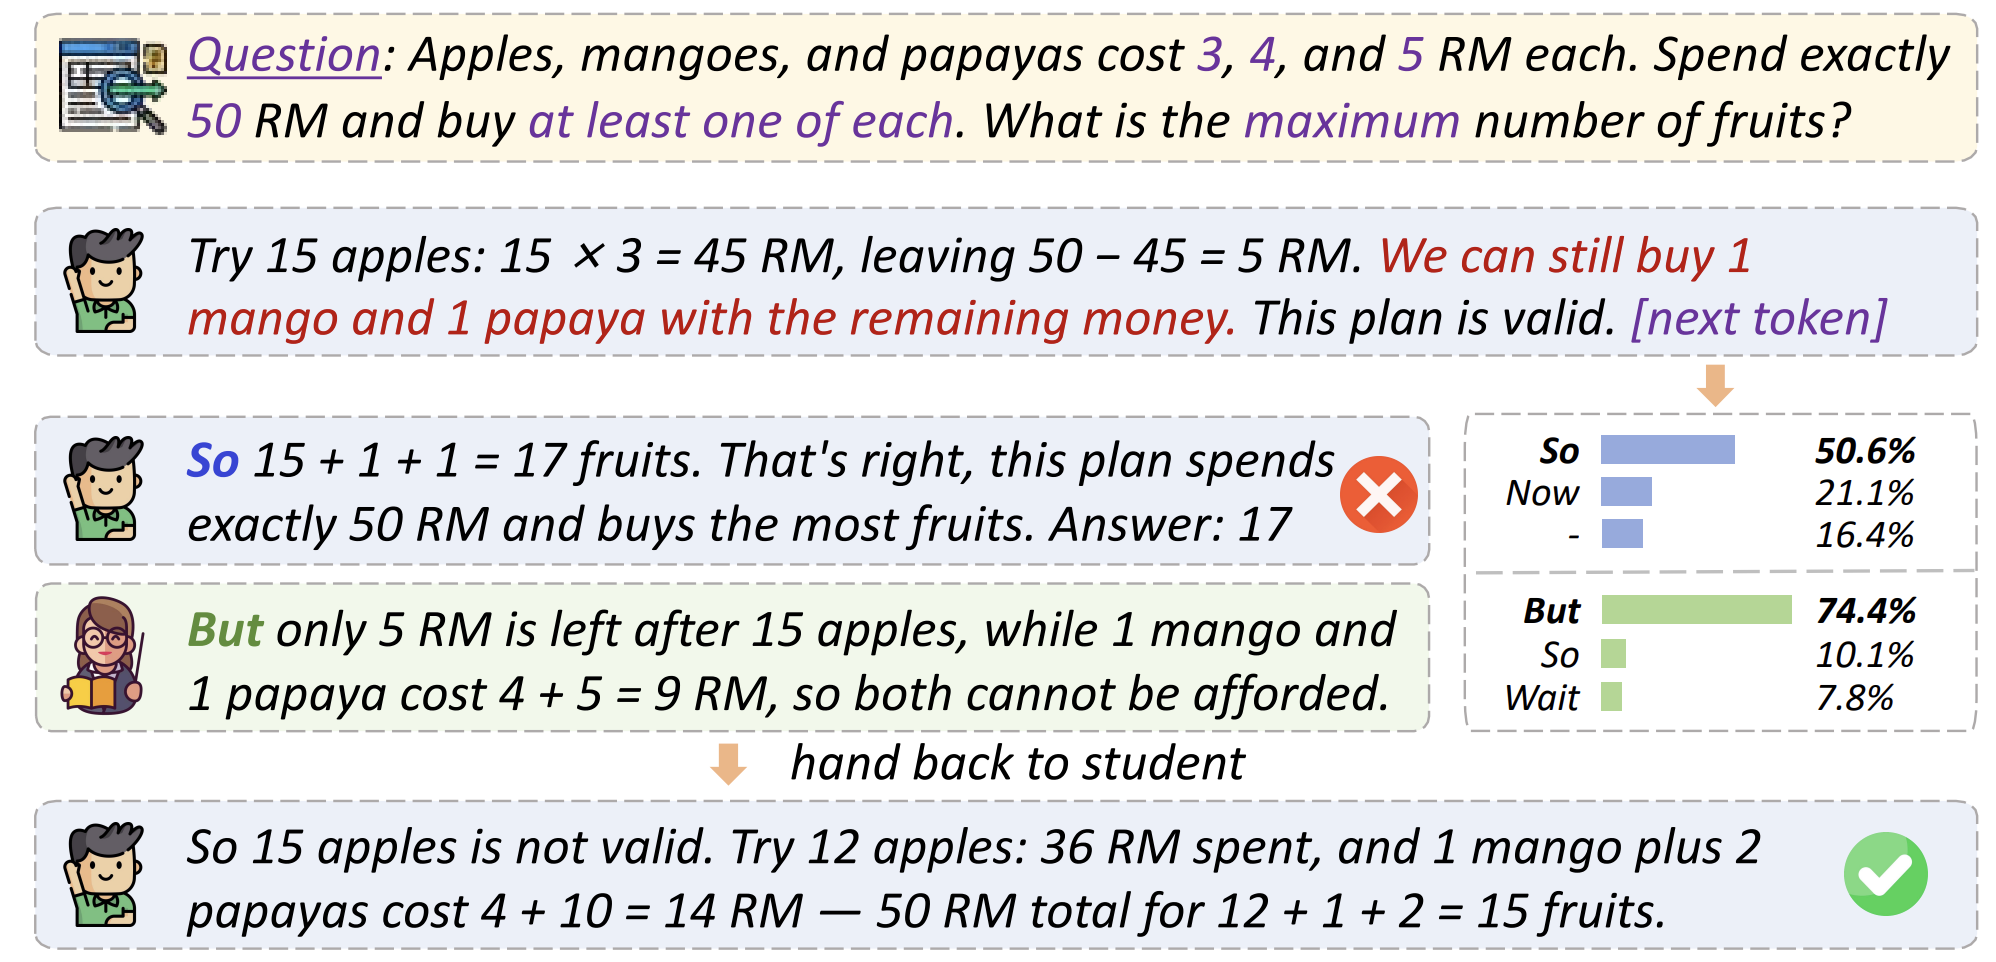
출처: Pass the Baton: Trajectory-Relayed On-Policy Distillation (Xu et al., 2026)
위 예시를 보면, 학생 모델은 사과 15개를 산 뒤 남은 5 RM으로 망고와 파파야를 각각 하나씩 살 수 있다고 잘못 판단합니다. 그 상태에서 다음 토큰을 생성하려 할 때 학생 모델은 So를 가장 높은 확률로 선택하며 기존 풀이를 그대로 이어가려 합니다.
반면 같은 Prefix를 본 교사 모델은 But을 74.4%의 높은 확률로 선택해 앞선 추론을 다시 검토하려 합니다.
즉 같은 Prefix를 보더라도 학생 모델은 현재 방향을 계속 이어가려 하고, 교사 모델은 방향을 전환하려는 차이가 나타납니다. 논문은 이를 Teacher–Student Continuation Asymmetry라고 부릅니다. 연구진은 이 차이를 이용하면 정답 정보나 별도의 검증 모델 없이도, 교사 모델이 개입할 만한 지점을 찾을 수 있다고 보았습니다.
이를 바탕으로 제안한 방법이 Relay-OPD입니다.
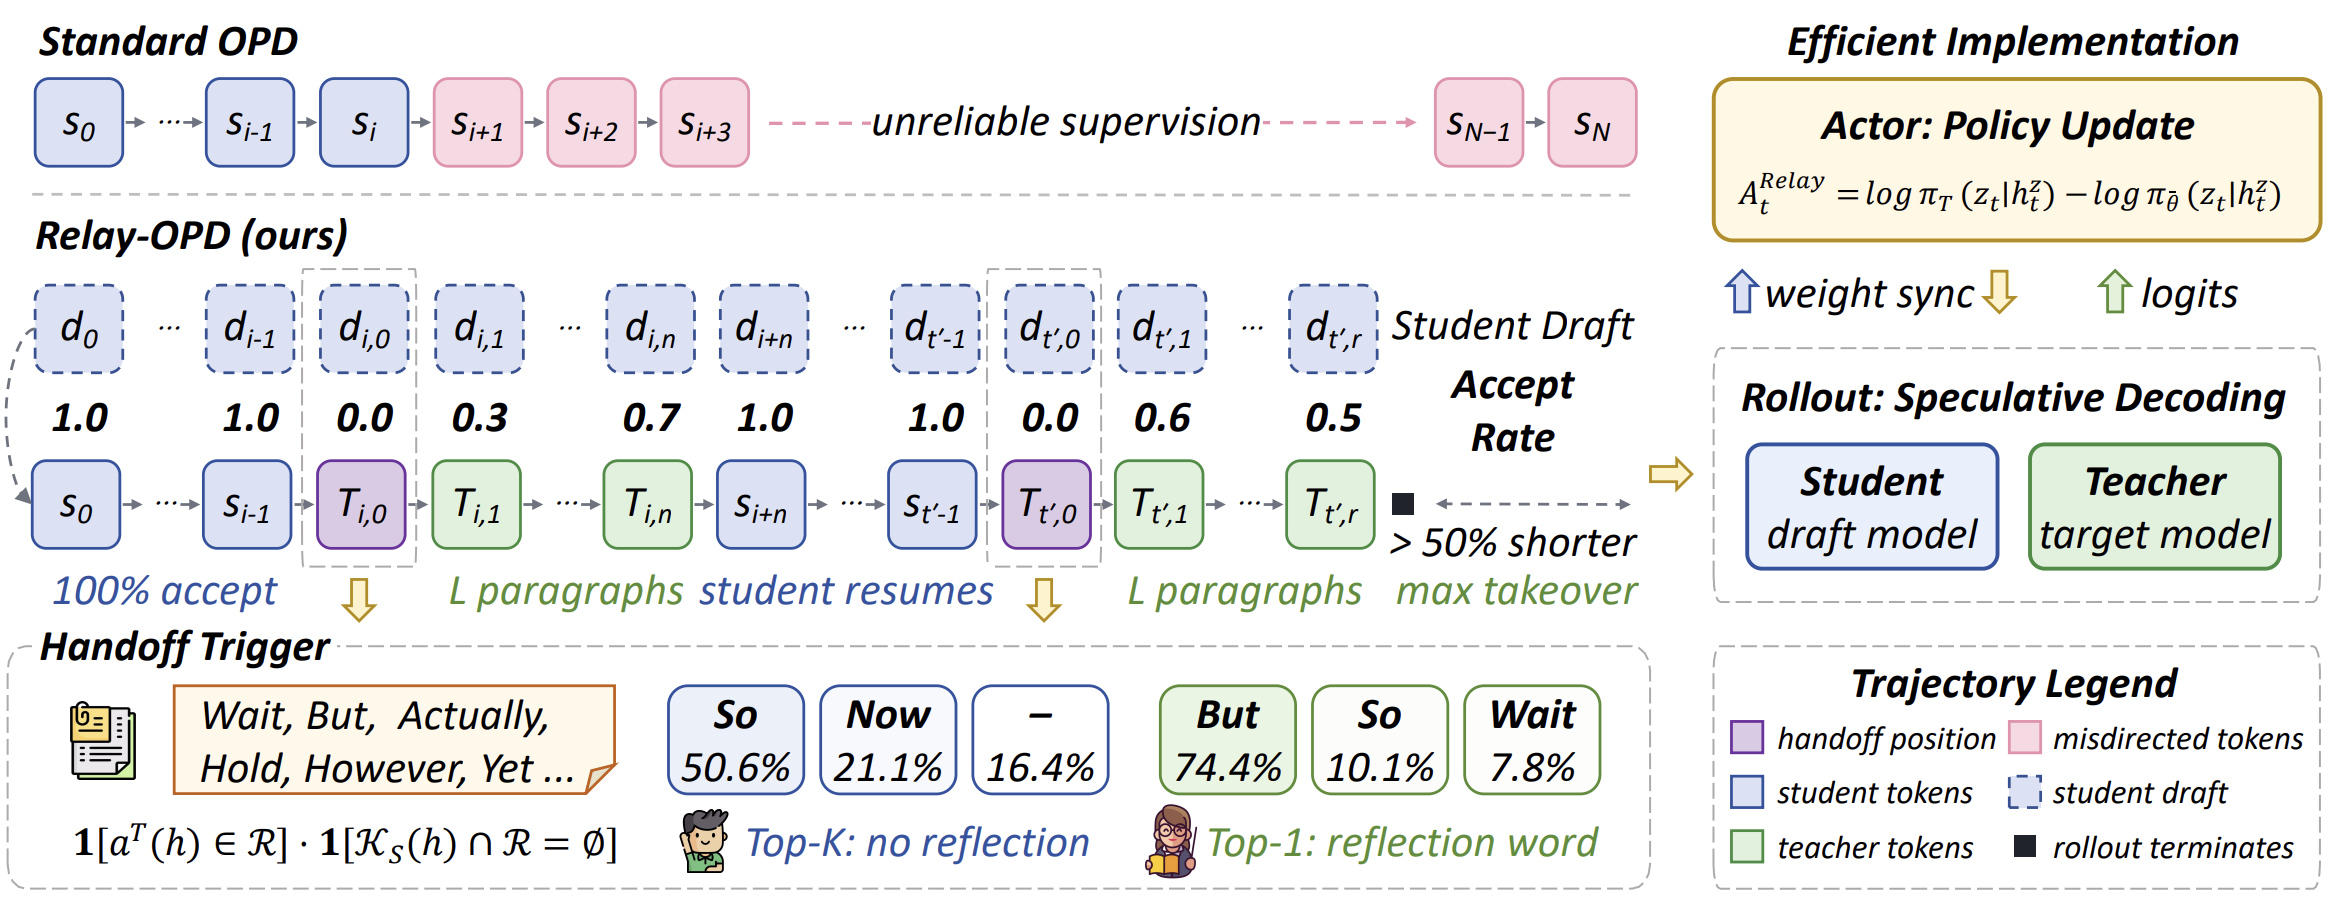
출처: Pass the Baton: Trajectory-Relayed On-Policy Distillation (Xu et al., 2026)
위 그림의 위쪽 Standard OPD를 보면 학생 모델이 한번 잘못된 방향으로 들어간 뒤에도 Trajectory를 끝까지 직접 생성합니다. 반면 가운데 Relay-OPD에서는 학생 모델이 생성하는 도중 Handoff Trigger가 발견되면 잠시 교사 모델에게 생성을 넘깁니다.
논문의 Handoff Trigger는 단순히 교사 모델과 학생 모델의 확률 분포가 다르다는 이유로 발생하지 않습니다. 쉽게 말하면 교사 모델은 Wait, But, However처럼 기존 추론을 되돌아보는 토큰을 선호하지만, 학생 모델은 그런 방향 전환 없이 그대로 생성을 이어가려는 지점을 개입 시점으로 활용합니다.
Trigger가 발생하면 교사 모델이 짧은 Teacher Leg를 생성해 추론 방향을 돌리고, 이후에는 다시 학생 모델이 이어서 생성합니다. 중요한 점은 교사 모델이 전체 풀이를 대신 생성하지 않는다는 것입니다. Relay-OPD는 필요한 순간에만 짧게 교사 모델을 개입시키고, 다시 학생 모델에게 생성을 돌려줍니다. 이를 통해 학생 모델 자신의 응답에서 학습한다는 OPD의 특성을 최대한 유지하면서 Prefix Failure가 길게 이어지는 것을 줄이고자 합니다.
논문의 사전 실험에서도 교사 모델의 개입을 길게 늘릴수록 성능이 계속 증가하지는 않았으며, 이러한 관찰을 바탕으로 Relay-OPD는 Teacher가 초기에, 짧게 개입하도록 설계되었습니다.
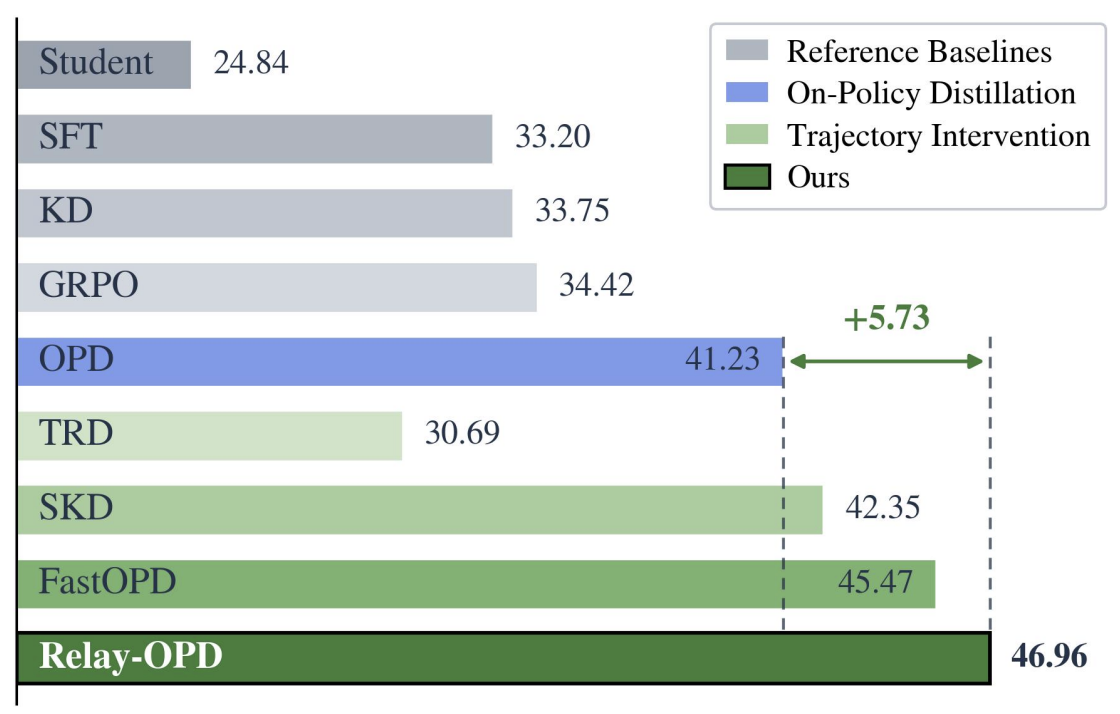
출처: Pass the Baton: Trajectory-Relayed On-Policy Distillation (Xu et al., 2026)
실험 결과에서도 Relay-OPD는 Standard OPD보다 높은 성능을 보였습니다. Qwen3-4B-Instruct-2507을 교사 모델로, Qwen3-1.7B Non-Thinking을 학생 모델로 사용한 실험에서 8개 수학 추론 benchmark 평균에서 Standard OPD보다 5.73%p 높은 성능을 기록했고, 학습 Trajectory의 평균 길이도 50% 이상 감소했습니다.
결국 Relay-OPD가 던지는 질문은 단순합니다. OPD에서는 학생 모델이 실제로 방문하는 Trajectory에서 학습하는 것이 중요하지만, 그 Trajectory를 언제까지 학생 모델에게 그대로 맡길 것인가도 함께 고려해야 한다는 것입니다.
잘 가르친다는 것은 무엇일까?
기존 지식 증류가 “무엇을 가르칠 것인가”에 가까웠다면, OPD는 학생 모델이 실제로 어떤 상태에 있는지를 학습에 반영하기 시작했습니다. 그리고 Relay-OPD는 여기서 더 나아가 언제 교사 모델이 개입할 것인지까지 고민합니다.
좋은 교사 모델이 있다는 것만큼이나, 학생 모델이 지금 어떤 상태에 있는지를 파악하고 필요한 순간에 적절한 학습 신호를 주는 것이 중요해지고 있는 셈입니다.